Xếp lớp và hàm phi tuyến: vì sao một lớp không đủ
Chồng nhiều lớp tuyến tính vẫn thu gọn được về đúng một lớp, không mạnh thêm. Hàm phi tuyến giữa các lớp mới là thứ mở ra ranh giới cong.
TL;DR: Nhiều người nghĩ "nhiều lớp thì model mạnh hơn". Điều đó đúng, nhưng chỉ khi giữa các lớp có hàm phi tuyến. Nếu lớp nào cũng là phép biến đổi tuyến tính (chỉ nhân rồi cộng), cả chuỗi thu gọn được về đúng một phép biến đổi tuyến tính, chồng bao nhiêu lớp cũng vậy. Hàm phi tuyến như ReLU chặn được việc thu gọn đó, cho mạng học ra ranh giới quyết định cong thay vì chỉ đường thẳng. Đó là lý do nền tảng khiến mạng nơ-ron nhiều lớp làm được việc.
Một neuron tính tổng có trọng số của đầu vào cộng bias, rồi đưa qua hàm kích hoạt. Thứ duy nhất model thay đổi khi huấn luyện là các trọng số; kiến trúc và hàm kích hoạt được cố định từ trước.
1. Thêm lớp thì model có tự động mạnh hơn không?
Lần đầu nghe về mạng nơ-ron nhiều lớp, trực giác tự nhiên là nhiều lớp hơn thì mạnh hơn, giống nhiều nhân viên thì xử lý được nhiều việc hơn.
Trực giác đó thiếu một chi tiết. Nếu lớp nào cũng làm cùng một loại phép tính (biến đổi tuyến tính: nhân rồi cộng), cả chuỗi lớp chỉ làm được đúng điều một lớp làm được. Chi tiết còn thiếu là hàm phi tuyến, và nó là lý do cốt lõi khiến mạng nhiều lớp có ích.
Bài này chỉ nói về hình dạng kiến trúc: vì sao cần phi tuyến và MLP trông thế nào. Mạng học chỉnh trọng số ra sao là chuyện của bài 03–04.
2. Vì sao hai lớp tuyến tính gộp được thành một?
2.1 Analogy: hai bộ lọc ảnh chồng lên nhau
Bạn chỉnh ảnh qua hai bước: bước 1 nhân mỗi pixel với 1.5 (tăng sáng), bước 2 nhân kết quả với 0.8 (giảm sáng). Kết quả giống hệt nhân mỗi pixel một lần với 1.5 × 0.8 = 1.2. Hai bước cùng loại (nhân hằng số) gộp thành một, bỏ bước trung gian cũng chẳng mất gì.
Nhưng chèn vào giữa một phép cắt ngưỡng, ví dụ ép mọi pixel tối hơn 80 về 0, thì ba bước không gộp được nữa. Phép cắt ngưỡng là một loại thao tác khác, nó cắt đứt chuỗi.
| Bộ lọc ảnh | Trong mạng nơ-ron |
|---|---|
| Nhân pixel với hằng số | Lớp tuyến tính |
| Nhân nhiều lần = nhân một lần | Nhiều lớp tuyến tính = một lớp |
| Phép cắt ngưỡng chen giữa | Hàm phi tuyến |
| Hiệu ứng tổng hợp không gộp được | Ranh giới quyết định cong |
2.2 Bắt đầu từ số học lớp 6
Giả sử đầu vào x = 4. Lớp 1 nhân x với 3, được 12. Lớp 2 nhân kết quả với 2, được 24.
Bạn có làm được cả hai bước đó bằng một phép nhân duy nhất không? Nếu được, phải nhân x với số nào?
Câu trả lời: nhân x với 3 × 2 = 6 là ra đúng 24. Hai bước nhân liên tiếp gộp hoàn toàn thành một bước: không mất thông tin nào, nhưng cũng không sinh thêm chút sức mạnh tính toán nào.
2.3 Lớp tuyến tính trong neural net
Mỗi lớp tuyến tính nhân đầu vào với trọng số rồi cộng bias. Hai lớp liên tiếp, không có phi tuyến ở giữa:
Lớp 1: z1 = w1 * x + b1

Lớp 2: z2 = w2 * z1 + b2
          = w2 * (w1 * x + b1) + b2      // thế z1 vào
          = (w2 * w1) * x + (w2 * b1 + b2)  // phân phối
          = W * x + B                    // một phép biến đổi tuyến tính duy nhất
W = w2 × w1 và B = w2 × b1 + b2 đều là hằng số. Hai lớp tương đương một lớp tuyến tính với trọng số W và bias B.
Lập luận này lặp lại được cho ba, bốn hay một trăm lớp tuyến tính liên tiếp: kết quả cuối luôn là W_tong * x + B_tong với hai hằng số nào đó. N lớp thu gọn về đúng một lớp, không thêm được năng lực biểu diễn nào.
Xếp chồng nhiều lớp fully-connected trong code mà không đặt hàm kích hoạt giữa chúng thì về mặt tính toán bạn vẫn chỉ có một lớp tuyến tính, dù code trông "sâu".
3. Hàm phi tuyến: chỗ bẻ gãy đường thẳng
Hàm phi tuyến (hàm kích hoạt) là hàm chèn giữa các lớp để chặn việc thu gọn đó.
Hàm phổ biến nhất hiện nay là ReLU (Rectified Linear Unit): giữ nguyên mọi giá trị dương, ép mọi giá trị âm về 0.
ReLU(x) = x    nếu x > 0
ReLU(x) = 0    nếu x <= 0
Áp ReLU vào giữa hai lớp tuyến tính:
z1 = w1 * x + b1         // lớp tuyến tính 1
h1 = ReLU(z1)            // phi tuyến, KHÔNG gộp được với bước trước
z2 = w2 * h1 + b2        // lớp tuyến tính 2
ReLU(z1) không phải phép nhân hay cộng. Nó bẻ gãy đường thẳng tại điểm 0, giữ phần dương, cắt bỏ phần âm. Sau bước đó, h1 không còn là hàm tuyến tính của x, nên z2 = w2 * h1 + b2 không gộp được với lớp trước thành một phép tuyến tính.
Ngoài ReLU còn hai hàm hay gặp. Sigmoid nén đầu ra về khoảng (0, 1), hay dùng ở lớp ra cho phân loại nhị phân. Tanh nén về (-1, 1), hay xuất hiện trong RNN và LSTM. Chúng đều phi tuyến và chặn việc thu gọn theo cùng nguyên lý; nắm ReLU là đủ hiểu cơ chế.
4. Ranh giới thẳng hay cong: vì sao phải phân biệt?
Hàm XOR (exclusive OR) là ví dụ kinh điển: trả về 1 khi đúng một trong hai đầu vào bằng 1, và 0 trong các trường hợp còn lại. Vẽ bốn điểm đầu vào lên mặt phẳng, hai điểm nhãn 0 nằm ở một cặp góc chéo, hai điểm nhãn 1 ở cặp góc chéo kia, và không đường thẳng nào tách được hai nhóm. Minsky và Papert chứng minh giới hạn này cho perceptron một lớp năm 1969.
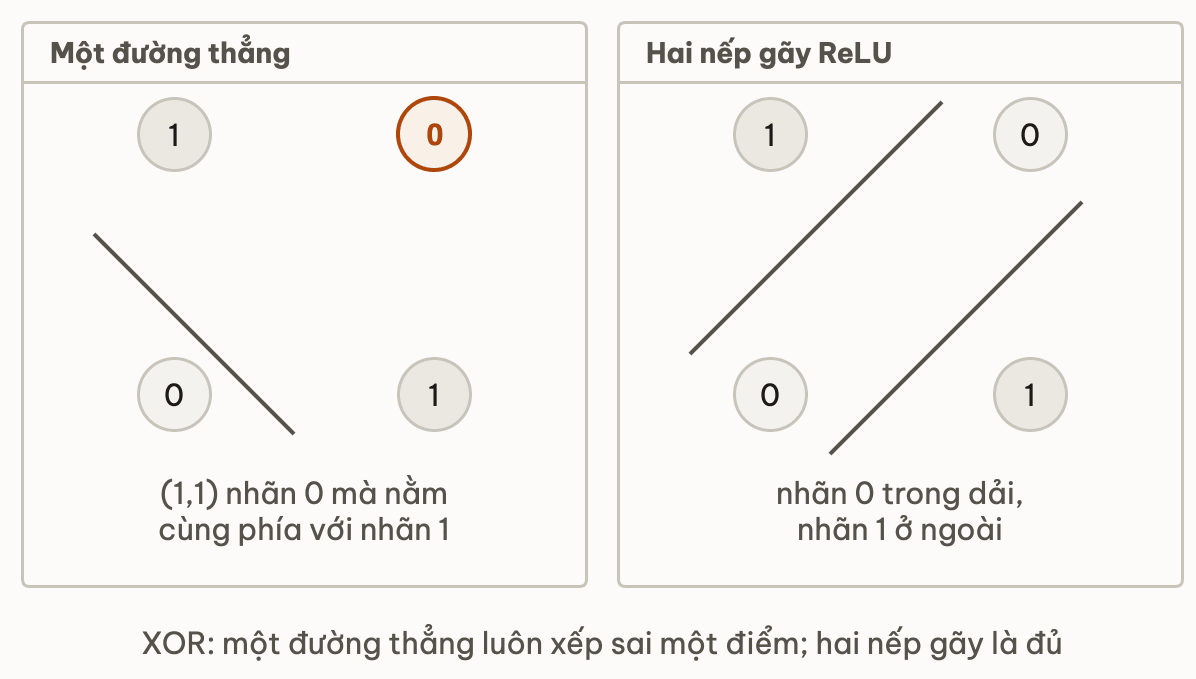
Mỗi neuron ReLU ở lớp ẩn góp một "nếp gãy" vào ranh giới. Hai nếp là đủ tạo ra dải chéo bao hai điểm nhãn 0, và một MLP có hai neuron ẩn với ReLU giải được XOR. Bài toán thật cũng hay có đặc điểm này: gian lận thường nằm ở một tổ hợp số tiền và tần suất, không ở một ngưỡng đơn.
| Loại bài toán | Ví dụ | Lớp tuyến tính | MLP có phi tuyến |
|---|---|---|---|
| Tách được bằng đường thẳng | Phân loại theo một ngưỡng đơn | Làm được | Làm được |
| Không tách được bằng đường thẳng | XOR, vùng giao dịch phức hợp | Không làm được | Làm được |
Càng nhiều neuron ẩn thì càng nhiều nếp gãy, và ranh giới đi từ một đường thẳng tới đường gấp khúc, rồi tới bề mặt phức tạp tuỳ ý khi sức chứa đủ lớn.
5. Mạng nơ-ron nhiều lớp (MLP) trông thế nào?
MLP (Multi-Layer Perceptron) là kiến trúc căn bản nhất có phi tuyến: các lớp xếp nối tiếp, giữa mỗi cặp lớp là hàm kích hoạt.
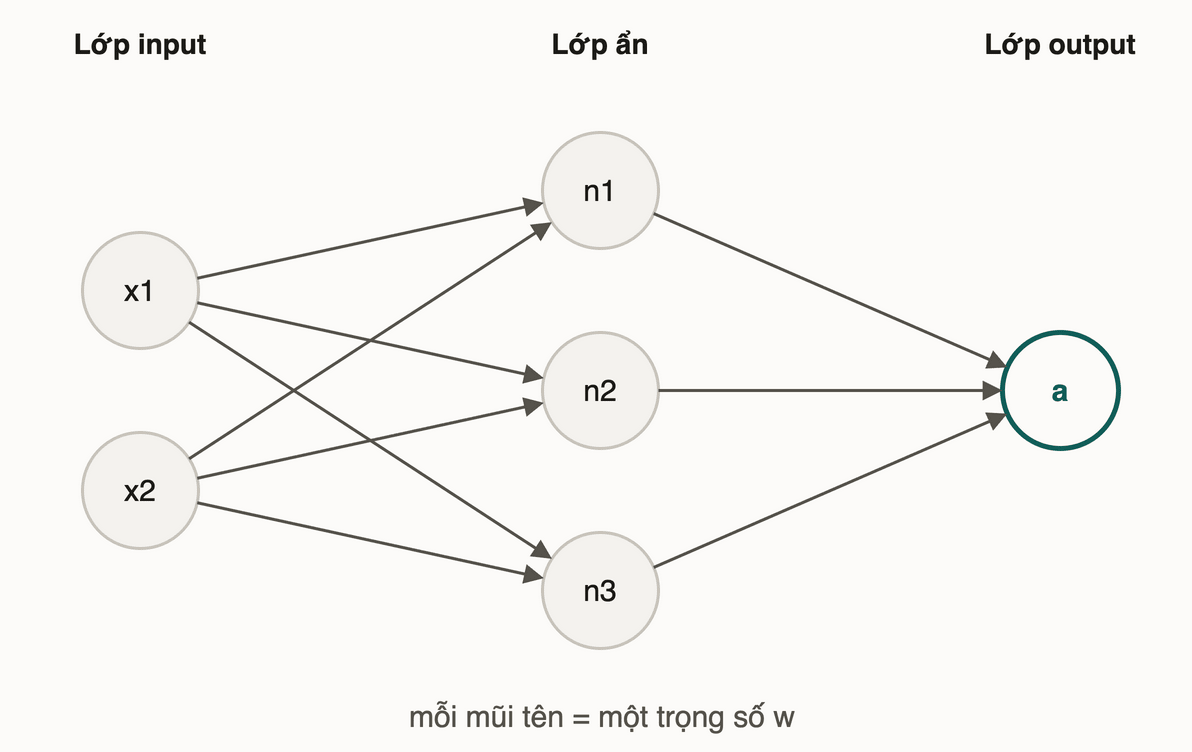
Lớp ẩn (hidden layer) là những lớp nằm giữa lớp vào và lớp ra, nơi mạng học ra các representation trung gian. Bài 06 đi sâu vào những representation đó.
Thử ngẫmmột bản vẽ ghi "toà nhà 3 tầng" nhưng không nói mỗi tầng rộng bao nhiêu mét vuông. Chỉ con số "3 tầng" có đủ để biết toà nhà lớn cỡ nào không?
6. Sức chứa: nhiều hơn không phải lúc nào cũng tốt hơn
Sức chứa (capacity) là khả năng mạng biểu diễn được các hàm phức tạp. Hai thứ chỉnh sức chứa: số lớp ẩn (mỗi lớp thêm vào cho phép học representation trừu tượng hơn) và số neuron mỗi lớp (nhiều neuron hơn thì mỗi lớp có nhiều nếp gãy hơn).
Tăng sức chứa là đánh đổi hai chiều. Mạng quá nhỏ thiếu sức chứa (underfitting): không đủ biểu diễn pattern, kết quả kém trên cả tập train lẫn tập test. Mạng quá lớn so với dữ liệu thì dễ overfit: học thuộc cả nhiễu, tốt trên train nhưng kém trên test. Module 1 đã nói về overfitting; bài 07 cho bạn nhận ra cả hai dấu hiệu từ đường cong loss.
Nói "mạng 3 lớp" không cho biết model lớn cỡ nào. Với cùng đầu vào, một lớp ẩn 1000 neuron có thể nhiều tham số hơn năm lớp ẩn mỗi lớp 10 neuron. Bài 05 đếm tham số chính xác từ kiến trúc.
7. Đào sâu
- Minsky, M. & Papert, S. (1969). Perceptrons: An Introduction to Computational Geometry. MIT Press. Chứng minh perceptron một lớp không giải được các hàm không tách tuyến tính, điển hình là XOR. Cuốn sách góp phần đẩy nghiên cứu mạng nơ-ron vào "mùa đông AI" thập niên 1970, và thúc người ta tìm lời giải bằng nhiều lớp kèm phi tuyến. (Sách in, không có bản mở công khai.)
- Cybenko, G. (1989). Approximation by superpositions of a sigmoidal function. Mathematics of Control, Signals, and Systems, 2(4), 303–314. DOI:
10.1007/BF02551274. Định lý xấp xỉ phổ quát (universal approximation theorem): một mạng một lớp ẩn đủ rộng với sigmoid xấp xỉ được mọi hàm liên tục tới độ chính xác tuỳ ý. Nó bảo đảm MLP đủ mạnh về lý thuyết, nhưng không nói gì về cách học ra bộ trọng số đó.
8. Liên hệ các bài khác
- Bài 01: Neuron và trọng số: "lớp tuyến tính" ở bài này chính là một hàng neuron của bài 01, và hàm kích hoạt nhắc ở đó là hàm phi tuyến bài này giải thích.
- Bài 03: Loss: biết mạng có hình dạng gì rồi, bài 03 đo mạng sai bao nhiêu.
- Bài 05: Tham số và siêu tham số: đếm tham số chính xác từ kiến trúc MLP, nối tiếp pitfall ở mục 6.
- Bài 07: Mini-challenge: đọc đường cong loss: dùng khái niệm "thiếu sức chứa" để chẩn đoán một trong ba ca.
9. Tóm tắt
x × 3 × 2bằngx × 6: nhân nối tiếp gộp được, và cả N lớp tuyến tính cũng thế.- ReLU bẻ gãy đường thẳng tại 0, nên lớp sau không gộp được với lớp trước.
- XOR cần hai nếp gãy; một đường thẳng luôn xếp sai ít nhất một điểm.
- Sức chứa tăng theo số lớp ẩn và số neuron, kéo theo nhu cầu dữ liệu và rủi ro overfit.
10. Tự kiểm tra
- Q1Xếp ba lớp tuyến tính liên tiếp, không có phi tuyến nào giữa chúng. Mạng đó có mạnh hơn một lớp tuyến tính không? Vì sao?
- Q2ReLU làm gì với đầu vào? Vì sao nó là phi tuyến chứ không phải tuyến tính?
- Q3Vì sao hàm XOR không giải được bằng một lớp tuyến tính, và vì sao hai neuron ReLU lại đủ?
- Q4Điều gì xảy ra nếu một mạng thiếu sức chứa so với độ phức tạp của bài toán?
- Q5Với 2 đầu vào và 1 đầu ra, mạng hai lớp ẩn mỗi lớp 10 neuron và mạng một lớp ẩn 100 neuron: mạng nào nhiều tham số hơn?
Bài tiếp theo: Loss: gom cái sai của model về một con số
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Neuron nhân tạo: trọng số mới là thứ model học được
Bài tiếpLoss: gom cái sai của model về một con số duy nhất
Thảo luận & góp ý
Hỏi đáp về bài này