Mini-challenge: chẩn đoán ba đường cong huấn luyện hỏng
Ba ca huấn luyện thất bại, mỗi ca một đường cong loss kèm cấu hình. Tự chẩn đoán nguyên nhân và đề xuất cách sửa trước khi đọc lời giải.
TL;DR: Ba ca huấn luyện trong một dự án fintech nội bộ, mỗi ca có cấu hình mạng cụ thể và bảng loss theo epoch. Nhiệm vụ của bạn: đọc hai đường train và validation của từng ca, viết chẩn đoán và đề xuất siêu tham số cần sửa, trước khi mở lời giải. Kỹ năng cần luyện là đọc hình dạng đường cong ra nguyên nhân, dựa vào ba thứ: xu hướng tổng thể, mức loss khi đã ổn định, và khoảng cách giữa hai đường. Bảng triệu chứng, nguyên nhân, cách sửa ở phần Mở rộng là thứ đáng bookmark cho những lần debug sau.
Nhiều lớp tuyến tính chỉ tương đương một lớp; chính hàm phi tuyến (ReLU, sigmoid) tạo ra sức mạnh khi chồng lớp. Sức chứa của mạng tăng theo số lớp và số neuron, và mạng quá nhỏ chỉ vẽ được ranh giới đơn giản cho một bài toán phức tạp.
Vòng lặp huấn luyện: forward, tính loss, tính gradient, cập nhật trọng số. Learning rate là độ dài mỗi bước cập nhật: quá lớn thì lố qua đáy, quá nhỏ thì hội tụ rất chậm. Đường cong loss khoẻ giảm đều rồi phẳng dần.
Overfitting: model học thuộc tập train nhưng không tổng quát ra dữ liệu mới. Dấu hiệu kinh điển: train loss tiếp tục giảm trong khi validation loss chạm đáy rồi bắt đầu tăng. Validation set là thước đo khả năng tổng quát mà bạn có trong tay lúc train.
🎯 Đề bài
Ba ca huấn luyện xảy ra trong môi trường dev/UAT nội bộ của một ngân hàng. Mỗi ca có bối cảnh, cấu hình mạng và bảng loss theo epoch.
Ca A: loss dao động loạn, không có xu hướng
Bối cảnh: đội tín dụng đang UAT một model phân loại nhị phân dự đoán khả năng trả nợ. Đầu vào gồm 50 feature số từ lịch sử giao dịch. Tập huấn luyện 8.000 mẫu; tập validation 2.000 mẫu.
Cấu hình:
| Siêu tham số | Giá trị |
|---|---|
| Kiến trúc | 3 lớp ẩn: 128, 64, 32 neuron, activation ReLU |
| Learning rate | 0.1 |
| Batch size | 64 |
| Số epoch | 30 |
| Optimizer | SGD thuần (không momentum) |
Loss theo epoch:
| Epoch | Train Loss | Val Loss |
|---|---|---|
| 1 | 1.42 | 1.38 |
| 2 | 0.95 | 0.92 |
| 3 | 1.87 | 1.91 |
| 4 | 1.23 | 1.19 |
| 5 | 2.13 | 2.24 |
| 6 | 0.78 | 0.82 |
| 7 | 1.51 | 1.56 |
| 8 | 0.83 | 0.86 |
| 9 | 1.98 | 2.01 |
| 10 | 1.45 | 1.52 |
| 15 | 0.88 | 0.90 |
| 20 | 1.97 | 2.04 |
| 25 | 0.67 | 0.71 |
| 30 | 1.23 | 1.30 |
Ca B: loss phẳng ở mức cao từ sớm
Bối cảnh: cùng bài toán tín dụng như ca A (8.000 mẫu train, 2.000 mẫu validation, 50 feature), nhưng đội infra đề xuất model nhỏ hơn để giảm latency của API nội bộ.
Cấu hình:
| Siêu tham số | Giá trị |
|---|---|
| Kiến trúc | 1 lớp ẩn, 8 neuron, activation ReLU |
| Learning rate | 0.001 |
| Batch size | 64 |
| Số epoch | 50 |
| Optimizer | Adam |
Loss theo epoch:
| Epoch | Train Loss | Val Loss |
|---|---|---|
| 1 | 1.64 | 1.67 |
| 5 | 0.91 | 0.93 |
| 10 | 0.74 | 0.76 |
| 20 | 0.68 | 0.70 |
| 30 | 0.67 | 0.69 |
| 40 | 0.67 | 0.68 |
| 50 | 0.67 | 0.68 |
Ca C: train đẹp nhưng validation đi ngược chiều
Bối cảnh: đội phòng chống gian lận UAT một model phân loại giao dịch bất thường. Dữ liệu nội bộ hạn chế: chỉ 100 mẫu huấn luyện và 50 mẫu validation đã gán nhãn.
Cấu hình:
| Siêu tham số | Giá trị |
|---|---|
| Kiến trúc | 4 lớp ẩn: 256, 128, 64, 32 neuron, activation ReLU |
| Learning rate | 0.001 |
| Batch size | 32 |
| Số epoch | 60 |
| Optimizer | Adam |
Loss theo epoch:
| Epoch | Train Loss | Val Loss |
|---|---|---|
| 1 | 1.73 | 1.71 |
| 5 | 0.94 | 0.97 |
| 10 | 0.62 | 0.67 |
| 20 | 0.38 | 0.53 |
| 30 | 0.22 | 0.71 |
| 40 | 0.14 | 0.89 |
| 50 | 0.09 | 1.12 |
| 60 | 0.06 | 1.31 |
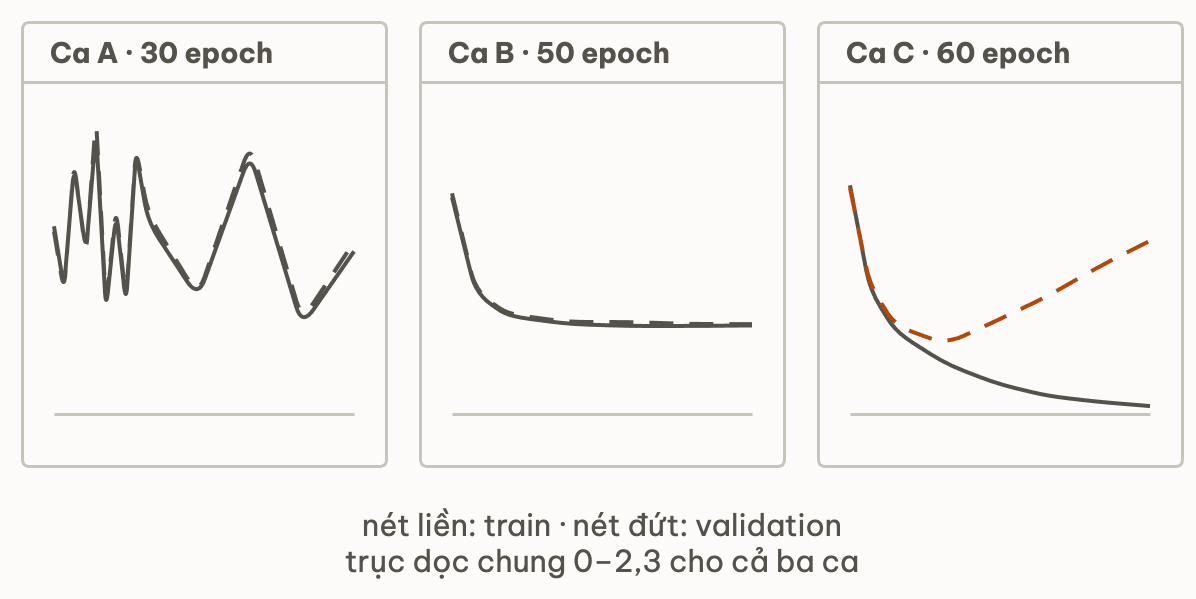
Ba bảng trên, vẽ thành đường cong cùng một trục dọc:
✍️ Phần việc của bạn
Với mỗi ca, trả lời ba câu trước khi kéo xuống lời giải:
- Nguyên nhân: hình dạng đường loss cho thấy vấn đề gì?
- Siêu tham số: bạn đổi gì để sửa?
- Dấu hiệu phân biệt: triệu chứng này khác hai ca còn lại ở điểm nào?
💡 Gợi ý
- Xu hướng tổng thể: đường train loss có giảm đều từ epoch đầu tới epoch cuối không, hay dao động qua lại?
- Mức khi ổn định: lúc loss không còn đổi nhiều, nó đang ở mức cao hay thấp, và chạy thêm epoch có giúp gì không?
- Hình dạng và khoảng cách: hai đường train/validation đi cùng chiều hay ngược chiều, và khoảng cách giữa chúng thay đổi thế nào theo thời gian?
✅ Lời giải
Ca A: learning rate quá lớn
Phân tích: không có xu hướng giảm ổn định; loss nhảy trong khoảng 0.67 tới 2.24 suốt 30 epoch mà không hội tụ. Đây là triệu chứng điển hình của learning rate quá lớn: mỗi bước nhảy xa hơn bề rộng vùng đáy, trọng số lố qua đáy rồi bị kéo ngược lại. Train và validation dao động cùng nhịp, khoảng cách nhỏ: model chưa ổn định đủ lâu để học thuộc tập train (khác hẳn ca C, nơi hai đường tách xa và đi ngược chiều).
Cách sửa: giảm learning rate ít nhất 10 lần (0.1 xuống 0.01); còn dao động thì thử 0.001. Một phương án khác là dùng Adam thay SGD thuần: Adam tự điều chỉnh độ dài bước cho từng tham số nên ít nhạy với learning rate hơn. Sửa đúng thì loss giảm đều trong 3 tới 5 epoch đầu, không còn những cú tăng đột ngột.
Bẫy chẩn đoán nhầm: dữ liệu nhiễu cũng làm loss dao động, nhưng xu hướng tổng thể vẫn đi xuống qua các epoch. Ca A không có xu hướng giảm nào trong 30 epoch, đó là dấu hiệu tách bạch. Kiểm thêm: giảm learning rate đi một nửa; dao động thu hẹp ngay trong 5 epoch đầu thì đúng là learning rate, không đổi gì thì mới tính tới dữ liệu hay bug pipeline.
Ca B: model thiếu sức chứa (underfit)
Phân tích: train loss giảm từ 1.64 xuống 0.68 trong 20 epoch đầu, tức model có học. Nhưng từ epoch 20, cả hai đường phẳng lì: train 0.67–0.68, validation 0.68–0.70, dù train thêm 30 epoch. Khoảng cách giữa hai đường chỉ 0.01–0.02. Nếu hai lớp trả nợ/không trả nợ xấp xỉ cân bằng, cross-entropy của việc đoán bừa là ln 2 ≈ 0.693, tức model gần như không khá hơn tung đồng xu. Mạng 1 lớp ẩn 8 neuron không đủ biểu diễn các quan hệ phi tuyến trong 50 feature tín dụng. Mấu chốt: train loss cao, model không khớp nổi cả dữ liệu nó đã thấy nhiều lần.
Cách sửa: tăng sức chứa, ví dụ thay 1 lớp 8 neuron bằng 3 lớp (128, 64, 32 neuron), giữ learning rate 0.001. Sau đó theo dõi validation: giảm theo train là model đang học tốt; bắt đầu tăng là đã sang vùng overfit.
Bẫy chẩn đoán nhầm: nhầm phổ biến nhất là "cần thêm dữ liệu". Cách phân biệt: train loss cũng cao và phẳng dù model đã thấy 8.000 mẫu hàng chục lần, nghĩa là model không đủ sức học; thêm dữ liệu chỉ thêm bài tập mà model vốn không làm nổi. Nhầm thứ hai: learning rate nhỏ cũng làm loss giảm chậm, nhưng vẫn giảm đều; ca B phẳng hẳn từ epoch 20 và thêm epoch không giúp gì.
Ca C: overfit
Phân tích: train loss giảm đều và mượt từ 1.73 xuống 0.06 qua 60 epoch. Validation loss giảm lúc đầu, chạm đáy 0.53 ở epoch 20, rồi tăng dần tới 1.31 ở epoch 60; khoảng cách lúc cuối là 1.25. Mạng 4 lớp này có hàng chục nghìn tham số (khoảng 56.000 nếu đầu vào cũng là 50 feature như hai ca trước) mà chỉ có 100 mẫu, nên từ khoảng epoch 20 model bắt đầu học thuộc đặc điểm riêng của từng mẫu train, kể cả nhiễu. Điểm dừng tốt nhất: quanh epoch 20, lúc validation loss thấp nhất trước khi đi lên.
Cách sửa: ba hướng, thường kết hợp. (1) Giảm sức chứa: thử 2 lớp (64, 32 neuron). (2) Thêm regularization: dropout 20–30% hoặc L2 weight decay; cả hai làm train loss tăng nhẹ nhưng thu hẹp khoảng cách train/validation. (3) Early stopping: dừng khi validation loss tăng liên tiếp 5 epoch. Về lâu dài: gán nhãn thêm dữ liệu.
Bẫy chẩn đoán nhầm: "Train loss đang giảm, chạy thêm 100 epoch nữa thì validation sẽ tốt lên." Sai: validation đã đi lên từ epoch 20, chạy thêm chỉ đẩy train xuống thêm và validation lên thêm. Nhầm khác: learning rate nhỏ làm cả hai đường giảm đều nhau, khoảng cách nhỏ và ổn định; ca C có hai đường tách xa theo hai hướng ngược nhau.
🎓 Mở rộng
| Hình dạng hai đường loss | Khoảng cách train / val | Nguyên nhân | Cách sửa |
|---|---|---|---|
| Dao động loạn giữa các epoch, không có xu hướng giảm | Nhỏ, hai đường cùng nhịp | Learning rate quá lớn | Giảm lr 10 lần; dùng Adam; thêm scheduler |
| Giảm nhanh rồi phẳng ở mức cao, thêm epoch không giúp | Rất nhỏ, hai đường gần trùng | Model thiếu sức chứa (underfit) | Tăng số lớp hoặc số neuron |
| Train giảm đều, val chạm đáy rồi tăng dần | Lớn và ngày càng doãng | Overfit: model quá lớn so với dữ liệu | Giảm sức chứa, dropout, L2, early stopping |
Ngoài đời, một đường cong có thể mang dấu hiệu của nhiều bệnh cùng lúc: learning rate hơi lớn cộng model hơi overfit cho ra đường vừa dao động vừa tách xa. Chẩn đoán đúng thì đổi từng biến một: giảm learning rate trước, quan sát 10 epoch, rồi mới xét sức chứa và regularization.
Thử ngẫmmột ca mới có train loss giảm đều nhưng validation loss đứng yên suốt 15 epoch, không tăng cũng không giảm. Tra bảng trên, ca đó gần với hàng nào nhất?
✨ Điều bạn vừa làm được
Bạn vừa dùng đường cong loss như một công cụ chẩn đoán: không chờ kết quả cuối mà đoán ra bệnh ngay trong lúc train. Kỹ năng này áp thẳng vào mọi lần bạn chạy model: log loss theo epoch (bằng TensorBoard hay chỉ một dòng print), nhìn hình dạng, và biết bước tiếp theo phải làm gì.
Liên hệ các bài khác
- Xếp lớp và phi tuyến: sức chứa (số lớp, số neuron) là nguyên nhân trực tiếp của ca B.
- Gradient descent: vòng lặp huấn luyện và vai trò của learning rate là nền để đọc ca A.
- Overfitting và data leakage: bài đó đi sâu cơ chế overfit và vai trò của validation set; ca C là hình ảnh trực quan của điều bài đó cảnh báo.
- Tổng kết module: cheat sheet và self-assessment cho cả module.
Bài tiếp theo: Tổng kết: Não nhân tạo vừa đủ
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Representation: lớp ẩn tự học ra đặc trưng của dữ liệu
Bài tiếpTổng kết Não nhân tạo vừa đủ: cheat sheet và tự đánh giá
Thảo luận & góp ý
Hỏi đáp về bài này