Neuron nhân tạo: trọng số mới là thứ model học được
Một neuron chỉ làm hai việc: tính tổng có trọng số rồi cho qua hàm kích hoạt. Thứ duy nhất huấn luyện thay đổi là bộ trọng số đó, không phải mã nguồn.
TL;DR: Một neuron nhân tạo là một hàm tính toán đơn giản: nhân mỗi đầu vào với một trọng số, cộng tất cả lại kèm một hằng số bias, rồi đưa kết quả qua một hàm kích hoạt để ra đầu ra. Mọi thứ người ta gọi là "train model", "fine-tune", "học từ dữ liệu" thực chất là chỉnh lại các con số trọng số và bias đó. Công thức tính, mã nguồn, kiến trúc mạng thì đứng yên. Đó là câu trả lời cụ thể nhất cho câu hỏi "học từ dữ liệu nghĩa là gì".
Module 1, bài 01: nếu luật viết tay được và đứng yên, dùng if-else, nhanh và kiểm soát được. Nếu luật quá nhiều, quá mờ, hoặc trôi theo thời gian, bạn cần machine learning. Bài này trả lời câu hỏi tiếp theo: ở mức một neuron, "học" cụ thể là gì?
1. Một neuron nhân tạo làm gì?
Hằng ngày bạn đọc những cụm như "train lại model", "model 7 tỷ tham số", "fine-tune trên dataset mới". Nhưng hỏi kỹ hơn, ở mức nhỏ nhất thì "học" nghĩa là gì, câu trả lời hay dừng ở "model tự hiểu dữ liệu" nghe khá thần bí.
Bài này mở hộp đen ở đơn vị nhỏ nhất: một neuron. Nó chỉ làm đúng hai việc:
- Tính một tổng có trọng số: nhân từng đầu vào với một hệ số rồi cộng lại, kèm một hằng số.
- Cho tổng đó qua một hàm: để bẻ cong hoặc nén kết quả về một khoảng nhất định.
Nghe đơn giản tới mức khó tin. Thế nhưng khối tính toán nhiều nhất trong GPT, Gemini hay Claude chính là hàng tỷ phép "nhân trọng số rồi cộng" kiểu này, xếp lớp chồng lên nhau.
2. Neuron như một hàm chấm điểm có núm vặn: ví dụ chấm hồ sơ vay
Bắt đầu từ một bài toán quen với backend dev: chấm sơ bộ hồ sơ vay vốn ngân hàng. Có ba chỉ số đầu vào:
x1: thu nhập hằng tháng (triệu VND)x2: số năm làm việc ở công ty hiện tạix3: số khoản vay đang còn nợ
| Chấm hồ sơ vay | Neuron |
|---|---|
| Thu nhập, số năm làm, số khoản nợ | Đầu vào x1, x2, x3 |
| Mức quan trọng của từng tiêu chí | Trọng số w1, w2, w3 |
| Ngưỡng cơ sở nới hoặc siết chung | Bias b |
| Điểm tổng trước khi qua hàm kích hoạt | z |
| Quyết định cuối (duyệt / từ chối) | Đầu ra a = f(z) |
Cách truyền thống là viết rule-based: if thu_nhap > 10 && so_no < 2 → duyệt. Còn nếu muốn dữ liệu lịch sử tự tìm ra các ngưỡng đó, bạn dùng một neuron. Nó cũng nhận ba con số, nhưng thay vì luật cứng thì tính tổng có trọng số:
function neuron(x1, x2, x3):
    w1 <- 0.6   // thu nhập có trọng số cao nhất
    w2 <- 0.2   // số năm làm việc ảnh hưởng ít hơn
    w3 <- -0.5  // càng nhiều nợ càng bị trừ điểm
    b  <- -2.0  // ngưỡng cơ sở (bias)
    z  <- w1 * x1 + w2 * x2 + w3 * x3 + b
    a  <- f(z)  // hàm kích hoạt
    return a
Bốn con số w1, w2, w3, b là các tham số (parameters). Ở ví dụ này bạn tự đặt tay. Khi train một neural network, thuật toán học tự tìm ra những con số này từ dữ liệu lịch sử, khỏi cần chuyên gia ngồi nghĩ "thu nhập nên có hệ số 0.6 hay 0.7".
2.1 Tính tay: hồ sơ A (thu nhập ổn)
| Đầu vào | Giá trị | Trọng số | Tích |
|---|---|---|---|
| x1: thu nhập | 10 triệu | 0.6 | 6.0 |
| x2: năm làm việc | 3 năm | 0.2 | 0.6 |
| x3: số khoản nợ | 1 khoản | -0.5 | -0.5 |
| b: bias | -2.0 | ||
| z: tổng | 4.1 |
z = 6.0 + 0.6 - 0.5 - 2.0 = 4.1. Dương và khá cao, nên qua hàm kích hoạt thì neuron "bật mạnh".
2.2 Hồ sơ B (thu nhập thấp, nhiều nợ)
| Đầu vào | Giá trị | Trọng số | Tích |
|---|---|---|---|
| x1: thu nhập | 5 triệu | 0.6 | 3.0 |
| x2: năm làm việc | 1 năm | 0.2 | 0.2 |
| x3: số khoản nợ | 3 khoản | -0.5 | -1.5 |
| b: bias | -2.0 | ||
| z: tổng | -0.3 |
z = 3.0 + 0.2 - 1.5 - 2.0 = -0.3. Âm, nên neuron "tắt". Cùng một hàm, cùng bộ trọng số, kết quả ngược nhau vì đầu vào khác nhau.
Bốn con số w1, w2, w3, b quyết định toàn bộ hành vi của hàm chấm điểm. Đổi chúng là đổi "quan điểm" của neuron, không cần sửa dòng code nào.
3. Công thức tổng quát và sơ đồ
Với n đầu vào, công thức một neuron viết gọn:
z = w1*x1 + w2*x2 + ... + wn*xn + b   // tổng có trọng số
a = f(z)                                // hàm kích hoạt
Trong đó x1 đến xn là đầu vào (dữ liệu, không đổi khi train); w1 đến wn là trọng số (thứ model học được); b là bias (cũng học được); f là hàm kích hoạt (một hàm toán học cố định); a là đầu ra của neuron (activation).
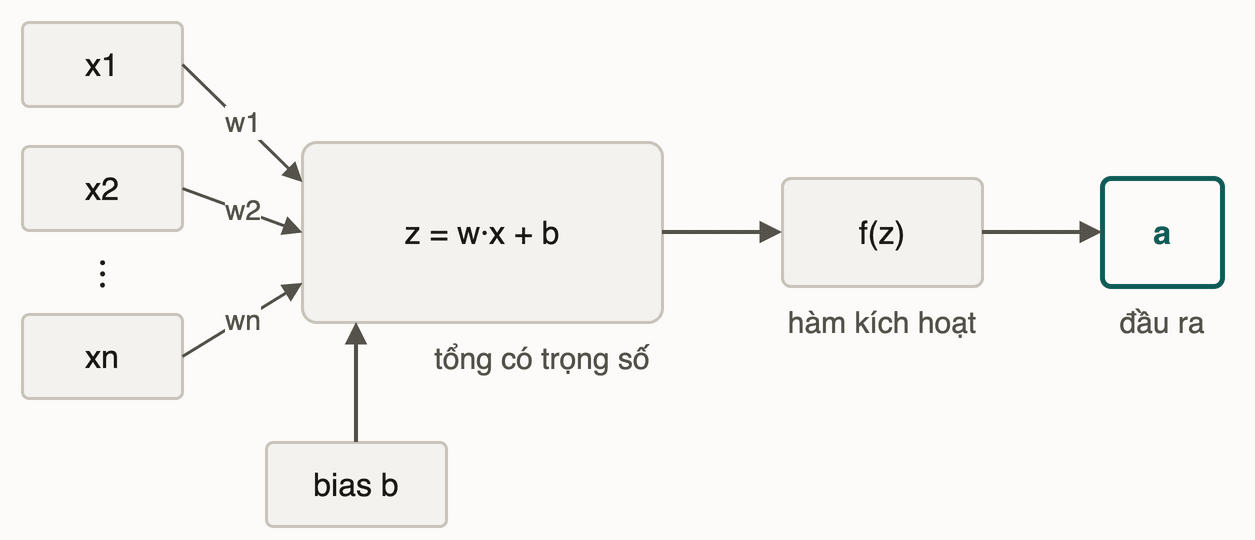
Phép "nhân trọng số rồi cộng" này có mặt ở mọi mạng nơ-ron hiện đại, từ mạng nhỏ nhất tới GPT hay Claude. Nhưng nói các model lớn "chỉ khác nhau ở số neuron" thì sai: transformer còn có attention, softmax, layer norm và nhiều khối khác không phải neuron đơn lẻ (module 4). Neuron là viên gạch nhiều nhất, không phải viên gạch duy nhất.
4. Khi model "học", cái gì thay đổi?
Câu trả lời ngắn: khi train model, chỉ có w và b thay đổi.
Công thức tính z, hàm kích hoạt f, kiến trúc mạng (bao nhiêu lớp, mỗi lớp bao nhiêu neuron) đều cố định trước khi train. Chỉ các con số trọng số được cập nhật qua từng bước học.
Đây là khác biệt căn bản với rule-based ở module 1:
| Rule-based | Neural network | |
|---|---|---|
| Logic nằm ở đâu | Trong code: if-else, hàm, luật | Trong các con số w và b |
| Cách "học" | Dev viết thêm luật, sửa code | Cập nhật giá trị w và b |
| Con người đóng góp gì | Viết từng luật | Chọn dữ liệu, nhãn, kiến trúc; không viết luật |
| Đổi hành vi bằng cách nào | Sửa code rồi deploy lại | Thay bộ trọng số |
Trong ví dụ vay vốn: rule-based là người ngồi gõ if thu_nhap > 10 && so_no < 2 → duyệt. Neural network là đưa cho thuật toán hàng nghìn hồ sơ đã duyệt hay từ chối, rồi thuật toán tự tìm ra w1 = 0.6, w2 = 0.2, w3 = -0.5, b = -2.0, hoặc một bộ số tốt hơn, để tái tạo đúng các quyết định đó.
"Tham số" chính là các con số w và b trong toàn mạng. Model 7 tỷ tham số có khoảng 7.000.000.000 con số như vậy, được train cùng lúc. "Train lại" hay "fine-tune" là cập nhật lại một phần hoặc toàn bộ số đó; không có code mới, không có luật mới, không có kiến trúc mới.
5. Bias dời ngưỡng như thế nào?
Bias b có một vai đơn giản nhưng không bỏ được: dời ngưỡng.
Nếu không có bias (b = 0), tổng là z = w1*x1 + ... + wn*xn. Khi mọi đầu vào bằng không thì z luôn bằng không, và neuron không có cách nào nghiêng mặc định về "bật" hay "tắt".
Bias cộng thêm một con số độc lập với đầu vào, cho neuron một điểm xuất phát riêng. Nó giống hệ số c trong phương trình đường thẳng y = ax + c: dời đường thẳng lên hay xuống mà không đổi độ dốc.
Trong ví dụ vay vốn, b = -2.0 nghĩa là hồ sơ nào cũng bắt đầu từ -2.0 điểm và phải "kiếm đủ điểm" từ thu nhập, kinh nghiệm mới lên được vùng dương. Ý tưởng "tiêu chuẩn tối thiểu để qua" được mã hoá thành một con số học được, thay vì hardcode ngưỡng trong code.
6. Hàm kích hoạt: vì sao tổng tuyến tính chưa đủ?
Tính xong z, sao không dùng thẳng z làm đầu ra? Cần thêm f làm gì?
Câu trả lời đầy đủ ở bài 02: Xếp lớp và hàm phi tuyến. Trực giác ngắn gọn: nếu f là hàm tuyến tính (hoặc không có f), xếp bao nhiêu lớp neuron thì kết quả cuối vẫn chỉ là một tổng tuyến tính, tương đương đúng một lớp. Thêm lớp mà không có phi tuyến thì mạng không mạnh thêm chút nào.
Hàm kích hoạt bẻ cong đầu ra. ReLU trả về z nếu z dương và 0 nếu âm, tạo ra một "ngưỡng" phi tuyến. Sigmoid nén z về khoảng 0 đến 1. Chính chỗ bẻ cong này mới cho mạng nhiều lớp học được những quan hệ mà một đường thẳng không mô tả nổi.
Những tên hay gặp: ReLU (Rectified Linear Unit) trả về max(0, z); Sigmoid nén về 0 đến 1, hay dùng ở lớp đầu ra cho phân loại nhị phân; Tanh nén về -1 đến 1; GELU là biến thể mịn của ReLU, dùng trong transformer. Không cần nhớ công thức; tất cả đều làm một việc: bẻ cong đầu ra theo cách phi tuyến.
7. Ba hiểu lầm hay gặp khi mới học neuron
Hiểu lầm 1: neuron nhân tạo mô phỏng nơ-ron sinh học. Cái tên là di sản từ thập niên 1940–1950, khi các nhà nghiên cứu lấy cảm hứng từ khoa học thần kinh. Hai thứ khác nhau hẳn: nơ-ron sinh học dùng tín hiệu điện hoá, nối với nhau phức tạp và thay đổi theo cách mà một phép tổng có trọng số không mô phỏng được. Tên gọi là ẩn dụ lịch sử, không phải bản thiết kế.
Hiểu lầm 2: "học" là model tự sinh thêm luật hoặc code. Train xong, model không có thêm dòng code, hàm hay nhánh điều kiện nào. Thứ duy nhất đổi là các con số w và b. Kiến thức được mã hoá vào những con số đó, không vào cấu trúc chương trình.
Hiểu lầm 3: model chứa nguyên bộ dữ liệu huấn luyện bên trong. Trọng số không phải bảng tra; chúng là kết quả của quá trình học và phần lớn phản ánh pattern chứ không chép lại dữ liệu. Nhưng đừng đi sang cực bên kia: model lớn vẫn có thể ghi nhớ nguyên văn một số đoạn từng gặp nhiều lần trong dữ liệu (hiện tượng memorization, đã được đo trên LLM thật). Vì cơ chế chính là tái tạo pattern chứ không phải tra cứu, model mới trả lời được câu hỏi chưa từng thấy, và cũng vì thế mà nó có thể nói sai mà vẫn rất tự tin (hallucinate).
Thử ngẫmhai lập trình viên deploy cùng một bản code neural network, chỉ khác nhau ở file trọng số đã train. Chương trình của họ có "khác" nhau không, và khác ở đâu?
8. Liên hệ các bài khác
- Module 1, bài 01: Khi nào cần học từ dữ liệu: vì sao đôi khi rule-based tốt hơn ML; bài này cho thấy khi đã chọn ML thì "học" cụ thể là gì.
- Bài 02: Xếp lớp và hàm phi tuyến: vì sao xếp nhiều neuron tuyến tính không mạnh thêm, và MLP là gì.
- Bài 03: Loss: loss đo độ sai của cả bộ trọng số, thứ quá trình train tìm cách làm nhỏ đi.
- Bài 04: Gradient descent: cơ chế thật sự cập nhật
wvàb. - Bài 05: Tham số và siêu tham số: đếm
wvàbtrong cả mạng, ước lượng bộ nhớ.
9. Tóm tắt
- Hồ sơ A ra z = 4.1, hồ sơ B ra z = -0.3: cùng bốn con số, hai quyết định ngược nhau.
- Đặt b = 0 thì hồ sơ B đổi thành 1.7 và được duyệt: bias chính là "tiêu chuẩn tối thiểu" dạng số.
- Neuron là khối tính toán nhiều nhất trong LLM, nhưng transformer còn attention, softmax, layer norm.
- Model chủ yếu lưu pattern, nhưng vẫn có thể thuộc nguyên văn một số đoạn dữ liệu lặp nhiều.
10. Tự kiểm tra
- Q1Nếu tăng trọng số w1 gấp đôi nhưng giữ nguyên mọi đầu vào, tổng z thay đổi thế nào? Giải thích theo công thức.
- Q2Một đồng nghiệp nói: 'sau mỗi epoch train, model sinh ra rule mới nên dần hiểu được vấn đề'. Sai ở đâu? Cái gì thật sự thay đổi sau mỗi epoch?
- Q3Vì sao nói neural network 'lưu tri thức vào số' thay vì 'vào code'? Điều này khác lập trình rule-based ở đâu?
- Q4Trong ví dụ vay vốn, bias b = -2.0. Nếu đặt b = 0 và giữ nguyên mọi trọng số, hồ sơ B (trước đó z = -0.3) cho z bằng bao nhiêu? Điều đó nói gì về vai trò của bias?
- Q5Các model LLM lớn được ước tính có hàng trăm tỷ tham số. Theo bài này, những tham số đó là gì, và khi 'fine-tune model trên tài liệu công ty' thì thứ gì thay đổi?
- Q6Model chủ yếu lưu pattern trong trọng số chứ không tra cứu dữ liệu gốc. Điều đó giải thích được gì về hallucination, và vì sao vẫn không nên nói 'model không nhớ gì từ dữ liệu'?
Bài tiếp theo: Xếp lớp và hàm phi tuyến: vì sao một lớp không đủ
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này