Từ transformer đến LLM: causal mask và train song song
Causal mask ép token chỉ nhìn quá khứ để train song song mọi vị trí, còn inference vẫn sinh tuần tự từng token, chậm dần theo số token sinh ra.
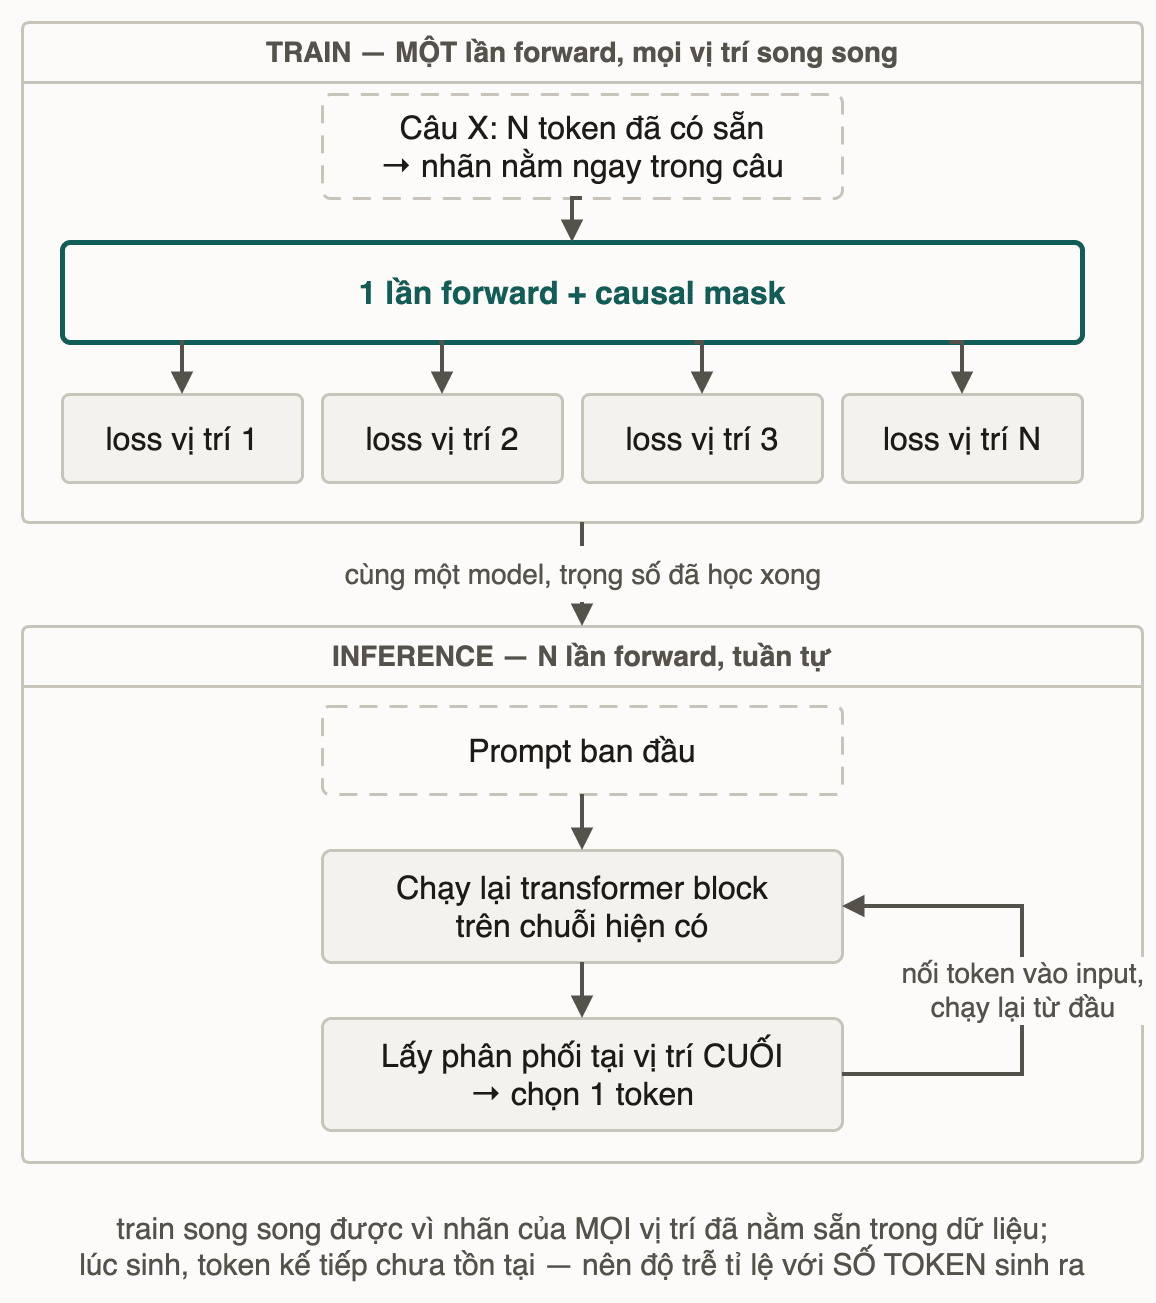
TL;DR: LLM hiện đại là decoder-only transformer: nhiều transformer block xếp chồng, dùng self-attention kèm causal mask, tức mỗi token chỉ được nhìn các token đứng trước nó, không bao giờ thấy token đứng sau. Attention đã cho phép tính mọi vị trí song song; causal mask là thứ làm cho việc đó dùng được để train next-token: nhãn (token kế tiếp) có sẵn trong dữ liệu, model tính loss cho mọi vị trí trong một lần forward mà không được nhìn trộm đáp án. Inference thì ngược lại: token kế tiếp chưa tồn tại, phải sinh xong token này mới biết token sau, nên vòng lặp next-token lại chạy tuần tự, và thời gian sinh chủ yếu tăng theo số token phải sinh ra.
Bạn dùng API của một LLM để tóm tắt một tài liệu dài, câu tóm tắt vài dòng hiện ra khá nhanh. Cùng ngày, bạn nhờ chatbot viết một bài luận dài: chữ chạy ra chậm rãi, nối tiếp nhau, càng dài càng phải đợi lâu. Cùng một model, cùng kiến trúc, mà một việc xong nhanh còn việc kia chậm dần theo đúng số chữ sinh ra.
Nghịch lý còn lộ rõ hơn ở phía train: model học từ cả một đoạn văn dài trong một lần forward duy nhất, không xử lý tuần tự từng token như model đọc kiểu cũ (Giới hạn 2, bài 01 module này). Vậy vì sao xử lý một chuỗi có sẵn thì song song được, còn sinh một chuỗi mới lại phải tuần tự? Bài này lần theo đúng cơ chế tạo ra bất đối xứng đó: causal mask.
1. Analogy: chấm bài văn mẫu có sẵn vs tự viết bài trong giờ thi
Hình dung một bài kiểm tra tự luận: học sinh phải viết một đoạn văn hoàn chỉnh, viết tới đâu mới biết câu tiếp theo tới đó, không thể biết trước câu thứ mười khi mới viết xong câu thứ ba. Đó là lúc làm bài, một việc bắt buộc tuần tự.
Giáo viên chấm bài thì khác hẳn. Cô có sẵn một bài văn mẫu hoàn chỉnh và chấm mọi câu cùng lúc: câu ba đúng hay sai, câu bảy đúng hay sai, tất cả kiểm tra song song, vì đáp án của mọi câu đã có sẵn trên giấy. Chỉ có một điều cô phải tự nhắc mình: khi chấm câu ba, không được liếc sang câu bảy để "đoán" học sinh viết đúng, mà chỉ chấm dựa trên những gì đã viết trước câu ba.
| Đời thường | Transformer |
|---|---|
| Học sinh viết bài — chưa biết câu sau sẽ viết gì | Inference — token kế tiếp chưa tồn tại, phải sinh xong token này mới tới token sau |
| Giáo viên chấm bài mẫu có sẵn — kiểm tra mọi câu cùng lúc | Train — token kế tiếp đã có sẵn trong dữ liệu, tính loss cho mọi vị trí trong một lần forward |
| Giáo viên phải tự cấm mình liếc câu sau khi chấm câu trước | Causal mask — ép model chỉ tính dựa trên token đứng trước, dù đáp án tương lai đang nằm ngay đó trong dữ liệu |
Chấm bài (đáp án có sẵn) thì chấm song song được. Làm bài (chưa có gì viết ra) thì buộc phải tuần tự. Train giống chấm bài, inference giống làm bài: cùng một model, ràng buộc khác hẳn.
2. Causal mask chặn token nhìn về tương lai như thế nào?
Bài 02–03 của module này đã dựng self-attention: mỗi token tính điểm khớp với mọi token khác trong câu, kể cả token đứng sau nó. Đó là self-attention "đầy đủ", không giới hạn hướng nhìn.
Decoder-only LLM, kiến trúc mà hầu hết LLM hiện nay dùng, thêm đúng một ràng buộc lên self-attention đó, gọi là causal mask (mask nhân quả). Trong "Attention Is All You Need" (arXiv:1706.03762), Vaswani và cộng sự gọi nó là "masked multi-head attention": trước bước softmax, mọi điểm attention đi từ token ở vị trí i tới một token đứng sau nó bị gán về âm vô cực (trong code thường là một số âm rất lớn), nên trọng số sau softmax bằng không. Token thứ i chỉ được nhìn các token từ vị trí một tới i.
Viết thành ma trận cho một câu bốn token, hàng là token đang tính, cột là token được phép nhìn:
Câu 4 token: [Tôi] [thích] [học] [máy]

           Tôi  thích  học  máy
  Tôi       1     0     0    0     -- token 1 chỉ thấy chính nó
  thích     1     1     0    0     -- token 2 thấy token 1, 2
  học       1     1     1    0     -- token 3 thấy token 1, 2, 3
  máy       1     1     1    1     -- token 4 thấy cả 4 token

-- 1 = được nhìn, 0 = bị che về âm vô cực trước softmax
Nếu bỏ hẳn causal mask, để mọi token tự do nhìn cả token đứng sau nó, rồi vẫn train model dự đoán token kế tiếp như bình thường, thì quá trình học sẽ ra sao? Viết dự đoán ra trước khi đọc tiếp.
Không che tương lai thì token ở vị trí i có thể đặt attention thẳng vào token kế tiếp, tức đúng đáp án model đang phải đoán. Model chỉ cần học cách chép lại token nằm ngay sau trong input là loss tụt gần về không, nhưng vô dụng khi sinh văn bản thật, vì lúc đó token kế tiếp chưa tồn tại để mà nhìn trộm. Hiện tượng này gọi là rò rỉ nhãn (label leakage), và causal mask có mặt để chặn đúng lỗ hổng đó.
3. Vì sao causal mask không phá mất tính song song?
Bài 01 module này đã chỉ ra giới hạn của model đọc tuần tự: h_t được tính từ h_(t-1), bước t phải đợi bước t-1 xong, nên chuỗi phụ thuộc chạy dọc thời gian và không song song hoá được. Attention (bài 02–03) gỡ đúng chỗ đó: mỗi token nhìn thẳng mọi token khác trong một phép tính ma trận.
Causal mask ép mỗi token chỉ nhìn về quá khứ, vậy nó có dựng lại chuỗi phụ thuộc mà bài 01 vừa thoát ra không? Không. Causal mask là một ma trận cố định, biết trước ngay khi biết độ dài câu, không phụ thuộc kết quả tính của vị trí nào khác. Áp ma trận cố định đó lên attention của cả chuỗi vẫn là một phép nhân ma trận, không phải một vòng lặp phải đợi bước trước.
Thêm nữa, lúc train thì dữ liệu có sẵn toàn bộ câu trước khi train bắt đầu, nên nhãn của mọi vị trí đã nằm sẵn, không cần tính xong vị trí trước mới có nhãn cho vị trí sau:
function train_step(câu X gồm N token, causal_mask):
    H <- transformer(X, causal_mask)          -- chồng N block, 1 lần gọi, tính CẢ N vị trí cùng lúc
    loss <- 0
    for i từ 1 đến N-1:                        -- vòng lặp này chỉ CỘNG DỒN loss
        logits_i <- lm_head(H[i])              -- chiếu vector ẩn sang kích thước vocabulary
        phan_phoi_i <- softmax(logits_i)
        loss <- loss + cross_entropy(phan_phoi_i, X[i+1])   -- nhãn X[i+1] ĐÃ CÓ SẴN
    return loss
-- Time: 1 forward pass cho cả N vị trí, không phải N bước tuần tự
Khác với model đọc tuần tự, transformer(X, causal_mask) là một lệnh: bên trong, phép nhân ma trận attention xử lý mọi vị trí song song trên GPU. lm_head là phép chiếu tuyến tính từ vector ẩn sang một điểm số cho mỗi token trong vocabulary (bài 07 gặp lại). Vòng for phía sau chỉ cộng dồn loss cho từng vị trí, không quyết định thứ tự tính của attention.
Thử ngẫmtăng gấp đôi số GPU dùng để train một model thì thời gian train có giảm theo tỉ lệ tương ứng không? Còn thời gian trả lời của model đã train xong có giảm theo cách tương tự không?
4. Vì sao inference vẫn phải tuần tự?
Bài đó đã lần theo vòng lặp autoregressive: model dự đoán phân phối xác suất cho token kế tiếp, chọn một token, nối vào chuỗi input, rồi lặp lại. Bài này bổ sung: chính vòng lặp đó là lý do inference của decoder-only transformer không song song được như train.
Ở mục 3, train song song được vì nhãn của mọi vị trí đã có sẵn trong dữ liệu, model chỉ cần bị cấm nhìn trộm. Khi sinh văn bản mới, điều kiện đó biến mất: token kế tiếp chưa tồn tại, nó là thứ model đang phải tạo ra. Với token cuối cùng đang được dự đoán, causal mask gần như không có gì để che, vì tương lai còn chưa được viết ra.
Hệ quả: muốn có token kế tiếp, model phải chạy xong cả chồng block trên chuỗi hiện có, lấy phân phối tại đúng vị trí cuối, chọn một token, nối vào, rồi chạy tiếp cho chuỗi vừa dài thêm một token:
input <- token của prompt
while chưa gặp token kết thúc:
    H <- transformer(input, causal_mask)        -- chạy lại cả chồng N block, input dài thêm 1 token
    logits_cuoi <- lm_head(H[vị trí cuối])      -- CHỈ cần vector tại vị trí cuối cùng
    token_moi <- chon_tu(softmax(logits_cuoi))
    input <- input + [token_moi]
-- Time: N lần gọi transformer để sinh N token, không phải 1 lần như train
Sinh một câu trả lời dài nghĩa là chạy model nhiều lần liên tiếp, lần sau đợi lần trước xong mới bắt đầu. Đó là cảm giác "chữ chạy từng dòng" ở đầu bài: thời gian sinh chủ yếu tăng theo số token output. Prompt thì khác: nó được xử lý song song ngay trong lần forward đầu tiên (đúng như mục 3), nên prompt dài chủ yếu làm bạn chờ lâu hơn trước khi token đầu tiên hiện ra, và làm mỗi bước sau đó nặng thêm một chút vì token mới phải nhìn lại cả context dài hơn. Module 3 bài 03 gặp đúng chuyện này ở góc độ context window.
Bài đó tách hai pha theo chi phí: train trả một lần rất nặng, inference trả theo từng lượt gọi. Bài này thêm một bất đối xứng khác nằm ngay trong cùng kiến trúc: mỗi bước train là một lần forward song song, còn inference là nhiều lần forward tuần tự, nên chi phí inference không chỉ tính theo lượt gọi mà còn tăng theo số token model phải sinh ra trong lượt đó.
Chạy lại cả chồng block từ đầu cho mỗi token mới nghe lãng phí, vì phần token cũ đã được tính y hệt ở lần trước. Hệ thống production lưu lại key/value của các token cũ (KV cache) để khỏi tính lại phần quá khứ; mỗi bước chỉ tính cho token mới, nhưng token mới vẫn phải attention qua toàn bộ key/value đã lưu. Bài này chỉ cần bạn biết cơ chế đó tồn tại.
Thử ngẫmmột tính năng AI trả lời real-time trong game không được phép trễ. Giữa "rút ngắn system prompt" và "giới hạn số token model được sinh ra", cách nào giảm tổng thời gian trả lời nhiều hơn?
5. Pitfall tổng hợp
❌ Nhầm 1: nghĩ causal mask chỉ cần lúc inference, để model "không gian lận" khi sinh.
✅ Causal mask áp dụng cả lúc train, và đó mới là chỗ nó quan trọng nhất (mục 2): lúc train, nhãn tương lai nằm sẵn trong dữ liệu, nên phải chủ động che thì model mới học thật, không rò rỉ nhãn. Lúc inference, tương lai còn chưa tồn tại nên mask gần như không có gì để che.
❌ Nhầm 2: nghĩ train "song song mọi vị trí" thì inference cũng tăng tốc được bằng cách sinh nhiều token cùng lúc theo cách tương tự.
✅ Train song song được vì nhãn của mọi vị trí đã có sẵn trước khi chạy (mục 3). Lúc sinh, token kế tiếp chưa tồn tại cho tới khi token hiện tại được chọn xong, nên không có "nhãn có sẵn" nào để tính song song. (Có kỹ thuật sinh nhanh hơn như speculative decoding, nhưng đó là chủ đề khác, ngoài phạm vi bài này.)
❌ Nhầm 3: nghĩ causal mask áp cho cả transformer block, kể cả tầng feed-forward.
✅ Causal mask chỉ có nghĩa trong self-attention, nơi một token thật sự "nhìn" sang token khác. Tầng feed-forward xử lý từng vị trí hoàn toàn độc lập, không có bước nào để nhìn trộm token khác, nên không cần mask.
6. 📚 Deep Dive
Paper chính chủ:
- Vaswani et al. — Attention Is All You Need (arXiv:1706.03762): nơi kiến trúc transformer và masked (causal) self-attention trong decoder được trình bày lần đầu. Đọc để thấy causal mask trong bài này bắt nguồn từ thiết kế nào.
- Brown et al. — Language Models are Few-Shot Learners (arXiv:2005.14165): dòng GPT đưa kiến trúc decoder-only autoregressive này lên quy mô hàng trăm tỷ tham số. Đọc để thấy cặp "train song song / inference tuần tự" của bài này nằm bên dưới những hệ thống lớn thế nào.
Ghi chú: bài này thuần cơ chế kiến trúc, không trích số liệu benchmark từ hai paper trên; ví dụ đầu bài (tóm tắt nhanh, bài luận chậm) là minh hoạ định tính cho độ trễ, không phải kết quả đo từ một hệ thống cụ thể.
7. Liên hệ các bài khác
- Bài 02 — Attention, truy vấn có trọng số: self-attention nền tảng mà causal mask áp thêm ràng buộc lên.
- Bài 03 — Multi-head, nhiều góc nhìn: mọi head trong multi-head attention dùng chung một causal mask, không head nào được miễn.
- Bài 04 — Transformer block: causal mask nằm trong bước self-attention của block đó; bài 04 dựng cấu trúc, bài này dựng ràng buộc chạy bên trong.
- Bài 06 — Scaling laws, nhìn định tính: bài tiếp theo, giữ nguyên kiến trúc decoder-only này và hỏi tăng params, data, compute thì khả năng model đổi ra sao.
8. Tóm tắt
- Mask là ma trận tam giác cố định, gán âm vô cực cho vị trí tương lai trước softmax; áp cho mọi head, chỉ trong self-attention.
- Bỏ mask khi train thì rò rỉ nhãn: model học chép token ngay sau thay vì học ngôn ngữ.
- Train một câu N token là một lần forward; sinh N token là N lần forward nối tiếp nhau.
- Số token output quyết định phần lớn thời gian sinh; prompt dài làm tăng thời gian chờ token đầu và làm mỗi bước nặng hơn.
- KV cache giữ key/value của token cũ để mỗi bước chỉ tính token mới.
9. Tự kiểm tra
- Q1Giải thích cơ chế causal mask trong self-attention: nó thay đổi điều gì trước bước softmax, và vì sao token ở một vị trí không bao giờ 'nhìn thấy' token đứng ngay sau nó?
- Q2Nếu bỏ causal mask lúc train, model vẫn có thể đạt loss rất thấp — nhưng đó không phải dấu hiệu tốt. Giải thích vì sao, và nêu tên hiện tượng này.
- Q3Causal mask ép mỗi token chỉ nhìn về quá khứ. Vì sao ràng buộc này không dựng lại đúng chuỗi phụ thuộc tuần tự mà model đọc tuần tự kiểu cũ từng mắc phải?
- Q4Một đồng nghiệp nói: 'Train song song hoá được thì chắc sinh văn bản cũng nhanh song song luôn.' Chỉ ra chỗ sai trong lập luận này.
- Q5Cùng một model, request A có prompt 8.000 token và chỉ sinh 20 token; request B có prompt 200 token và sinh 1.500 token. Request nào nhiều khả năng mất nhiều thời gian hơn để trả lời xong, và prompt dài ảnh hưởng tới phần nào của thời gian chờ?
Bài tiếp theo: Scaling laws — nhìn định tính
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Transformer block: ghép attention, FFN, residual thành khối
Bài tiếpScaling laws — dự đoán loss khi tăng params, data, compute
Thảo luận & góp ý
Hỏi đáp về bài này