Multi-head attention — mỗi head một góc nhìn riêng
Một attention head chỉ bắt được một kiểu quan hệ. Chạy nhiều head song song, mỗi head học một góc nhìn — ngữ pháp, đồng tham chiếu, vị trí — rồi ghép lại.
TL;DR: Một attention head chỉ học được một kiểu "khớp" giữa query và key, tức chỉ bắt tốt một loại quan hệ giữa các token. Transformer gỡ giới hạn đó bằng cách chạy nhiều head song song: mỗi head có bộ trọng số chiếu Q/K/V riêng nên có thể chuyên về một kiểu quan hệ khác nhau, như ngữ pháp, đồng tham chiếu hay vị trí lân cận. Không ai lập trình sẵn vai trò này; giống trọng số của một neuron, vai trò của mỗi head hình thành qua quá trình train. Kết quả các head được ghép (concat) rồi chiếu lại thành một representation giàu thông tin hơn bất kỳ head đơn lẻ nào.
Bài đó đã chốt: một neuron chỉ tính tổng có trọng số rồi qua hàm kích hoạt, và thứ duy nhất việc huấn luyện thay đổi là các con số trọng số, không phải cấu trúc hàm. Bài này áp đúng nguyên lý đó lên một tầng cao hơn: bộ trọng số chiếu Q/K/V của mỗi attention head cũng chỉ là những con số được học. Chính vì học từ dữ liệu chứ không lập trình tay, các head mới có thể tự chia vai khác nhau.
1. Analogy: ba chuyên gia cùng nghe một cuộc họp
Hình dung ba chuyên gia (luật sư, kế toán, quản lý dự án) cùng ngồi nghe một cuộc họp. Cả ba nghe đúng một nội dung, nhưng mỗi người tự lọc theo tiêu chí nghề của mình: luật sư để ý rủi ro pháp lý, kế toán để ý con số, quản lý dự án để ý deadline. Không ai bảo họ nghe như vậy, đó là phản xạ nghề nghiệp hình thành qua kinh nghiệm. Cuối buổi, ba bản ghi chú ghép lại thành một biên bản đầy đủ hơn bất kỳ bản đơn lẻ nào.
| Đời thường | Multi-head attention |
|---|---|
| Ba chuyên gia cùng nghe một cuộc họp | H head cùng nhận một token embedding đầu vào |
| Mỗi người lọc theo tiêu chí riêng — pháp lý, tài chính, deadline | Mỗi head có bộ trọng số chiếu Q/K/V riêng, tự chuyên về một kiểu quan hệ |
| Ghép các ghi chú riêng thành một biên bản đầy đủ | Ghép (concat) output các head, chiếu qua Wo thành representation cuối |
2. Một câu, ba head giả định: bạn đoán các head chú ý vào đâu?
Xét câu sau:
"Lan nuôi một con mèo; nó đã trốn khỏi nhà hôm qua."
Khi model xử lý token "nó", giả sử có 3 attention head chạy song song, gọi là Head A, Head B, Head C.
Đừng đọc mục 3 vội. Với token "nó" trong câu trên, viết ra dự đoán của bạn:
- Mỗi head trong ba head A, B, C sẽ dồn trọng số attention cao nhất vào những token nào?
- Ba head chú ý giống nhau, hay mỗi head nghiêng về một (hoặc vài) token khác nhau? Vì sao bạn nghĩ vậy?
Bước đoán không có đáp án đúng/sai tuyệt đối; mục tiêu là bạn tự hình dung được rằng các head CÓ THỂ khác nhau, trước khi đọc giải thích ở mục 3.
3. Vì sao một head chỉ bắt được một kiểu khớp?
Nhắc nhanh cơ chế một head ở bài 02: mỗi token tính ra một query, đem so với key của mọi token khác, rồi lấy tổng có trọng số các value theo mức khớp đó. Điều bài này cần thêm: "khớp" theo tiêu chí nào là do ma trận chiếu Wq và Wk của CHÍNH head đó quyết định. Đổi ma trận chiếu là đổi luôn tiêu chí, và token nào khớp mạnh với token nào cũng đổi theo.
Quay lại ví dụ ở mục 2. Với ba head giả định, một cách chia vai hợp lý là:
- Head A (đồng tham chiếu): với query là "nó", khớp mạnh nhất với "con mèo", tức học kiểu quan hệ đại từ trỏ về danh từ nào.
- Head B (ngữ pháp, chủ ngữ–động từ): với query là "nó", khớp mạnh với "đã trốn", động từ mà "nó" làm chủ ngữ, dù hai token cách nhau bao xa.
- Head C (vị trí lân cận): với query là "nó", khớp mạnh với 1-2 token liền kề, học kiểu quan hệ định vị cục bộ, không quan tâm ý nghĩa.
Nếu dự đoán của bạn ở mục 2 gần với ba vai trò trên, đó không phải vì có luật gán trước. Đồng tham chiếu, cú pháp, vị trí là những pattern rất có ích để dự đoán từ tiếp theo trong văn bản tự nhiên, nên khi train trên lượng lớn văn bản, các head có xu hướng tự chuyên về những pattern đó để giảm loss.
4. Nhiều head được chiếu riêng, chạy song song và ghép lại ra sao?
Với H head chạy song song, mỗi head h có bộ trọng số chiếu riêng Wq_h, Wk_h, Wv_h, và những ma trận này KHÔNG dùng chung giữa các head. Cùng một token embedding đầu vào, mỗi head chiếu nó vào một không gian riêng, tính attention độc lập, rồi mọi kết quả được ghép lại:
function multiHeadAttention(x, H):
    heads <- []
    for h in 1..H:
        Wq_h, Wk_h, Wv_h <- trọng số riêng của head h    -- không dùng chung giữa các head
        Q_h <- x * Wq_h
        K_h <- x * Wk_h
        V_h <- x * Wv_h
        heads[h] <- attention(Q_h, K_h, V_h)              -- một head đơn, xem Bài 02
    concatenated <- concat(heads[1], ..., heads[H])
    output <- concatenated * Wo                            -- chiếu lại về một không gian chung
    return output
// H head chạy ĐỘC LẬP và SONG SONG — không head nào chờ head khác xong trước
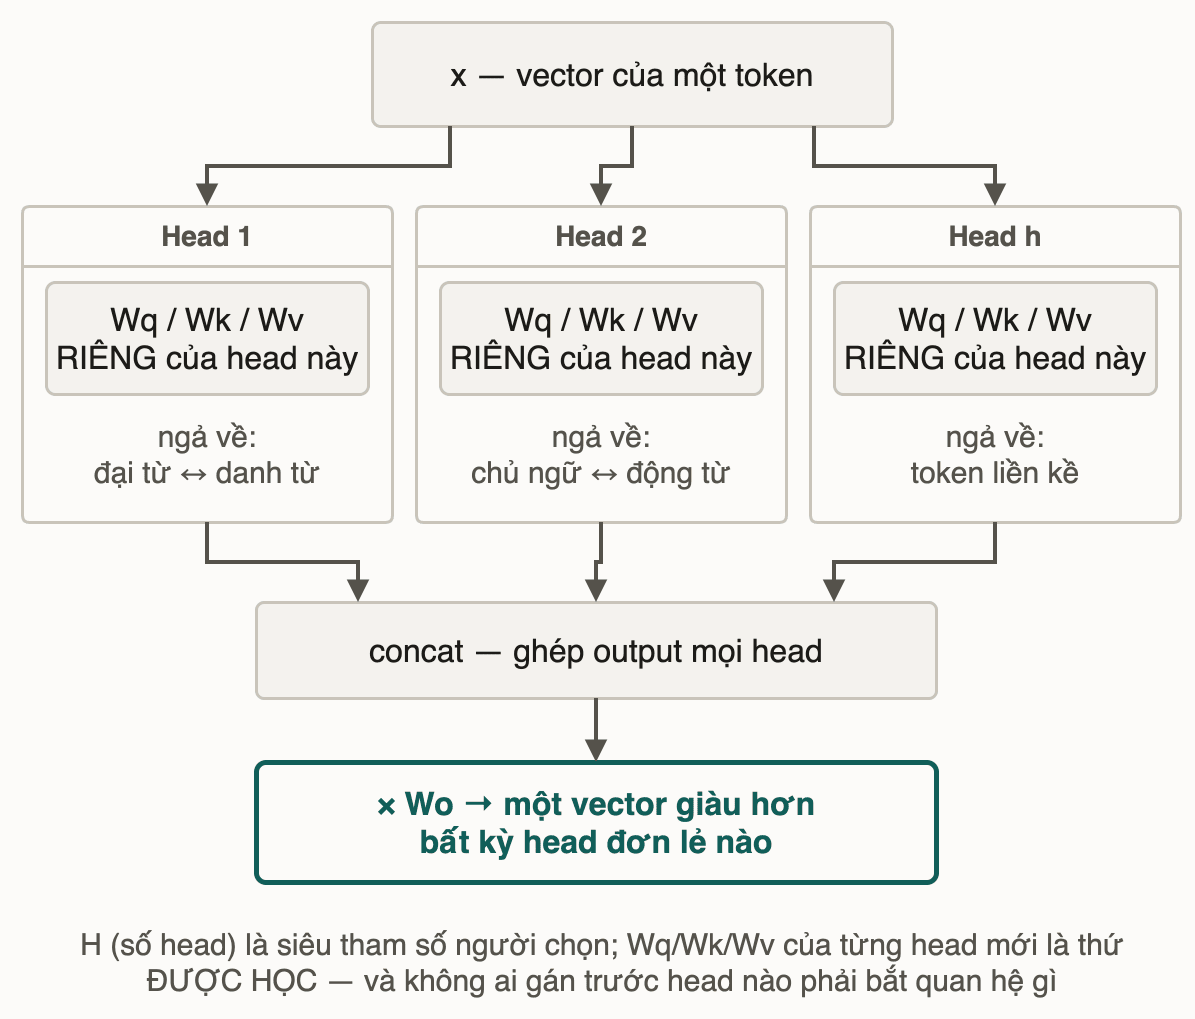
Mỗi head không làm việc trên vector đầy đủ d_model chiều. Kiến trúc chuẩn chia đều: mỗi head chiếu vào một không gian d_k = d_model / H chiều, rồi H mảnh đó ghép lại vừa đúng d_model. Nhờ vậy nhiều head không làm tổng chi phí tăng theo H.
Số head H là một hyperparameter: người thiết kế kiến trúc chọn trước khi train, và nó cố định suốt quá trình train. Khác hẳn với Wq_h/Wk_h/Wv_h: những ma trận đó MỚI là thứ được học và thay đổi qua từng bước train, giống hệt w và b của một neuron thay đổi trong khi kiến trúc mạng giữ nguyên (Bài 01, Module 2).
Thử ngẫmtăng số head từ 8 lên 32 để mong model "nhìn" được nhiều góc hơn, giữ nguyên d_model. Công thức d_k = d_model / H vừa nêu cảnh báo điều gì có thể phản tác dụng?
5. Ai gán vai trò cho từng head?
Không ai cả, và đây là chỗ nhiều người mới học AI hiểu nhầm, tưởng ai đó thiết kế "head 3 học ngữ pháp, head 5 học đồng tham chiếu". Giống cách một neuron học w và b (không ai gán tay, quá trình train tự tìm ra để giảm loss), bộ trọng số Wq_h/Wk_h/Wv_h của MỖI head cũng chỉ là những con số được gradient descent cập nhật. Các head chuyên môn hoá vì như vậy giúp cả nhóm giảm loss tốt hơn so với để H head học y hệt nhau.
Cũng vì thế, đừng coi vai trò của một head là cố định. Model khác, dữ liệu train khác, thậm chí hai lần train cùng kiến trúc (khởi tạo trọng số ngẫu nhiên khác nhau) đều có thể cho ra cách chia vai khác. Và khi các nhà nghiên cứu soi model thật, phần lớn head không gọn gàng như ví dụ A/B/C: nhiều head trộn vài kiểu quan hệ, một số head gần như thừa. Ví dụ ba head ở mục 3 là bức tranh đã đơn giản hoá; điều ổn định là các KIỂU quan hệ có ích (ngữ pháp, đồng tham chiếu, vị trí) hay xuất hiện lại, vì chúng có ích cho cùng một bài toán dự đoán từ tiếp theo.
Thử ngẫmtrain lại đúng kiến trúc này với một điểm khởi tạo ngẫu nhiên khác, head số 3 có chắc vẫn học "đồng tham chiếu" không? Điều đó nói gì về thói quen gắn nhãn "head này chuyên trách X"?
6. Pitfall thường gặp
❌ Nhầm 1: tưởng multi-head là chạy lại cùng một phép tính nhiều lần "cho chắc".
✅ Multi-head KHÔNG chạy lại cùng một phép tính. Mỗi head có bộ trọng số chiếu RIÊNG (Wq_h/Wk_h/Wv_h khác nhau), nên tính ra kết quả khác nhau theo thiết kế. Mục tiêu là đa dạng góc nhìn, không phải lặp lại để giảm nhiễu như ensemble voting.
❌ Nhầm 2: tưởng càng nhiều head thì model càng "hiểu" nhiều quan hệ, lúc nào cũng tốt hơn.
✅ Tăng số head H mà giữ nguyên d_model thì mỗi head có ít chiều hơn (d_k = d_model / H). Đây là đánh đổi giữa SỐ LƯỢNG góc nhìn và ĐỘ CHI TIẾT của từng góc nhìn, không phải cứ tăng H là tốt hơn.
❌ Nhầm 3: nghĩ phải biết head nào học quan hệ gì mới dùng được model.
✅ Phần lớn ứng dụng thực tế không cần biết head cụ thể học gì; thông tin đó chỉ quan trọng khi làm nghiên cứu diễn giải (interpretability). Ở tầng ứng dụng, biết multi-head làm representation giàu hơn một head đơn là đủ để hiểu vì sao kiến trúc này hiệu quả.
7. 📚 Deep Dive
Nguồn gốc: Vaswani et al., Attention Is All You Need, arXiv:1706.03762 (2017), bài báo giới thiệu kiến trúc Transformer và multi-head attention. Trong kiến trúc gốc, nhóm tác giả dùng H = 8 head song song, mỗi head có d_k = d_v = d_model / H = 64 (với d_model = 512): chia không gian biểu diễn 512 chiều thành 8 phần, mỗi phần 64 chiều, để mỗi head chiếu vào một không gian nhỏ hơn nhưng chạy độc lập.
Ghi chú: con số 8 không phải hằng số bắt buộc; các model transformer về sau (BERT, GPT và nhiều biến thể) chọn số head khác nhau tuỳ kích thước model. Điểm cốt lõi không đổi: nhiều head chạy song song, mỗi head có bộ chiếu riêng.
8. Liên hệ các bài khác
- Bài 02 — Attention, phép truy vấn có trọng số: định nghĩa Q/K/V trong MỘT head; bài này chỉ mở rộng sang NHIỀU head chạy song song.
- Neuron nhân tạo — trọng số mới là thứ model học được: nguyên lý "trọng số được học, kiến trúc cố định" áp y hệt cho bộ trọng số chiếu của mỗi head.
- Bài 04 — Transformer block: ghép các mảnh: multi-head attention chỉ là MỘT bước trong transformer block; bài sau ghép nó với positional encoding, FFN, residual thành một lớp hoàn chỉnh.
9. Tóm tắt
- Tiêu chí "khớp" của một head nằm trong
Wq/Wkcủa chính head đó; nhiều head là nhiều tiêu chí chạy song song. - Mỗi head làm việc trên
d_k = d_model / Hchiều; kiến trúc gốc dùng 8 head × 64 chiều = 512. Hlà hyperparameter chọn trước khi train;Wq_h/Wk_h/Wv_hmới là thứ được học.- Vai trò của head không cố định giữa các lần train, và head thật thường không gọn gàng như ví dụ A/B/C.
10. Tự kiểm tra
- Q1Vì sao một attention head đơn lẻ không thể vừa bắt quan hệ ngữ pháp vừa bắt quan hệ đồng tham chiếu tốt như nhau? Giải thích bằng cơ chế Wq/Wk.
- Q2Nếu tăng số head H từ 8 lên 16 nhưng giữ nguyên d_model = 512, chuyện gì xảy ra với d_k của mỗi head? Đây có phải lúc nào cũng tốt hơn không?
- Q3Một đồng nghiệp nói: 'multi-head giống chạy cùng một model 8 lần rồi lấy trung bình, cho chắc ăn.' Nhận định này sai ở đâu?
- Q4Vai trò 'head nào học quan hệ gì' có được lập trình sẵn trong kiến trúc transformer không? Nếu không, nó đến từ đâu?
- Q5Sau khi các head tính xong attention riêng, bước tiếp theo model làm gì với H kết quả đó? Vì sao không dùng luôn kết quả của head 'tốt nhất'?
- Q6Giải thích tại sao nói bộ trọng số Wq_h/Wk_h/Wv_h của một head 'giống' trọng số w của một neuron ở Bài 01 Module 2, dù công thức tính khác nhau.
Bài tiếp theo: Transformer block — ghép các mảnh
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Query/Key/Value: attention là phép tra cứu mềm có trọng số
Bài tiếpTransformer block: ghép attention, FFN, residual thành khối
Thảo luận & góp ý
Hỏi đáp về bài này