Mini-challenge: đọc sơ đồ kiến trúc LLM
Cầm sơ đồ kiến trúc và model card của một LLM 7B giả định: chỉ ra khối transformer, giải nghĩa layers/heads/params/context bằng chính vốn từ vừa học.
TL;DR: Bài này đưa bạn model card và hai sơ đồ kiến trúc của một LLM giả định (VietLM-7B). Bạn tự đọc sơ đồ, giải nghĩa các con số layers/heads/params/context window bằng đúng vốn từ vừa học, rồi suy luận đánh đổi khi tăng context hay tăng một trục scaling. Bài không dạy khái niệm mới; kỹ năng cần luyện là tự đọc một tài liệu kiến trúc thật (như trang model trên Hugging Face) mà không cần ai diễn giải lại.
Tới đây bạn đã đủ vốn từ để đọc model card kèm sơ đồ kiến trúc của một LLM, đúng dạng bạn sẽ gặp trên trang model của Hugging Face hay README một checkpoint mở. Bài này đưa một bảng số và hai sơ đồ rồi hỏi ba câu. Cầm bút, thử trả lời cả ba trước khi mở phần Lời giải: kỹ năng cần luyện là tự đọc ra ý nghĩa, không phải nhận ra đáp án khi nhìn thấy nó.
🎯 Đề bài — model card của VietLM-7B
VietLM-7B là một cái tên giả định, dựng riêng cho bài này, không phải model của hãng nào. Các con số dưới đây được chọn đúng bậc độ lớn của một model 7 tỷ tham số ngoài đời, để bạn luyện tay trên một ca có đáp án rõ trước khi tự đọc model card thật.
| Thông số | Giá trị |
|---|---|
| Kiến trúc | Decoder-only Transformer |
Số lớp (layers) | 32 |
Số attention head mỗi lớp (heads) | 32 |
Chiều embedding (d_model) | 4096 |
Tổng tham số (params) | ~7 tỷ (7B) |
Độ dài ngữ cảnh (context window) | 8.192 token (~8k) |
Kích thước từ vựng (vocab) | ~64.000 token |
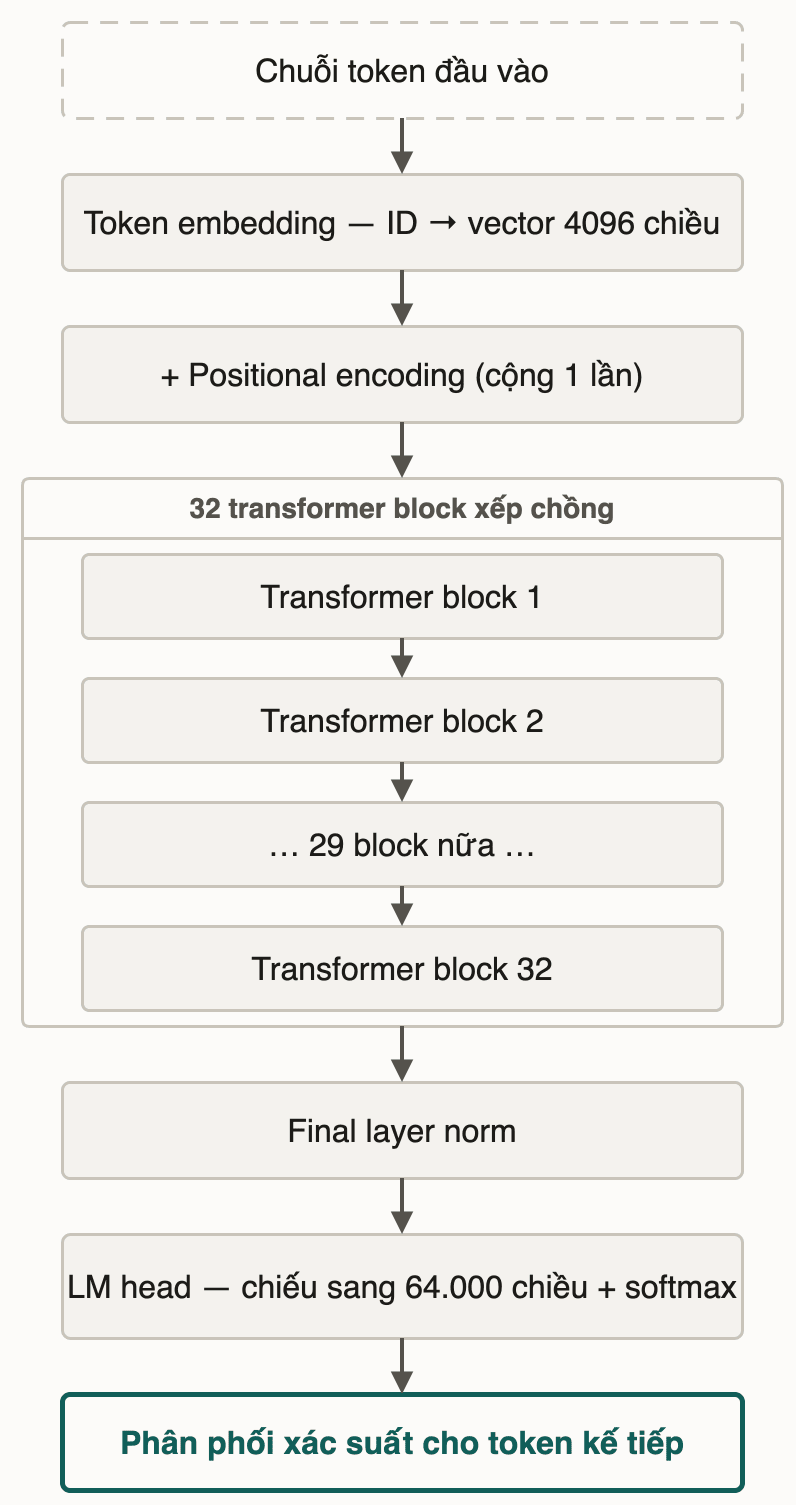
Sơ đồ dưới vẽ đường đi toàn cục của một chuỗi token qua model, từ lúc vào tới lúc ra một phân phối xác suất cho token kế tiếp:
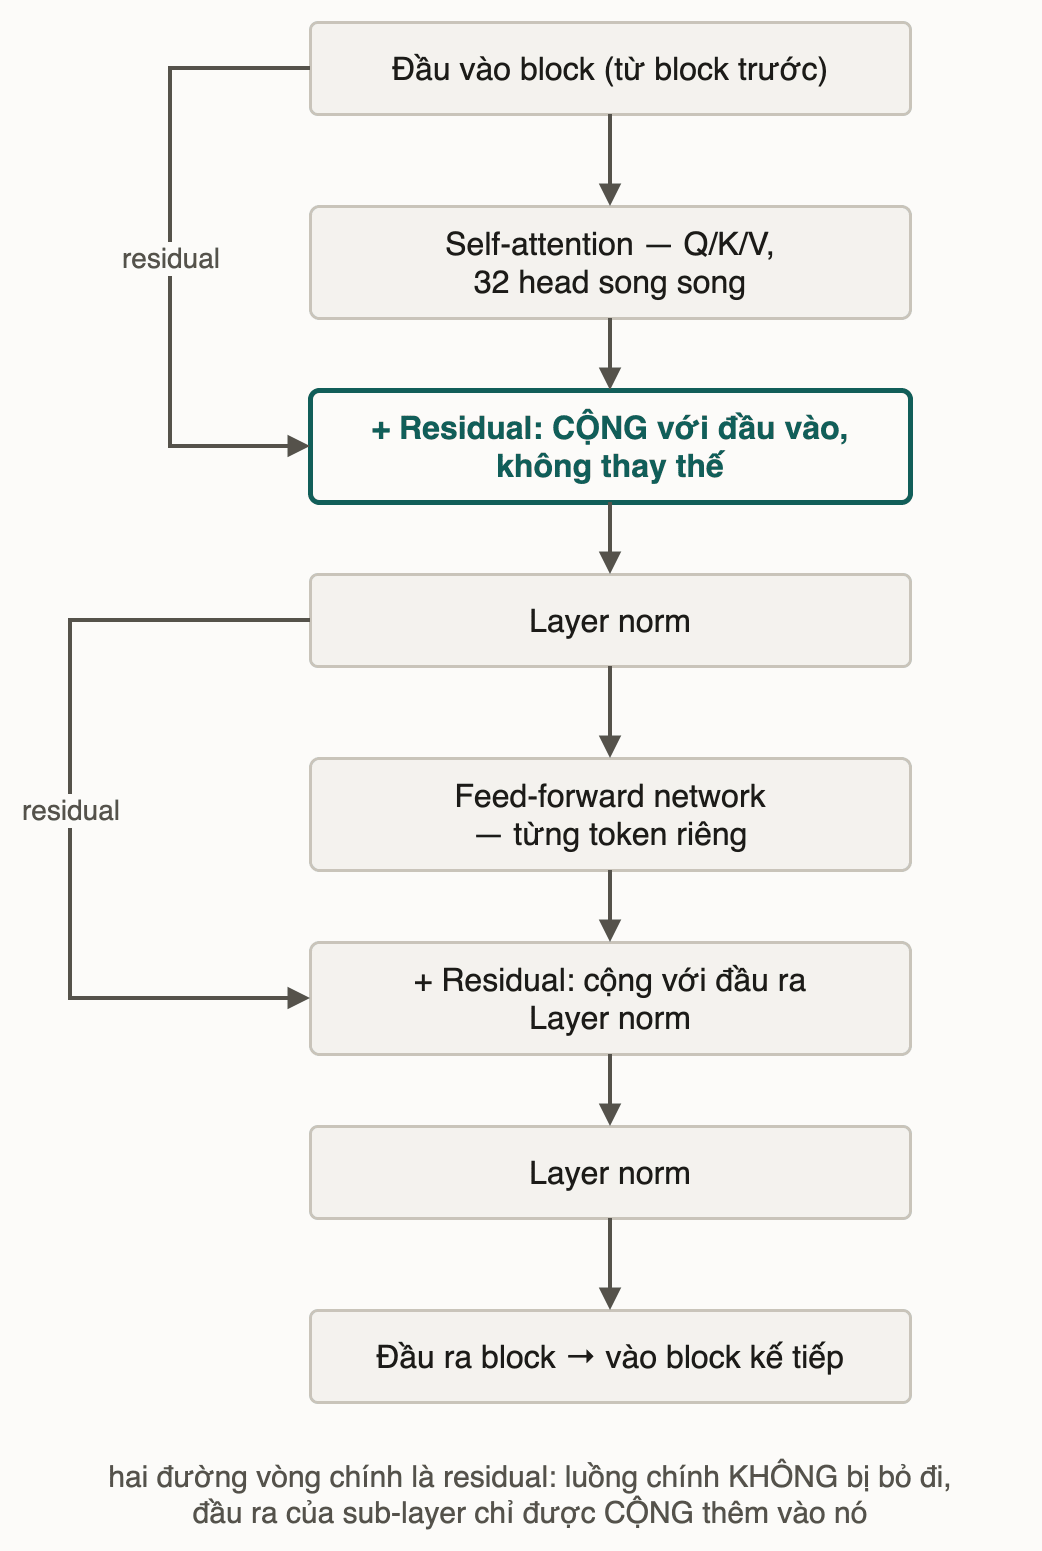
Và đây là bên trong một trong 32 block ở trên, phóng to:
🧭 Bộ công cụ — ôn nhanh bốn khái niệm
Bốn khái niệm dưới đây bạn đã học ở các bài trước. Đây là bản ôn tự đủ, không cần mở lại bài cũ để bắt đầu.
Mỗi token phát ra một truy vấn (Q), mỗi token khác (kể cả chính nó) trưng ra một khoá (K). Độ khớp giữa Q và từng K quyết định trọng số, dùng để pha trộn các giá trị (V) tương ứng thành biểu diễn attention của token đó: một phép tra cứu mềm, có trọng số, không phải khớp tuyệt đối như tra từ điển.
Trước block đầu tiên, positional encoding được cộng một lần vào embedding. Mỗi block sau đó xử lý: self-attention → cộng residual (+ layer norm) → FFN → cộng residual (+ layer norm). Xếp chồng N block như vậy, block sau nhận đầu ra của block trước, tạo thành toàn bộ mạng.
Loss giảm trơn theo ba trục params, data, compute, theo một đường cong thoải dần chứ không tuyến tính. Chinchilla chỉ ra: với cùng compute, tăng params mà số token train không tăng tương xứng thì model bị undertrained, phí compute.
Model chỉ nhìn được một cửa sổ token giới hạn mỗi request. Vượt cửa sổ đó thì thông tin bị cắt, và với model lúc sinh token tiếp theo, phần bị cắt coi như không tồn tại.
✍️ Phần việc của bạn
Ba nhiệm vụ độc lập, dùng đúng model card và hai sơ đồ ở trên:
Nhiệm vụ 1 — Đọc sơ đồ. Với từng khối trong hai sơ đồ (Token embedding, Positional encoding, Self-attention, hai đường Residual, Layer norm (x2 mỗi block), Feed-forward network, Final layer norm, LM head), viết một câu nói nó làm gì. Sau đó trả lời riêng: Token embedding và Positional encoding khác nhau ở đâu, và vì sao bước thứ hai là bắt buộc? Vì sao hai đường Residual được vẽ vòng qua self-attention/FFN thay vì nối thẳng vào luồng chính?
Nhiệm vụ 2 — Giải nghĩa model card. Với mỗi dòng trong bảng thông số, viết một câu giải thích con số đó đo cái gì, dùng đúng từ đã học ở module này (không tra định nghĩa ngoài, không chép nguyên văn bảng). Ví dụ về hình thức một câu (không phải đáp án): "layers là ___, đo bằng cách ___".
Nhiệm vụ 3 — Suy luận đánh đổi. Trả lời hai câu hỏi:
(a) Hai model cùng 7B tham số, một có context window 8k, một có 128k: phải trả giá gì để có context dài hơn?
(b) Muốn model "khôn hơn" theo nghĩa scaling laws đã học, bạn tăng trục nào, và mỗi lựa chọn trả giá bằng gì?
💡 Gợi ý
Chỉ là câu hỏi định hướng, không có con số chốt hay câu kết luận nào. Chưa viết xong phần việc ở trên thì quay lại làm trước.
- Nhiệm vụ 1:
Token embeddingbiến một token (một con số ID rời rạc) thành cái gì? Nếu chỉ có bước đó, self-attention có cách nào tự biết token nào đứng trước token nào không, hay nó chỉ thấy một tập token không thứ tự? Với residual: nhìn kỹ dấu+, nó cộng đầu ra của khối nào với đầu vào của khối nào, và luồng chính có bị bỏ đi không? - Nhiệm vụ 2:
layersliên hệ thế nào tới "xếp chồng N lớp" ở bài transformer block?headsliên hệ thế nào tới việc chạy song song nhiều "góc nhìn" attention?context windowliên hệ gì tới "bộ nhớ làm việc hữu hạn"?paramsđược cập nhật lúc nào, lúc train hay lúc chạy inference? - Nhiệm vụ 3(a): Self-attention so mỗi token với mọi token khác trong cửa sổ context. Độ dài chuỗi tăng thì số cặp token cần so tăng theo bậc gì, tuyến tính hay nhanh hơn? Còn thứ phải lưu lại cho mỗi token lúc sinh (KV cache) thì tăng theo bậc gì?
- Nhiệm vụ 3(b): Nhớ lại ba trục của scaling laws. Trục nào ảnh hưởng tới tốc độ và bộ nhớ lúc phục vụ (serving)? Trục nào cần dữ liệu chất lượng hơn chứ không chỉ nhiều hơn? Đường cong loss theo compute có tuyến tính không?
✅ Lời giải
Nhiệm vụ 1 — Đọc sơ đồ
Từng khối làm gì:
Token embedding: biến mỗi token (một ID rời rạc, số nguyên) thành một vector số thực dàid_model(ở đây 4096 chiều). Đây là bước duy nhất đổi ID của token thành một vector mà mạng tính toán được.Positional encoding: cộng thêm vào vector embedding một thông tin mã hoá vị trí của token trong chuỗi.Self-attention(trong mỗi block): mỗi token phátQ, mọi token phátK/V; 32 head chạy song song, mỗi head có bộ chiếu riêng nên có thể bắt một kiểu quan hệ khác nhau (ví dụ head này nghiêng về quan hệ chủ ngữ–động từ, head kia về đồng tham chiếu, dù trong model thật sự phân vai thường không gọn như vậy), rồi kết quả 32 head được ghép lại.Residual(cả hai chỗ): cộng thẳng đầu vào của một khối con (self-attention hoặc FFN) với đầu ra của chính khối con đó.Layer norm(x2 mỗi block): đi ngay sau mỗi phép cộng residual, đưa giá trị vector về một khoảng ổn định; khác vớiFinal layer normchỉ chạy một lần, sau block 32.Feed-forward network(FFN): biến đổi phi tuyến áp riêng cho từng vị trí token, không nhìn sang token khác; khác hẳn self-attention, bước duy nhất cho các token "nhìn" nhau.Final layer norm: chuẩn hoá vector đầu ra sau khi đi hết 32 block, trước khi chiếu sang không gian từ vựng.LM head: một phép chiếu tuyến tính từd_modelchiều sangvocabchiều (~64.000), rồisoftmaxbiến kết quả thành một phân phối xác suất hợp lệ (tổng bằng 1) cho token kế tiếp.
Token embedding vs Positional encoding: embedding chỉ mã hoá token đó là gì, không mang thông tin token đứng ở vị trí nào trong câu. Self-attention về bản chất là tổng có trọng số qua các token khác, và phép tổng đó không tự phân biệt "đứng trước" với "đứng sau". Vì vậy phải đưa vị trí vào tường minh: thiếu nó, ở kiến trúc gốc, đảo thứ tự cả câu đầu vào vẫn cho ra biểu diễn gần như y hệt, và model mất khả năng phân biệt "chó cắn người" với "người cắn chó". (Ở decoder-only như VietLM, causal mask có để lộ một phần thông tin vị trí, nhưng yếu và gián tiếp, nên LLM thật vẫn đưa vị trí vào tường minh.)
Vì sao residual vẽ vòng qua: dấu + trong sơ đồ nghĩa là đầu ra được cộng với đầu vào của chính khối con đó, không thay thế nó. Luồng chính (đầu vào gốc) vẫn đi tiếp, không bị bỏ; đường vòng residual là một "lối tắt" giữ nguyên tín hiệu gốc, để qua 32 lớp xếp chồng thông tin ban đầu không bị pha loãng hay mất dần, và gradient lúc train có đường chạy thẳng về các lớp đầu.
Nhiệm vụ 2 — Giải nghĩa model card
layers= 32: số block transformer xếp chồng; đầu ra của block 1 là đầu vào của block 2, cứ thế tới block 32. Đây chính là "N lớp" mà bài transformer block mô tả.heads= 32: trong mỗi lớp, self-attention không chạy một lần mà chạy song song 32 lần độc lập, mỗi lần với bộ chiếu riêng (một "góc nhìn"), rồi ghép kết quả 32 head thành một vector. Mỗi head làm việc trên 4096 / 32 = 128 chiều.d_model= 4096: độ dài vector biểu diễn mỗi token, giữ nguyên xuyên suốt mạng (từ embedding, qua từng block, tới trướcLM head); có thể hình dung là "bề rộng làn" chở thông tin của một token ở mỗi bước.params~7 tỷ: tổng số trọng số trong cả 32 lớp cộng embedding vàLM head. Đây là những con số được học (cập nhật dần qua gradient descent) lúc train; khi chạy inference chúng cố định, không đổi theo request.context window= 8k: số token tối đa self-attention nhìn được cùng lúc trong một request. Vượt ngưỡng này, token cũ bị đẩy ra ngoài cửa sổ, và với model lúc sinh token kế tiếp, phần bị đẩy ra coi như không tồn tại.vocab~64.000: số token khác nhau mà tokenizer có thể sinh ra, tức "bảng chữ cái" của model, và cũng là số chiều đầu ra củaLM headtrướcsoftmax.
Nhiệm vụ 3 — Suy luận đánh đổi
(a) 7B/8k so với 7B/128k: cùng 7 tỷ tham số nghĩa là hai model có cùng dung lượng "kiến thức" học được; khác biệt là cửa sổ attention nhìn được xa tới đâu. Cái giá tách thành hai trục khác nhau. Compute: self-attention phải so mỗi token với mọi token khác trong cửa sổ, nên số phép so tăng theo bậc hai (quadratic) theo độ dài chuỗi. Context 128k dài gấp 16 lần 8k, nên phần compute cho attention có thể tăng tới khoảng 256 lần (16²) nếu tính thuần quadratic; các kỹ thuật tối ưu attention thực tế giảm bớt phần này nhưng không xoá được xu hướng tăng nhanh. Bộ nhớ lúc phục vụ thì khác: phần chiếm RAM chủ yếu là KV cache, mỗi token thêm vào chỉ lưu thêm một cặp key/value kích thước cố định, nên KV cache tăng tuyến tính, đúng 16 lần khi context dài gấp 16 lần. Context dài không tự làm model "giỏi" hơn, nó chỉ nới phạm vi model được nhìn, và cái giá ở hai trục lệch hẳn nhau: compute tăng nhanh hơn nhiều so với bộ nhớ KV cache.
(b) Tăng trục nào để "khôn hơn": scaling laws có ba trục params, data, compute. Tăng params: model có nhiều trọng số hơn để biểu diễn quan hệ phức tạp hơn, nhưng lớn hơn, chậm hơn và tốn RAM hơn cả lúc train lẫn lúc serving. Tăng data: cần nhiều dữ liệu chất lượng hơn (không chỉ nhiều hơn về số lượng) và train lâu hơn tương ứng; theo Chinchilla, tăng params mà số token train không tăng cân xứng thì model undertrained, phí compute đã bỏ ra. Tăng compute: tiền, năng lượng và thời gian train đều tăng, và loss giảm theo đường cong thoải dần chứ không tuyến tính, càng về sau cùng một lượng compute thêm vào càng mua được ít cải thiện. Không trục nào "miễn phí": tăng trục nào cũng trả giá ở một khâu khác trong vòng đời model.
🎓 Mở rộng
- Tự đọc một model card thật. Mở trang Hugging Face của một model mở (ví dụ dòng Llama, Mistral, Qwen) và tìm đúng bảy con số vừa đọc (layers, heads, d_model, params, context window, vocab, kiến trúc). Con số nào khớp bậc độ lớn với VietLM-7B, con số nào lệch hẳn, và bạn đoán được vì sao model đó chọn khác không? Lưu ý: sơ đồ bài này theo kiến trúc gốc, positional encoding cộng một lần ở đầu vào; nhiều model thật (ví dụ họ Llama) dùng RoPE, áp thông tin vị trí lại ngay trong attention ở mỗi layer, nên đừng bối rối nếu model card thật không khớp y hệt chỗ này.
- Encoder-decoder vs decoder-only. VietLM-7B chỉ có decoder, đúng kiến trúc của phần lớn LLM chat hiện nay. Một số model dịch máy dùng kiến trúc encoder-decoder; thử tìm một model card như vậy và so sơ đồ khối của nó với sơ đồ bài này.
- Tự tính lại tổng tham số. Với
d_model= 4096,layers= 32, thử tra công thức ước lượng tham số của một block transformer (chủ yếu nằm ở các ma trậnQ/K/V/output projection của attention và hai ma trận của FFN) rồi xem con số tính ra có gần ~7 tỷ không. Tự tính lại luôn chắc hơn tin số liệu suông.
Thử ngẫmbạn vừa đọc xong một model card giả định. Nếu gặp model card thật ghi "grouped-query attention" thay vì multi-head attention thường, bạn sẽ tra thêm gì trước khi giả định nó hoạt động y hệt bài này?
✨ Điều bạn vừa làm được
- Đọc một sơ đồ kiến trúc transformer và nói đúng chức năng từng khối, kể cả lý do residual được vẽ như một đường vòng chứ không phải một bước biến đổi.
- Giải nghĩa cả bảy con số của một model card LLM bằng đúng vốn từ vừa học trong module (layers, heads, d_model, params, context window, vocab).
- Suy luận được hai đánh đổi thực tế: chi phí quadratic của context dài, và ba trục scaling laws không trục nào "miễn phí".
Bài tiếp theo: Tổng kết module — Transformer & attention
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Scaling laws — dự đoán loss khi tăng params, data, compute
Bài tiếpTổng kết: Transformer & attention
Thảo luận & góp ý
Hỏi đáp về bài này