Tổng quan: Transformer & attention
Bản đồ module: từ giới hạn của model đọc tuần tự, qua attention và transformer block, đến decoder-only LLM và scaling laws — đủ để đọc sơ đồ kiến trúc.
TL;DR: Module này trả lời một câu hỏi: bên trong một LLM, chuyện gì xảy ra khi nó "đọc" câu của bạn? Đường đi có sáu chặng nối nhau. Model đọc tuần tự kiểu cũ nghẽn ở phụ thuộc xa và không song song hoá được khi train. Attention gỡ cả hai bằng phép tra cứu query/key/value, cho mỗi token tự "hỏi" các token khác. Nhiều attention head chạy song song bắt nhiều kiểu quan hệ, rồi ghép cùng feed-forward network và residual connection thành một transformer block, xếp chồng N lớp. Causal mask biến kiến trúc đó thành decoder-only LLM: train song song mọi vị trí, inference vẫn sinh từng token một. Cuối module, scaling laws cho biết thêm params/data/compute thì loss đổi theo quy luật nào, và bạn tự đọc được một sơ đồ kiến trúc LLM.
Bước "nhìn context" bên trong model diễn ra thế nào?
Ở Module 3 (Cỗ máy LLM), bạn đã lần theo vòng lặp sinh văn bản (tokenize, nhìn context, dự đoán phân phối xác suất, sample, decode), nhưng bước "nhìn context" được coi như hộp đen: model cứ thế "biết" token nào trong câu liên quan đến token nào. Module này mở đúng cái hộp đó.
Trước 2017, mở hộp ra sẽ thấy một model đọc tuần tự (RNN, về sau là LSTM/GRU): đọc từng token, nén lịch sử vào một trạng thái ẩn kích thước cố định. Cách đó có hai giới hạn lớn: phụ thuộc ở xa bị phai dần, và train không song song hoá được vì bước t phải chờ bước t-1. Attention xuất hiện từ 2014 như một phần gắn thêm vào RNN; paper "Attention Is All You Need" (Vaswani et al., 2017) đi xa hơn, bỏ hẳn RNN và dựng cả kiến trúc chỉ bằng attention. Từ đó GPT, Claude, Llama, Gemini, mọi LLM bạn đang dùng, đều là biến thể của cùng một kiến trúc: transformer.
Học xong module này, một sơ đồ kiến trúc hay một dòng trong model card ("32 layers, 32 heads, context 8K") không còn là chữ trang trí. Bạn đọc ra nó đang mô tả cơ chế nào, và vì sao đổi một con số trong đó (tăng heads, tăng layers, tăng params) lại đổi hành vi model theo hướng đoán trước được.
Sau module này bạn sẽ
- Explain vì sao kiến trúc đọc tuần tự nghẽn với phụ thuộc xa và không song song hoá được khi train, và attention gỡ giới hạn đó thế nào
- Explain vai trò query/key/value trong một attention head và vì sao nhiều head song song bắt được nhiều kiểu quan hệ
- Trace đường đi của một token qua transformer block: positional encoding → self-attention → FFN → residual, xếp chồng N lớp
- Trace vòng lặp next-token của decoder-only LLM: causal mask cho phép train song song, inference sinh từng token
- Predict hệ quả định tính của scaling laws khi tăng params, data, compute
- Analyze sơ đồ kiến trúc và model card của một LLM thật bằng vốn từ transformer
Lộ trình module
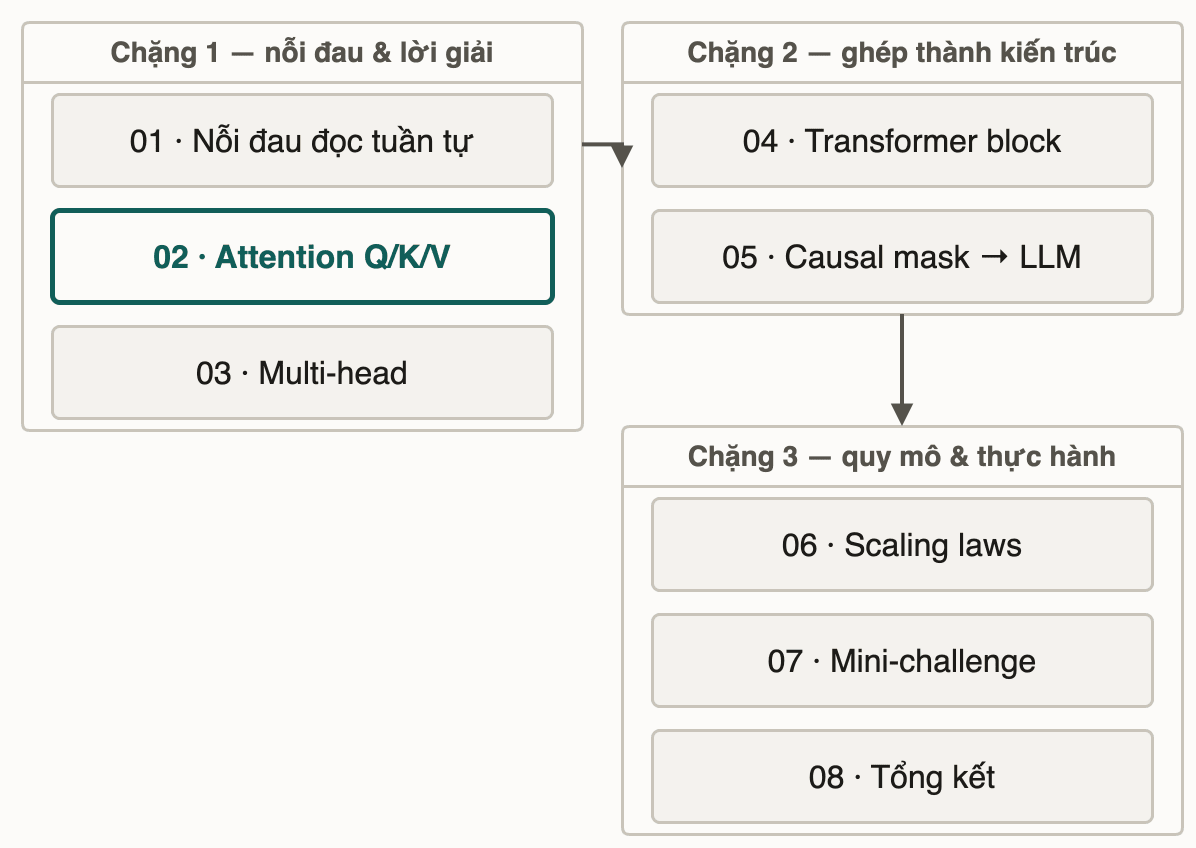
Sáu bài concept (01–06) đi theo một mạch, không đảo thứ tự được. Bài 01 dựng lại hai giới hạn của model đọc tuần tự. Đây là động lực chứ không phải kiến thức nền để học thuộc: mọi cơ chế phía sau tồn tại để gỡ hai giới hạn này. Bài 02 giới thiệu attention như một phép tra cứu mềm: query/key/value. Bài 03 cho thấy một attention head chỉ bắt được một kiểu khớp, nên cần nhiều head song song; tới đây "nhiều góc nhìn" của multi-head mới thành thứ cần thiết chứ không phải tuỳ chọn.
Bài 04 ghép attention với positional encoding và FFN thành một transformer block hoàn chỉnh, rồi xếp chồng N lớp; hết bài này bạn có trọn kiến trúc transformer gốc. Bài 05 hỏi tiếp: kiến trúc đó biến thành LLM sinh văn bản (kiểu GPT) thế nào? Câu trả lời là causal mask, một ràng buộc nhỏ giúp train song song được trong khi inference vẫn tuần tự, nối thẳng về vòng lặp next-token ở Module 3. Bài 06 lùi ra xa hơn: khi kiến trúc này được scale lên (nhiều params, nhiều data, nhiều compute hơn), loss đổi theo quy luật nào. Đó là scaling laws, đọc định tính, không cần công thức.
Bài 07 là mini-challenge, không dạy khái niệm mới. Nó đưa model card của một LLM giả định có số liệu sát model 7B thật, bắt bạn tự chỉ ra khối transformer và giải nghĩa layers/heads/params/context bằng vốn từ vừa học trước khi xem lời giải. Bài 08 gom các mảnh vào một cheat sheet và phần tự đánh giá theo sáu learning outcome ở trên.
Yêu cầu trước khi bắt đầu
- Nên học xong Module 2 (Não nhân tạo vừa đủ) và Module 3 (Cỗ máy LLM) trước: attention là câu trả lời cho câu hỏi Module 3 để ngỏ ("model nhìn context bằng cách nào"), còn trọng số và neuron ở Module 2 là nền để hiểu "học được" nghĩa là gì.
- Nếu nhảy thẳng vào đây, ba điều tối thiểu cần biết trước bài 01:
- Token là đơn vị nhỏ nhất model xử lý (không phải ký tự, cũng không hẳn là từ). Mỗi token được model biểu diễn bằng một vector số gọi là embedding.
- Model dự đoán một phân phối xác suất cho token kế tiếp rồi sample ra một token, lặp lại để sinh cả câu. Causal mask ở bài 05 giải thích vòng lặp đó được train thế nào.
- Weight (trọng số) là con số được học qua train, không phải luật viết tay; "học" nghĩa là chỉnh dần các trọng số này.
- Không cần biết code ML, không cần Python. Pseudocode trong bài đọc được bằng logic lập trình thông thường.
Time budget
| Bài | Chủ đề | Thời lượng |
|---|---|---|
| 00 | Tổng quan (bài này) | ~5 phút |
| 01 | Giới hạn của model đọc tuần tự | ~12 phút |
| 02 | Attention: tra cứu có trọng số (Q/K/V) | ~13 phút |
| 03 | Multi-head: nhiều góc nhìn | ~11 phút |
| 04 | Transformer block | ~13 phút |
| 05 | Từ transformer đến LLM (causal mask) | ~13 phút |
| 06 | Scaling laws định tính | ~12 phút |
| 07 | Mini-challenge: đọc sơ đồ kiến trúc | ~15 phút |
| 08 | Tổng kết & cheat sheet | ~6 phút |
| Tổng | ~1 giờ 40 phút |
Cách học module này hiệu quả
- Đừng học bài 03 tách khỏi bài 02. Multi-head chỉ có nghĩa khi bạn đã thấy giới hạn của một head đơn (bài 02); học ngược thứ tự thì "nhiều head" trông như chi tiết kỹ thuật vô cớ chứ không phải lời giải cho một giới hạn cụ thể.
- Bài 05 nối thẳng về Module 3. Nếu vòng lặp next-token (tokenize → context → dự đoán → sample) ở Module 3 bài 01 đã mờ, đọc lại trước khi vào bài 05, vì causal mask chỉ trọn nghĩa khi đặt cạnh vòng lặp đó.
- Làm nghiêm túc mọi bước "Thử đoán". Phần lớn bài dừng lại bắt bạn dự đoán trước khi đọc giải thích; đó là cách kiểm tra bạn hiểu cơ chế hay chỉ nhớ tên.
- Bài 07 là lúc kiểm tra thật. Không giải nghĩa được một mục trong model card thì quay lại đúng bài tương ứng (02/03/04/05) đọc lại phần cơ chế trước khi xem lời giải, đừng đoán tiếp.
Bài tiếp theo: Giới hạn của model đọc tuần tự
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tổng kết: Cỗ máy LLM
Bài tiếpGiới hạn của model đọc tuần tự trước khi có transformer
Thảo luận & góp ý
Hỏi đáp về bài này