Giới hạn của model đọc tuần tự trước khi có transformer
Trước transformer, model đọc văn bản từng token một: phụ thuộc xa bị quên dần, train không song song hoá được. Đó là hai giới hạn attention sẽ gỡ.
TL;DR: Trước transformer, model đọc tuần tự (RNN-style) đọc từng token một, mỗi bước nén toàn bộ những gì đã đọc vào một hidden state kích thước cố định. Cách nén này sinh ra hai giới hạn độc lập. Thứ nhất, thông tin ở xa phai dần: một trạng thái cố định phải chứa lịch sử ngày càng dài, nên thông tin cũ bị pha loãng sau mỗi lần nén. Thứ hai, train không song song hoá được theo chiều dài chuỗi: bước t phải chờ bước t-1 xong, nên GPU dù nhiều nhân vẫn phần lớn ngồi chờ. Hai giới hạn này là động lực trực tiếp để transformer ra đời, với attention làm trung tâm (bài sau).
Một đội kỹ sư ở công ty fintech thử dựng trợ lý tóm tắt cuộc gọi chăm sóc khách hàng (môi trường UAT, dữ liệu ẩn danh, chưa lên production) bằng kiến trúc đọc tuần tự kiểu cũ, loại nhiều hệ thống NLP từng dùng trước khi transformer phổ biến. Một bản ghi cuộc gọi dài 46 câu, khoảng 640 từ, được đưa vào để tóm tắt thành 2-3 câu.
Câu đầu bản ghi nói rõ: "Chị Hạnh, chủ tài khoản doanh nghiệp mã KH-77821, gọi lên vì phát hiện một giao dịch lạ trừ 12 triệu đồng tối hôm qua." Hơn 30 câu tiếp theo xoay quanh xác minh danh tính, tra soát giao dịch, và một khách hàng khác mà nhân viên tổng đài lấy làm ví dụ để giải thích quy trình. Câu áp chót: "Vậy chị xác nhận muốn khoá thẻ tạm thời trong lúc chờ tra soát đúng không?" Bản tóm tắt gán nhầm yêu cầu khoá thẻ cho khách hàng trong ví dụ minh hoạ thay vì chị Hạnh, người mở đầu cuộc gọi. Lỗi này lặp lại ở nhiều bản ghi dài tương tự, không phải ca cá biệt.
Đây không phải lỗi thiếu dữ liệu train hay model "chưa đủ thông minh". Lỗi nằm sẵn trong cách kiến trúc đọc tuần tự xử lý chuỗi dài: nó nén dần lịch sử vào một trạng thái có sức chứa hữu hạn, nên thông tin xuất hiện sớm buộc phải chia chỗ với mọi thứ đến sau. Bài này đi vào đúng cơ chế đó, cùng một giới hạn thứ hai đi kèm.
Module 3 bài 01: LLM sinh văn bản bằng vòng lặp autoregressive. Mỗi bước, model nhìn toàn bộ chuỗi token đã có, dự đoán phân phối xác suất cho token kế tiếp, sample một token, nối vào cuối, rồi lặp lại. Đó là câu trả lời cho model tạo output theo trình tự nào, và vẫn đúng với transformer. Bài này hỏi chuyện khác: bên trong một bước dự đoán, model đọc chuỗi đã có bằng cơ chế gì? Trước transformer, câu trả lời là đọc tuần tự, nén dần vào một trạng thái cố định, và chính cách đó gây ra hai giới hạn dưới đây.
1. Analogy: tóm tắt cả cuốn sách trên một tấm thẻ ghi chú
Cứ hình dung bạn phải tóm tắt một cuốn sách 400 trang, nhưng chỉ được ghi chú lên đúng một tấm thẻ 200 ô, không được thêm thẻ mới. Đọc xong mỗi trang, bạn phải sửa lại chính tấm thẻ đó: giữ vài ý cũ, xoá bớt để có chỗ cho ý mới. Tới trang 400, tấm thẻ vẫn chỉ có 200 ô mà phải đại diện cho cả 400 trang đã đọc.
Ý quan trọng ở trang 1 có còn nguyên tới trang 400 không? Mỗi lần sửa thẻ đều có rủi ro ghi đè, nên sau hàng trăm lần sửa liên tiếp, khả năng ý ở trang 1 còn nguyên vẹn giảm dần theo cấp số nhân. Bạn không cố quên; chính cách làm "một thẻ, sửa liên tục" đã dẫn tới chuyện đó.
Ràng buộc thứ hai: bạn phải đọc tuần tự. Muốn sửa thẻ ở trang 50 thì phải sửa xong ở trang 49, và gọi thêm 10 người cũng vô ích vì chỉ có một tấm thẻ.
| Đọc sách qua một tấm thẻ nhớ | Model đọc tuần tự (RNN-style) |
|---|---|
| Tấm thẻ nhớ, đúng 200 ô, không thêm được | Hidden state h_t, kích thước vector cố định |
| Đọc xong 1 trang, sửa lại thẻ cũ | h_t được tính từ h_(t-1) và token mới, ghi đè trạng thái cũ |
| Ý ở trang 1 dần mờ sau hàng trăm lần sửa | Thông tin token đầu phai dần sau hàng trăm bước nén — Giới hạn 1 |
| Phải đọc xong trang 49 mới được sửa thẻ ở trang 50 | Phải tính xong h_(t-1) mới tính được h_t — Giới hạn 2 |
| Gọi thêm người đọc cũng không giúp — vẫn phải xếp hàng | Thêm GPU cũng không giúp — các bước theo thời gian vẫn phải tuần tự |
2. Vì sao thông tin ở xa bị phai dần?
Model đọc tuần tự xử lý một chuỗi token bằng một công thức lặp y hệt ở mọi bước: cùng một hàm f, cùng một bộ trọng số, áp dụng liên tiếp.
h_0 <- trạng thái rỗng (chưa đọc gì)
for t = 1 to N:
    h_t <- f(h_(t-1), token_t)     -- nén token mới vào trạng thái cũ
// h_N là trạng thái cuối cùng, đại diện cho CẢ N token đã đọc
// Time: O(N) bước tuần tự   Space: O(1) cho hidden state (kích thước cố định)
Điểm mấu chốt nằm ở dòng comment cuối: h_t luôn có cùng một kích thước, bất kể t là 1 hay 1000. Ở t = 800, h_800 phải đại diện cho cả 800 token đã đọc trong khi kích thước vector không tăng chút nào. Token đầu tiên không "giữ nguyên" một chỗ cố định trong h_t: nó bị trộn và ghi đè qua từng lần áp dụng f, giống tấm thẻ bị sửa 800 lần liên tiếp.
Mỗi lần áp dụng f thường là nhân với một ma trận trọng số rồi ép qua một hàm phi tuyến (như tanh). Lặp lại cùng phép biến đổi đó nhiều lần thì phần đóng góp của token ở xa co lại dần: khi chạy forward, thông tin từ token đầu bị pha loãng qua từng bước. Lúc train còn có một vấn đề cùng gốc nhưng khác chỗ: tín hiệu học (gradient) chạy ngược từ cuối chuỗi về đầu cũng bị nhân qua từng đó bước nên co lại theo cấp số nhân, gọi là vanishing gradient, khiến model khó học được rằng token đầu quan trọng. Hai chuyện này cộng lại là hệ quả của việc nén một chuỗi dài tuỳ ý vào một vector kích thước cố định, không phải lỗi cài đặt.
LSTM (1997) và GRU (2014) ra đời để giảm đúng vấn đề này: chúng thêm các "cổng" cho model tự chọn giữ hay xoá thông tin, nhờ đó giữ phụ thuộc xa tốt hơn hẳn RNN trơn. Nhưng chúng vẫn nén vào một trạng thái cố định và vẫn chạy tuần tự, nên chỉ đẩy giới hạn ra xa chứ không gỡ được nó.
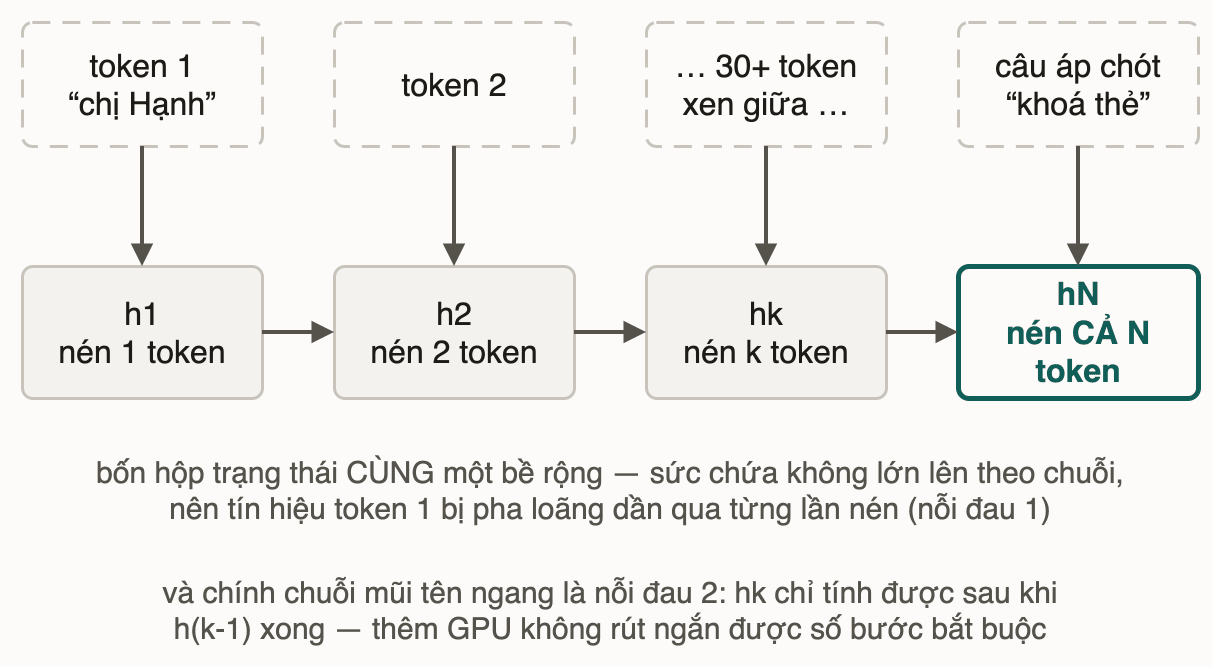
Đây là nguyên nhân của lỗi tóm tắt đầu bài. token 1 mang thông tin "chị Hạnh mở đầu cuộc gọi" phải qua hơn 30 lần nén mới tới câu áp chót, nên dấu vết về chị Hạnh đã loãng hơn nhiều so với khách hàng được nhắc gần cuối, và model gán nhầm người. Tăng kích thước hidden state chỉ làm chậm tốc độ phai, không xoá được nó.
Thử ngẫmphiên dịch một bài phát biểu 20 phút bằng đúng lối đọc tuần tự này. Diễn giả nêu một chính sách ở phút 2 rồi nhắc lại bằng đại từ ở phút 18: đại từ đó có nguy cơ bị dịch sai không?
3. Vì sao train không song song hoá được?
Giới hạn thứ hai độc lập với giới hạn thứ nhất, nhưng cùng xuất phát từ một dòng công thức ở mục 2: h_t <- f(h_(t-1), token_t). Muốn tính h_t thì bắt buộc phải có h_(t-1) trước.
GPU có hàng nghìn nhân tính toán (core), nhưng một chuỗi RNN chỉ cho phép:

step 1: h1 <- f(h0, token1)        // phải xong trước khi step 2 bắt đầu
step 2: h2 <- f(h1, token2)        // chờ step 1, không thể tính sớm hơn
step 3: h3 <- f(h2, token3)        // chờ step 2
...
step N: hN <- f(h(N-1), tokenN)    // chờ step N-1

// Time: O(N) bước TUẦN TỰ bắt buộc, dù có bao nhiêu core cũng vậy
// Mỗi step chỉ là MỘT phép nhân ma trận nhỏ -- phần lớn core GPU đứng yên
Chỗ dễ hiểu lầm: train theo batch nhiều câu cùng lúc vẫn song song bình thường. GPU tính h_t của câu A và câu B cùng lúc không sao, vì hai câu độc lập. Giới hạn nằm ở chiều thời gian bên trong một câu: bước t của MỖI câu vẫn phải chờ bước t-1 của chính câu đó. Bản ghi 640 từ tách ra khoảng 800 token thì cần tối thiểu 800 bước tính tuần tự mới ra h_800, và con số đó không giảm dù thêm bao nhiêu GPU, vì đây là một chuỗi phụ thuộc chứ không phải khối việc chia nhỏ được.
4. Transformer ra đời để gỡ đúng hai giới hạn này ra sao?
Hai giới hạn ở mục 2 và 3 không phải suy diễn riêng của bài này. Attention đã xuất hiện từ trước, trong công trình dịch máy của Bahdanau và cộng sự năm 2014 (arXiv:1409.0473): họ gắn attention vào một RNN để bộ dịch được nhìn lại mọi từ của câu nguồn thay vì chỉ dựa vào một vector nén. Cách đó giảm được giới hạn thứ nhất, nhưng RNN vẫn còn đó nên giới hạn thứ hai giữ nguyên.
Bước tiếp theo là bài báo đặt nền cho transformer: Vaswani và cộng sự, "Attention Is All You Need" (arXiv:1706.03762). Nhóm tác giả mô tả các model xử lý chuỗi phổ biến nhất lúc đó dựa trên mạng hồi quy hoặc mạng tích chập phức tạp, rồi đề xuất một kiến trúc dựa hoàn toàn trên attention, bỏ hẳn cả hồi quy lẫn tích chập, nhờ vậy song song hoá được tốt hơn và train nhanh hơn đáng kể.
Điều này khớp đúng hai giới hạn vừa phân tích: bỏ hồi quy gỡ giới hạn ở mục 3 (bước t không còn chờ t-1), còn bỏ việc nén tuần tự vào trạng thái cố định mở đường gỡ giới hạn ở mục 2 (token "nhìn" thẳng token khác ở bất kỳ khoảng cách nào). Cơ chế cụ thể, attention, là chủ đề bài sau.
5. Pitfall tổng hợp
❌ Nhầm 1: tăng kích thước hidden state là hết nghẽn.
✅ Tăng hidden state chỉ hoãn chuyện phai phụ thuộc xa, không gỡ bản chất nén vào kích thước cố định: chuỗi đầu vào luôn có thể dài hơn bất kỳ kích thước nào chọn trước (mục 2).
❌ Nhầm 2: RNN không song song được gì hết.
✅ RNN vẫn song song theo BATCH: nhiều câu chạy cùng lúc, nhiều GPU tính độc lập không sao. Thứ không song song được là THEO CHIỀU DÀI CHUỖI: bên trong một câu, bước t phải chờ bước t-1 (mục 3).
6. Liên hệ các bài khác
- Bài 01 module 3 — Dự đoán token kế tiếp: bài đó dựng vòng lặp autoregressive nhưng coi bước "nhìn context" là hộp đen; bài này bắt đầu mở hộp đen đó, từ cách đọc tuần tự trước khi có transformer.
- Bài 02 — Attention: truy vấn có trọng số: nơi attention gỡ cả hai giới hạn vừa nêu.
7. Tóm tắt
- Công thức
h_t <- f(h_(t-1), token_t)là gốc chung của cả hai giới hạn: một trạng thái cố định, và một chuỗi phụ thuộc. - Chuyện phai khi forward và vanishing gradient khi train là hai mặt khác nhau của cùng việc lặp một phép biến đổi nhiều lần.
- LSTM/GRU và attention gắn vào RNN (2014) giảm được chuyện phai, nhưng vẫn tuần tự.
- 800 token cần tối thiểu 800 bước tuần tự; thêm GPU chỉ làm mỗi bước nhanh hơn, không giảm số bước.
8. Tự kiểm tra
- Q1Vì sao kích thước CỐ ĐỊNH của hidden state lại là nguyên nhân sâu xa khiến thông tin ở xa bị phai, chứ không đơn giản là "model quên"?
- Q2Nếu tăng kích thước hidden state lên gấp 10 lần, chuyện phai phụ thuộc xa có biến mất hoàn toàn không? Giải thích.
- Q3Vì sao việc train theo batch nhiều câu cùng lúc KHÔNG giải quyết được chuyện song song hoá bên trong một chuỗi?
- Q4Với một chuỗi 800 token, model đọc tuần tự cần tối thiểu bao nhiêu bước tính tuần tự để ra được
h_800? Vì sao con số này không giảm được dù thêm GPU? - Q5Giải thích cơ chế khiến trợ lý tóm tắt cuộc gọi trong tình huống đầu bài gán nhầm yêu cầu khoá thẻ cho sai khách hàng.
- Q6Attention (bài sau) được mô tả là cơ chế cho mỗi token "nhìn thẳng" mọi token khác. Dựa vào hai giới hạn vừa học, dự đoán vì sao thiết kế đó có thể gỡ cả hai cùng lúc.
Bài tiếp theo: Attention — truy vấn có trọng số, cơ chế cho mỗi token "nhìn thẳng" mọi token khác thay vì đọc tuần tự qua một trạng thái nén cố định như bài này.
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tổng quan: Transformer & attention
Bài tiếpQuery/Key/Value: attention là phép tra cứu mềm có trọng số
Thảo luận & góp ý
Hỏi đáp về bài này