Scaling laws — dự đoán loss khi tăng params, data, compute
Thêm params, data, compute thì loss giảm theo quy luật trơn — và Chinchilla chỉ ra model to mà train thiếu token là phí compute. Đọc định tính, không công thức.
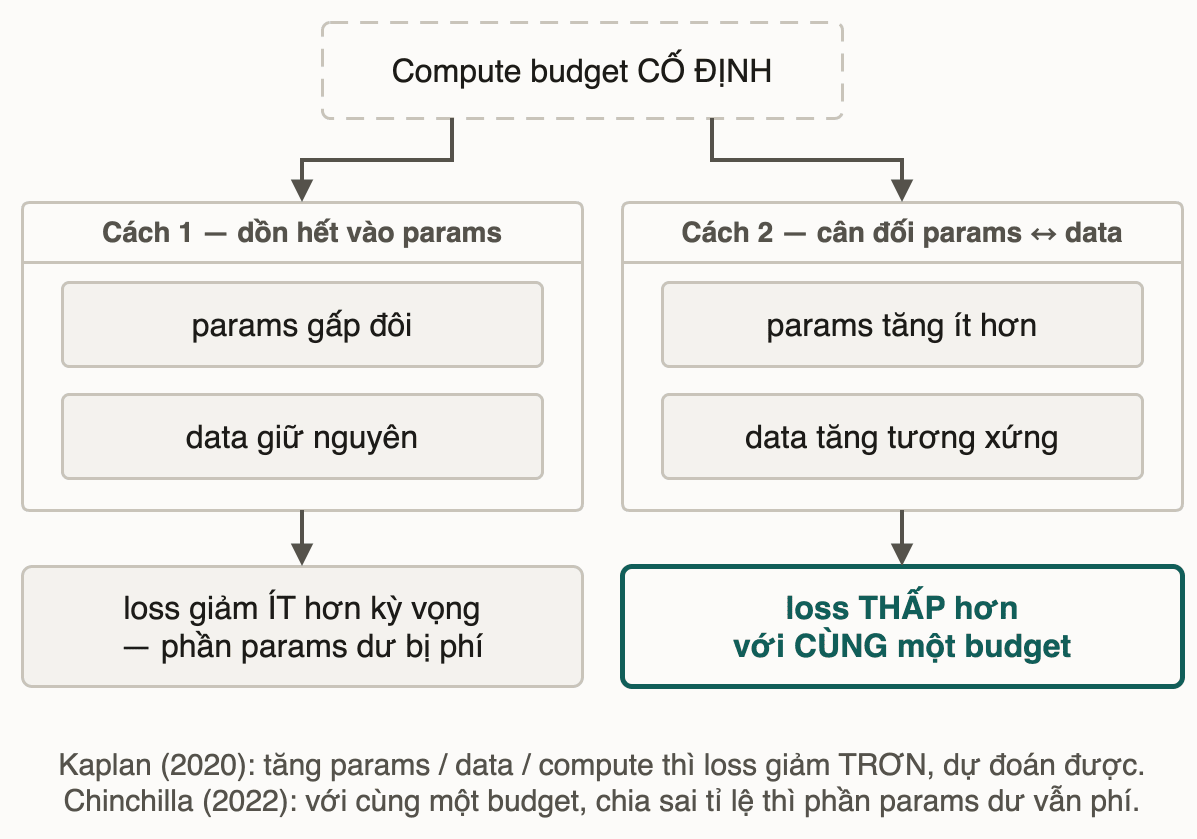
TL;DR: Kaplan et al. (2020) quan sát: loss giảm trơn và dự đoán được khi tăng params, data hoặc compute, qua nhiều bậc quy mô. Hoffmann et al. (2022), nghiên cứu Chinchilla, chỉ ra điều thực dụng hơn: với một compute budget cố định, có một điểm cân đối giữa số params và số token train. Compute xấp xỉ tỉ lệ với params × token, nên dồn budget vào model to hơn thì số token train được giảm tương ứng; model to mà train thiếu token là undertrained, loss cao hơn so với một model nhỏ hơn train trên nhiều token hơn với cùng budget. Hệ quả: data chất lượng thành nút thắt thật sự, và "to hơn là tốt hơn" chỉ đúng khi số token train tăng theo.
Bạn nghe hai lời khuyên tưởng như cãi nhau: "cứ scale model lên, loss sẽ giảm" và "nhiều model đang to quá so với lượng data chúng được train". Cả hai đều đúng, mỗi lời một nửa, và cách nhau hai năm nghiên cứu.
Model đọc tuần tự vẫn song song hoá được theo batch, nhưng không song song hoá được THEO CHIỀU DÀI CHUỖI khi train, vì mỗi bước phải đợi bước trước. Transformer gỡ đúng nút thắt đó, nên đổ một khối compute lớn vào một lần train trở nên rẻ và nhanh hơn nhiều. Đó là điều kiện để các thí nghiệm quy mô lớn ở bài này khả thi, và để các quy luật scaling lộ ra.
1. Analogy: nhà máy với số vốn cố định
Bạn được giao một khoản vốn cố định để vận hành xưởng giày trong một năm. Vốn đó chia làm hai: mua máy (bao nhiêu dây chuyền) và mua nguyên liệu (da, vải, đế) cho máy chạy. Dồn gần hết tiền vào máy thì còn rất ít nguyên liệu: phần lớn dây chuyền đứng không, số giày làm ra ít. Dồn hết vào nguyên liệu mà chỉ có một dây chuyền thì nguyên liệu chất đống, cũng làm ra ít giày. Ở giữa có một cách chia cho ra nhiều giày nhất trên cùng số vốn.
| Đời thường | Scaling laws |
|---|---|
| Vốn cố định cả năm | Compute budget cố định |
| Số dây chuyền, số máy | Số params (dung lượng model) |
| Nguyên liệu cho máy chạy | Số token dữ liệu dùng để train |
| Nhiều máy, ít nguyên liệu: máy đứng không | Model to nhưng train thiếu token: undertrained |
| Một máy, núi nguyên liệu: làm không kịp | Model quá nhỏ: có nhiều token nhưng không đủ dung lượng để học hết |
| Cách chia cho ra nhiều giày nhất | Điểm compute-optimal: loss thấp nhất với cùng budget |
Params là "dung lượng có thể học", token train là thứ lấp đầy dung lượng đó. Cùng một budget, thêm cái này thì bớt cái kia; loss thấp nhất nằm ở chỗ cân đối.
2. Kaplan et al. phát hiện gì về loss khi scale?
Năm 2020, Kaplan và cộng sự công bố "Scaling Laws for Neural Language Models". Họ đo loss của hàng loạt model ở nhiều quy mô, thay đổi lần lượt từng trục: số params, lượng data và compute (tổng khối lượng tính toán bỏ ra để train). Phát hiện chính: tăng trục nào trong ba trục đó thì loss cũng không giảm lung tung, mà giảm theo một đường trơn và dự đoán được, giữ ổn định qua nhiều bậc quy mô. Trước đó không ai chắc train model lớn hơn có cải thiện đều đặn hay chỉ là trò may rủi; tính dự đoán được biến việc đổ compute khổng lồ vào training thành một quyết định đầu tư có cơ sở.
Quy luật này lộ ra được một phần nhờ transformer. Như recall ở trên, transformer tận dụng phần cứng tốt hơn hẳn cho chuỗi dài, nên chạy được hàng loạt thí nghiệm lớn với chi phí và thời gian chấp nhận được; chính khối thí nghiệm đó cho Kaplan đủ điểm dữ liệu để vẽ ra quy luật.
Kaplan cũng đưa ra một khuyến nghị: khi có thêm compute, nên tăng params nhanh hơn tăng data. Hai năm sau, khuyến nghị đó bị xem lại.
3. Gấp đôi model mà giữ nguyên budget thì sao?
Trước hết cần một con số để khỏi mơ hồ. Với transformer, compute để train xấp xỉ 6 × số params × số token train (đơn vị FLOP). Nghĩa là budget cố định thì params và token là hai đầu của một chiếc bập bênh: tăng params gấp đôi thì số token train được giảm còn một nửa.
Bạn giữ nguyên compute budget. Phương án A: model như hiện tại, train trên N token. Phương án B: model gấp đôi params, vì vậy chỉ train được N/2 token. Viết ra dự đoán trước khi đọc tiếp: phương án nào cho loss thấp hơn? Có phải model to hơn luôn thắng?
Nhớ lấy dự đoán đó, mục sau có bằng chứng để đối chiếu.
4. Chinchilla chỉ ra điều gì về cách chia params và token?
Năm 2022, Hoffmann và cộng sự công bố "Training Compute-Optimal Large Language Models", thường gọi là nghiên cứu Chinchilla theo tên model thí nghiệm. Câu hỏi của họ: với một compute budget cố định, nên chia bao nhiêu cho params và bao nhiêu cho token train để loss thấp nhất?
Họ train hơn 400 model ở nhiều cỡ và thấy: ở mỗi mức compute, vẽ loss theo cỡ model thì ra một đường hình chữ U. Model quá nhỏ thì thừa token mà thiếu dung lượng, loss cao; model quá to thì chỉ train được ít token, chưa kịp học hết dung lượng của nó, loss cũng cao; đáy chữ U là điểm compute-optimal. Theo ước lượng của họ, khi compute tăng thì params và token nên tăng cùng tốc độ, chứ không nghiêng về params như Kaplan khuyến nghị. Một quy tắc nhẩm hay được trích từ kết quả này là khoảng 20 token train cho mỗi params.
Bằng chứng thẳng nhất: Chinchilla 70 tỷ params, train trên 1,4 nghìn tỷ token, dùng cùng mức compute với Gopher 280 tỷ params train trên 300 tỷ token, vậy mà Chinchilla vượt Gopher trên phần lớn bài đánh giá. Gopher, GPT-3 (175 tỷ params, 300 tỷ token) và nhiều model cùng thời đều undertrained: quá to so với số token chúng được train.
Đó cũng là đáp án cho phần tự điền ở mục 3: nếu model hiện tại đang ở gần điểm cân đối, phương án B (gấp đôi params, nửa số token) nhiều khả năng cho loss cao hơn phương án A. Model to hơn không tự thắng; nó chỉ thắng khi được train đủ token.
Overfitting là model học thuộc tập train thay vì học quy luật chung: loss trên dữ liệu train rất thấp nhưng tệ khi gặp dữ liệu mới. Cần phân biệt với chuyện ở bài này. Model undertrained trong nghiên cứu Chinchilla thường chỉ đọc dữ liệu khoảng một lượt, gần như không gặp lại token nào lần hai, nên không có gì để học thuộc; loss trên dữ liệu mới của nó vẫn đang giảm khi train dừng. Vấn đề là train chưa đủ, không phải học vẹt.
-- Quy tắc nhẩm khi có MỘT compute budget cố định (compute ≈ 6 × params × token)
if tăng params mà budget giữ nguyên:
    số token train được giảm tương ứng
    -- model to hơn nhưng học ít hơn: có thể undertrained, loss không giảm như kỳ vọng
if có thêm compute:
    tăng params VÀ số token cùng nhịp   -- theo Chinchilla, khoảng 20 token cho mỗi params
    -- đạt loss thấp hơn so với dồn hết phần thêm vào params
Thử ngẫmbỏ ràng buộc budget cố định (xin thêm bao nhiêu GPU cũng được), nhưng số token dữ liệu chất lượng thì có hạn. Lúc đó cái gì sẽ giới hạn việc làm model to hơn?
5. Kỹ sư rút ra gì từ scaling laws?
Kết quả Chinchilla đổi hướng đầu tư của cả ngành: thay vì chỉ đua làm model to hơn, các đội phải lo đủ data đa dạng và chất lượng để train đủ token. Data thành nút thắt thật sự, không kém gì số params hay số GPU.
Thực tế còn một lực kéo nữa: điểm compute-optimal chỉ tối ưu chi phí train. Model sẽ phục vụ hàng triệu lượt gọi thì một model nhỏ hơn rẻ hơn ở mỗi lượt inference, nên nhiều đội cố tình train model nhỏ trên nhiều token hơn mức Chinchilla gợi ý (ví dụ LLaMA 7B train trên khoảng 1 nghìn tỷ token), chấp nhận tốn compute lúc train để rẻ lúc chạy.
Vì vậy "model to hơn luôn tốt hơn" chỉ đúng có điều kiện: đúng khi số token train và compute tăng tương xứng theo params. Params cứ tăng mà token không theo kịp thì lợi ích giảm dần, rồi thành phí compute.
6. Pitfall tổng hợp
❌ Nhầm 1: nghĩ có thêm compute thì dồn hết vào tăng params là lợi nhất.
✅ Theo Chinchilla, tăng params mà không tăng số token train tương ứng thì model undertrained và phí compute. Phần compute thêm nên chia cho cả params lẫn token.
❌ Nhầm 2: coi model to train thiếu token là "overfitting".
✅ Hai chuyện khác nhau. Overfitting là học thuộc dữ liệu train, thấy rõ khi loss trên dữ liệu mới tệ hơn hẳn loss trên dữ liệu train. Model undertrained thì ngược lại: chưa học đủ, loss trên dữ liệu mới vẫn đang giảm; cách chữa là train thêm token, không phải chống học thuộc.
❌ Nhầm 3: coi scaling laws là công thức chính xác, áp được cho mọi kiến trúc và dataset.
✅ Đây là xu hướng thực nghiệm quan sát trên một họ model cụ thể, ở một thời điểm cụ thể, và hai nhóm nghiên cứu đã ra hai khuyến nghị khác nhau. Nó định hướng quyết định ở mức định tính, không thay được việc đo trên đúng kiến trúc và dataset của bạn.
Nguồn:
- Kaplan et al. — Scaling Laws for Neural Language Models (arXiv:2001.08361): nghiên cứu gốc chỉ ra loss giảm trơn theo params/data/compute.
- Hoffmann et al. — Training Compute-Optimal Large Language Models (arXiv:2203.15556): nghiên cứu Chinchilla, tỉ lệ params/token tối ưu theo compute và so sánh Chinchilla với Gopher.
Ghi chú: đọc Abstract của cả hai là đủ nắm ý chính bài này cần.
Một câu thận trọng về emergent abilities: một số khả năng dường như chỉ "xuất hiện" rõ khi model vượt một ngưỡng quy mô, thay vì cải thiện dần đều. Tính "đột ngột" này vẫn đang được tranh luận (một phần được cho là do cách đo hơn là một bước nhảy năng lực thật), bài này không đi sâu.
7. Liên hệ các bài khác
- Bài 01 — Giới hạn của model đọc tuần tự: vì sao kiến trúc song song hoá được như transformer mới chạy nổi những thí nghiệm quy mô mà scaling laws cần.
- Overfitting & data leakage: để phân biệt học thuộc (overfitting) với train chưa đủ (undertrained).
- Bài 07 — Mini-challenge: đọc sơ đồ kiến trúc: áp trực giác scaling laws khi đọc model card.
8. Tóm tắt
- Compute ≈ 6 × params × token: cùng budget, params và token là hai đầu bập bênh.
- Ở compute cố định, loss theo cỡ model là hình chữ U; đáy là điểm compute-optimal, quy tắc nhẩm khoảng 20 token mỗi params.
- Chinchilla 70B (1,4 nghìn tỷ token) thắng Gopher 280B (300 tỷ token) với cùng compute.
- Undertrained khác overfitting: chưa học đủ, chứ không phải học thuộc.
- Model phục vụ nhiều lượt gọi thường được train quá mức compute-optimal để rẻ lúc inference.
9. Tự kiểm tra
- Q1Vì sao Kaplan et al. coi việc loss giảm "trơn và dự đoán được" là một phát hiện quan trọng, thay vì chỉ là hiển nhiên "model to hơn thì tốt hơn"?
- Q2Vì sao quy luật của Kaplan et al. lộ ra được nhờ kiến trúc transformer, chứ khó quan sát với model tuần tự?
- Q3Bạn giữ nguyên compute budget và tăng gấp đôi params. Theo quan hệ compute ≈ 6 × params × token và kết quả Chinchilla, chuyện gì có khả năng xảy ra và vì sao?
- Q4Vì sao Hoffmann et al. nói nhiều model đương thời "undertrained" dù chúng vẫn hoạt động tốt?
- Q5Một đồng nghiệp nói: 'Model 280B mà chỉ train 300 tỷ token thì chắc bị overfitting.' Đánh giá nhận định này.
- Q6Vì sao "model to hơn = tốt hơn" chỉ đúng có điều kiện? Điều kiện đó là gì, và vì sao có đội lại cố tình train model nhỏ trên nhiều token hơn mức tối ưu?
Bài tiếp theo: Mini-challenge — Đọc sơ đồ kiến trúc
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Từ transformer đến LLM: causal mask và train song song
Bài tiếpMini-challenge: đọc sơ đồ kiến trúc LLM
Thảo luận & góp ý
Hỏi đáp về bài này