Query/Key/Value: attention là phép tra cứu mềm có trọng số
Attention để mỗi token tự hỏi các token khác qua query, key, value — lấy thông tin liên quan nhất, không cần đi qua nút cổ chai hidden state tuần tự.
TL;DR: Attention là phép tra cứu MỀM có trọng số. Mỗi token phát ra một câu hỏi (query); mọi token khác đeo một bảng tên (key) và mang một nội dung thực (value). Độ khớp query–key, qua softmax, biến thành phần trăm chú ý cộng đúng 100%. Token nhận lại tổng có trọng số của value mọi token khác: khớp nhiều thì đóng góp nhiều, không ai bị loại hẳn. Phép này chạy song song cho mọi token, nên nó thay được nút cổ chai hidden state tuần tự của model đọc tuần tự.
Bài trước cho thấy giới hạn của model đọc tuần tự: thông tin từ token đầu câu phải đi qua một hidden state duy nhất và bị pha loãng dần trước khi tới token cuối. Nhiều tài liệu chỉ tóm gọn "attention giúp model tập trung vào phần quan trọng" rồi bỏ qua đúng phép toán tạo ra chuyện đó.
Bài này giải thích cơ chế của một attention head: vai trò của query, key, value, và cách chúng biến độ khớp thành trọng số.
Neural network học cách nén dữ liệu thô thành vector số nội bộ mang "nghĩa", lớp sau xây trên representation của lớp trước. Query, key, value trong bài này không phải ba nguồn dữ liệu tách biệt: cả ba đều suy ra từ chính vector representation đó của một token, chỉ khác phép biến đổi áp lên nó.
1. Analogy: hỏi cả phòng thay vì hỏi một người
Bạn cần một thông tin gấp. Thay vì đi hỏi từng người trong phòng và dừng ở người đầu tiên trả lời được (tra cứu cứng), bạn đứng giữa phòng và hỏi tất cả mọi người cùng lúc. Ai cũng đeo một tấm bảng tên ghi chuyên môn của mình. Ai có chuyên môn khớp câu hỏi thì bạn nghe kỹ hơn; ai không liên quan thì bạn vẫn nghe loáng thoáng, chỉ là rất ít. Câu trả lời cuối cùng bạn ghi lại là tổng hợp có trọng số của mọi ý kiến: nghiêng hẳn về người đúng chuyên môn, nhưng không ai bị bịt miệng hoàn toàn.
| Đời thường | Attention |
|---|---|
| Câu hỏi bạn đặt ra cho cả phòng | Query của token đang xét |
| Tấm bảng tên ghi chuyên môn mỗi người | Key của từng token trong câu |
| Độ khớp giữa câu hỏi và chuyên môn quyết định bạn nghe ai nhiều | Độ khớp query–key quyết định trọng số attention |
| Nội dung ý kiến người đó thực sự nói ra | Value của token đó |
| Bạn tổng hợp mọi ý kiến theo tỉ lệ đã nghe | Weighted sum của value theo trọng số attention |
Query là câu hỏi bạn phát ra. Key là bảng tên để so với câu hỏi. Value là thứ được mang về. Ba vai trò khác nhau, nhưng đều là chính token đó khoác ba bộ đồ khác nhau cho ba việc khác nhau.
2. Query, key, value là gì?
Vaswani và cộng sự (Deep Dive bên dưới) mô tả attention là một hàm nhận một query cùng một tập cặp key-value, trả về output là tổng có trọng số của các value, với trọng số tính từ độ tương thích giữa query và từng key.
Mỗi token (đã ở dạng vector representation, xem recall ở trên) tạo ra ba vector riêng bằng ba phép biến đổi tuyến tính học được, cùng xuất phát từ một vector gốc:
- Query (q): "tôi đang cần thông tin kiểu gì?", câu hỏi token này phát ra.
- Key (k): "tôi trả lời được câu hỏi kiểu gì?", bảng tên để mọi query khác so vào.
- Value (v): "nếu bạn chọn nghe tôi, đây là nội dung tôi mang theo".
Khác tra cứu từ điển (gõ đúng một khoá, nhận đúng một giá trị, khoá khác coi như không tồn tại), attention không loại ai cả: mọi key đều được so, mọi value đều đóng góp, chỉ khác tỉ lệ. Vì thế mới gọi nó là tra cứu mềm.
Thử ngẫmnếu attention chỉ giữ token khớp cao nhất và bỏ hẳn phần còn lại thay vì cộng dồn qua softmax, thì khi hai token gần như ngang điểm nhau, model mất đi điều gì?
3. Độ khớp biến thành trọng số như thế nào?
Ba bước biến "độ khớp" thành "trọng số" diễn ra cho mỗi token trong câu, với mọi token khác làm ứng viên:
- Tính độ khớp (score): so
querycủa token đang xét vớikeycủa từng token khác bằng phép nhân vô hướng (dot product). Hai vector càng "cùng hướng" thì dot product càng lớn, tức câu hỏi và bảng tên càng ăn khớp. Chưa cần biết công thức đại số đầy đủ của dot product để hiểu ý này: nó chỉ là một con số đo mức khớp, càng lớn càng khớp. - Chuẩn hoá thành phần trăm (softmax): danh sách điểm khớp thô được đưa qua softmax để thành các trọng số dương, cộng lại đúng 100%. Token khớp cao hơn nhận phần trăm chú ý lớn hơn; token khớp kém vẫn nhận một phần nhỏ khác 0.
- Lấy tổng có trọng số (weighted sum): nhân từng trọng số với
valuetương ứng rồi cộng lại. Kết quả là vector output mới cho token đang xét, pha trộn thông tin từ mọi token khác theo đúng tỉ lệ ở bước 2.
Viết ba bước đó thành pseudocode (không chạy, chỉ để đọc hiểu cơ chế):
for each token i:
    q_i <- query của token i
    for each token j:
        score[i][j] <- q_i . k_j        -- độ khớp giữa query của i và key của j
    weight[i] <- softmax(score[i])      -- chia thành %, tổng các weight[i][j] = 1
    out_i <- sum_j weight[i][j] * v_j   -- tổng có trọng số của mọi value trong câu
// Time: O(n^2 * d)  Space: O(n^2)
n là số token trong câu, d là số chiều của mỗi vector. Vì mỗi token phải so với mọi token khác, chi phí tăng theo bình phương độ dài câu. Đó là cái giá để khỏi phải đọc tuần tự, và bài mini-challenge cuối module sẽ quay lại đánh đổi này ở quy mô lớn.
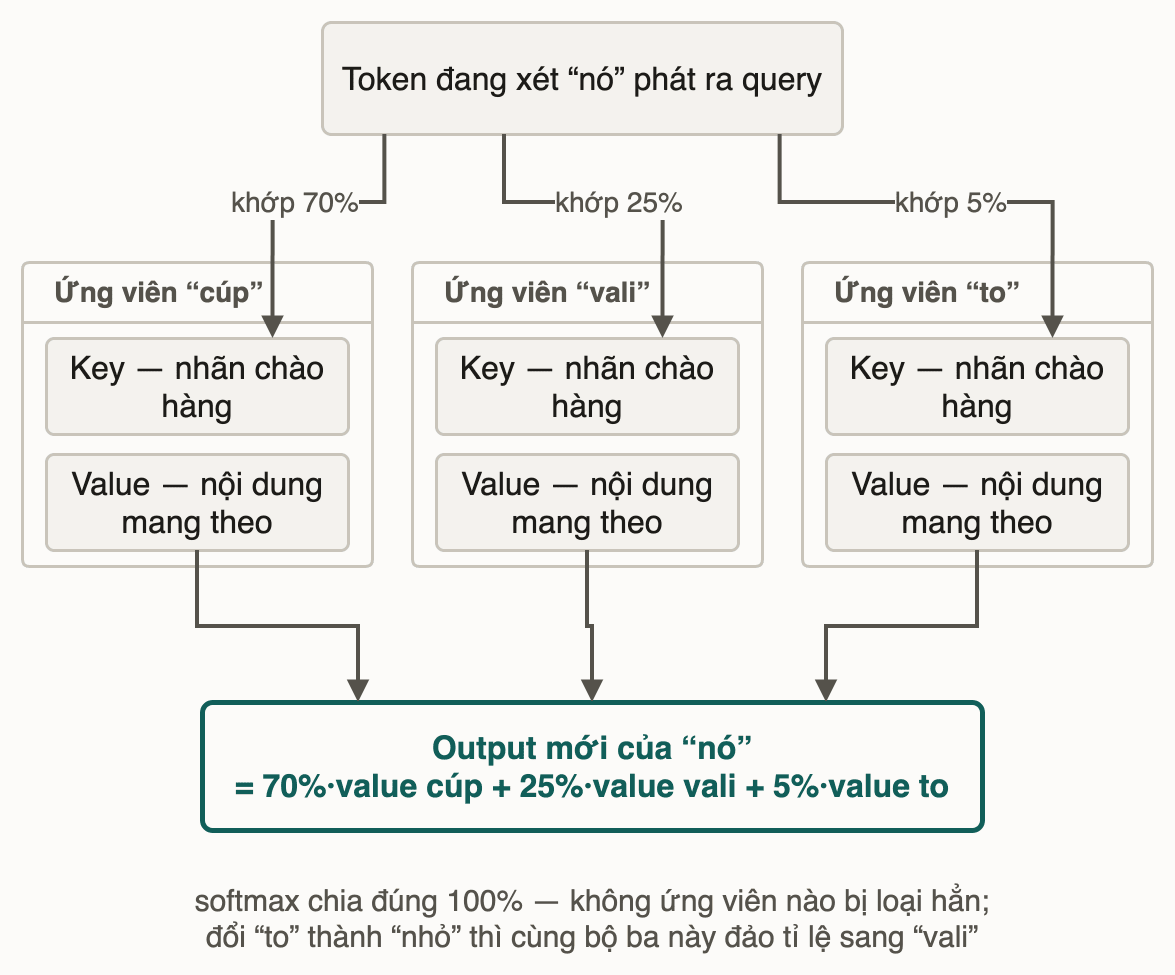
Sơ đồ chỉ vẽ 3 trong số nhiều token của câu (mục 4 dùng đúng ví dụ này). Output cuối cùng của "nó" không phải value gốc của chính nó, mà là một pha trộn nghiêng hẳn về token khớp nhất. Phép so khớp của các cặp token độc lập với nhau, nên cả ba bước trên tính song song được cho mọi token cùng lúc: token cuối câu "thấy" token đầu câu ngay trong một bước, không cần trạm trung chuyển hidden state nào.
4. Vì sao đại từ "nó" đổi nghĩa chỉ vì một tính từ?
Xét hai câu tiếng Việt chỉ khác nhau một chữ:
- (a) "Chiếc cúp không vừa cái vali vì nó quá to." → "nó" chỉ chiếc cúp.
- (b) "Chiếc cúp không vừa cái vali vì nó quá nhỏ." → "nó" chỉ cái vali.
"Nó" đứng cùng một vị trí ở cả hai câu nhưng trỏ tới hai danh từ khác nhau, nên một quy tắc vị trí cố định (luôn trỏ danh từ gần nhất) sẽ sai ở một trong hai câu. query/key của mỗi token được suy ra từ representation mang cả ngữ cảnh xung quanh chứ không chỉ bản thân từ đó, nên độ khớp giữa query của "nó" và key của "cúp"/"vali" đổi theo đúng tính từ "to" hay "nhỏ". Qua softmax, token đúng nhận phần trăm chú ý cao hơn: đúng như sơ đồ ở mục 3, chỉ là ở câu (b) tỉ lệ 70%/25%/5% đảo sang nghiêng về "vali".
Trọng số attention không cố định theo vị trí mà tính lại theo nội dung từng câu, vì query/key phụ thuộc representation đã mang ngữ cảnh.
Thử ngẫmcâu "Con mèo đuổi con chuột vì nó chạy nhanh" cũng mơ hồ như ví dụ cúp/vali. Nếu không dựa vào vị trí, trọng số attention sẽ dựa vào đâu để quyết "nó" chỉ mèo hay chuột?
5. Pitfall tổng hợp
❌ Nhầm 1: tưởng attention chọn cứng một token, giống lookup từ điển.
✅ Softmax luôn cho mọi token được phép nhìn một trọng số khác 0. Không có bước if/else chọn một token, chỉ có phép nhân-cộng trên toàn bộ tập value.
❌ Nhầm 2: tưởng query, key, value là ba nguồn dữ liệu độc lập.
✅ Cả ba suy ra từ cùng một vector representation của token, chỉ khác phép biến đổi tuyến tính áp lên nó (xem recall đầu bài).
❌ Nhầm 3: tưởng trọng số attention cao nghĩa là model "hiểu nghĩa" như con người.
✅ Trọng số chỉ phản ánh tương quan thống kê model học được từ dữ liệu huấn luyện. Với câu hiếm gặp trong dữ liệu train, model vẫn có thể phân bổ sai dù con người thấy hiển nhiên.
6. 📚 Deep Dive
Nguồn gốc:
- Vaswani et al., "Attention Is All You Need", arXiv:1706.03762 (2017): bài báo đặt nền cho kiến trúc Transformer, định nghĩa attention là hàm nhận query cùng tập key-value và trả về tổng có trọng số của value.
Ghi chú: bài này dừng ở mức trực giác: dot product đo độ khớp, softmax chia phần trăm, weighted sum gộp value. Bài báo gốc trình bày bản đầy đủ ("Scaled Dot-Product Attention") bằng ma trận và thêm một hệ số chia tỉ lệ. Bạn không cần công thức đó để hiểu cơ chế ở mức khái niệm, nhưng đó là điểm bắt đầu tốt nếu muốn đọc sâu hơn.
7. Liên hệ các bài khác
- Bài 01 — Giới hạn của model đọc tuần tự: nút cổ chai hidden state mà attention ở bài này gỡ bỏ.
- Bài 03 — Multi-head: nhiều góc nhìn: một attention head chỉ bắt được một kiểu khớp; chạy nhiều head song song thì bắt được nhiều kiểu quan hệ cùng lúc.
- Bài 04 — Transformer block: attention chỉ là một khối trong transformer block đầy đủ, đứng cạnh positional encoding và feed-forward network.
- Bài 06 module 2 — Representation học được: nguồn gốc của vector representation mà query/key/value được suy ra.
8. Tóm tắt
- Ba bước cho mỗi token: dot product query–key, softmax thành phần trăm, weighted sum các value.
- Chi phí O(n²·d) vì mỗi token so với mọi token khác, là cái giá để khỏi đọc tuần tự.
- Ví dụ cúp/vali: đổi "to" thành "nhỏ" thì trọng số của "nó" đảo từ cúp sang vali, dù vị trí không đổi.
- Một attention head chỉ có một tiêu chí khớp; bài sau mở rộng sang nhiều head.
9. Tự kiểm tra
- Q1Vì sao attention được gọi là phép tra cứu MỀM, khác với tra cứu từ điển thông thường?
- Q2Trong ví dụ 'chiếc cúp / cái vali', vì sao đổi tính từ 'to' thành 'nhỏ' lại đổi luôn đối tượng mà đại từ 'nó' trỏ tới?
- Q3Query, key, value của một token đến từ đâu — chúng có phải ba nguồn dữ liệu tách biệt không?
- Q4Vì sao attention giải quyết được nút cổ chai hidden state của model đọc tuần tự ở bài trước?
- Q5Softmax đảm bảo điều gì về tập trọng số attention của một token, và vì sao điều đó quan trọng?
- Q6Nếu weight[i][j] gần bằng nhau cho mọi j trong pseudocode ở mục 3, điều đó nói gì về mức độ 'chú ý' của token i?
Bài tiếp theo: Multi-head — nhiều góc nhìn
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Giới hạn của model đọc tuần tự trước khi có transformer
Bài tiếpMulti-head attention — mỗi head một góc nhìn riêng
Thảo luận & góp ý
Hỏi đáp về bài này