Transformer block: ghép attention, FFN, residual thành khối
Attention tự nó không biết thứ tự — cần positional encoding. Ghép encoding, self-attention, FFN và residual thành một block, xếp chồng N lớp thành model.
TL;DR: Self-attention thuần không biết token nào đứng trước, token nào đứng sau: nó chỉ so nội dung. Positional encoding vá lỗ hổng đó bằng cách cộng một vector vị trí vào embedding, đúng một lần, trước block đầu tiên. Một transformer block có ba mảnh: self-attention (trộn thông tin giữa các token), FFN (xử lý từng token riêng), và residual connection bọc quanh cả hai (giữ input gốc, để xếp sâu mà không "quên" và gradient vẫn chảy được). Xếp chồng N block, mỗi lớp xây trên những cụm thông tin lớp trước đã gom, biến quan hệ gần thành quan hệ trừu tượng hơn.
Xếp nhiều lớp với hàm phi tuyến xen giữa cho phép mạng học được hàm phức tạp hơn hẳn một lớp đơn: sức mạnh đến từ việc CHỒNG (compose) nhiều lớp, không phải từ một lớp to hơn. Bài này dùng lại nguyên lý đó, chỉ khác là đơn vị xếp chồng giờ là cả một transformer block, không phải một lớp neuron.
1. Analogy: một cuộc họp nhóm lặp lại N vòng
Hình dung một cuộc họp brainstorm 3 người: Chó, Cắn, Mèo (đúng ba từ bạn sẽ theo dõi suốt bài). Trước khi họp, mỗi người được gắn thẻ ghi thứ tự phát biểu, "Người #1", "#2", "#3", để phân biệt ai nói trước ai nói sau dù nội dung phát biểu giống nhau.
Cuộc họp lặp hai bước: nghe (mỗi người nghe cả ba người, kể cả chính mình, rồi tổng hợp thành ý hiểu mới) và tự nghĩ riêng (gặm nhấm ý vừa tổng hợp, không trao đổi thêm). Ở cả hai bước, mỗi người đều giữ ý ban đầu và cộng thêm phần vừa xử lý; không ai xoá sạch ý cũ để thay hẳn bằng ý mới.
| Đời thường (họp nhóm) | Khái niệm trong transformer block |
|---|---|
| Thẻ số thứ tự gắn trước khi họp | Positional encoding — cộng vào embedding, một lần, trước block đầu tiên |
| Nghe phát biểu cả ba người rồi tổng hợp | Self-attention — mỗi token "nghe" mọi token khác, lấy tổng có trọng số |
| Giữ ý ban đầu, cộng thêm phần vừa nghe | Residual connection quanh self-attention |
| Tự gặm nhấm riêng, không trao đổi thêm | FFN — xử lý từng token độc lập, không tương tác giữa token |
| Giữ ý trước khi nghĩ riêng, cộng thêm kết quả | Residual connection quanh FFN |
| Lặp lại N vòng, ý mỗi vòng tinh chỉnh sâu hơn | Xếp chồng N block |
Một block chỉ làm hai việc theo thứ tự: "nghe người khác" (self-attention) rồi "tự nghĩ một mình" (FFN). Sau mỗi việc, luôn cộng lại ý gốc (residual) rồi mới sang bước tiếp.
2. Vì sao self-attention một mình không biết ai đứng trước ai?
Bài 02–03 đã giải thích self-attention: mỗi token tính một vector query, so với key của mọi token khác (kể cả chính nó), rồi lấy tổng có trọng số của các vector value. Phép so đó chỉ dựa vào nội dung vector, tức token nào giống token nào, chứ không dùng tới "token này đứng ở vị trí thứ mấy".
Xét hai câu dùng đúng ba token giống hệt nhau, chỉ đổi thứ tự: "Chó cắn mèo." (chó là chủ thể) và "Mèo cắn chó." (mèo là chủ thể). Nếu self-attention chỉ so theo NỘI DUNG vector và không hề biết vị trí, thì vector đầu vào của "chó" ở hai câu có giống hệt nhau không? Và nếu giống hệt, self-attention có cách nào phân biệt "ai đang cắn ai" không? Viết ra dự đoán trước khi đọc tiếp.
Không có gì đánh dấu vị trí thì vector đầu vào của "chó" ở hai câu giống hệt nhau: cùng embedding, không mang dấu vết "đứng trước" hay "đứng sau" chữ cắn. Self-attention khi đó tính ra cùng một tập điểm khớp cho cả hai câu và không có cách nào phân biệt "ai đang cắn", vì phép tính chưa từng nhìn tới vị trí.
Vaswani và cộng sự (2017) nói thẳng trong bài báo gốc: Transformer không có recurrence (đọc tuần tự như RNN) và không có convolution (cửa sổ trượt theo thứ tự), nên phải chủ động đưa thêm thông tin vị trí. Với kiến trúc gốc, thiếu bước này thì model không phân biệt được thứ tự các token. (Riêng decoder có causal mask ở bài 05 thì lại suy ra được một phần vị trí từ chính cái mask, nhưng các LLM thật vẫn đưa thông tin vị trí vào tường minh.)
3. Positional encoding gắn thứ tự vào token như thế nào?
Positional encoding (mã hoá vị trí) là một vector số đại diện cho "vị trí thứ mấy trong câu", được cộng thẳng vào embedding của token, giống tấm thẻ số thứ tự phát biểu trong analogy. Điểm cần nhớ: bước cộng này chỉ diễn ra một lần duy nhất, ngay ở đầu vào, trước block đầu tiên, không cộng lại ở mỗi block. Vector kết quả (embedding cộng vị trí) là thứ đi vào cả chuỗi N block phía sau.
Ở mức trực giác, mỗi token mang hai lớp thông tin chồng lên nhau trong cùng một vector: "tôi LÀ từ gì" (embedding) và "tôi ĐỨNG ở đâu" (positional encoding). Nhờ lớp thứ hai, "chó" ở vị trí 1 của câu này và "chó" ở vị trí 3 của câu kia có vector đầu vào khác nhau dù cùng là từ "chó", đủ để self-attention phân biệt chủ thể và tân ngữ dựa trên vị trí tương đối.
Bản gốc dùng hàm sin/cos để tính vector vị trí. Bài này chỉ cần bạn nắm VÌ SAO cần bước này và NÓ ĐƯỢC CỘNG Ở ĐÂU; công thức cụ thể nằm ngoài phạm vi bài, đọc ở phần Deep Dive nếu tò mò.
Cộng một lần trước block đầu tiên là thiết kế của Transformer gốc (Vaswani et al., 2017, sinusoidal). Nhiều LLM hiện đại (ví dụ họ Llama) dùng RoPE: thông tin vị trí được áp LẠI ngay bên trong self-attention, ở MỖI layer, thay vì cộng một lần ở đầu vào. Nguyên tắc chung không đổi: attention thuần không tự biết thứ tự, nên phải đưa thông tin vị trí vào; chỉ khác chỗ đưa vào.
4. Một transformer block gồm những gì?
Token đã mang vị trí rồi thì đi qua một block, đơn vị lặp lại N lần để tạo thành cả model. Một block gồm hai sub-layer, mỗi sub-layer được bọc trong một residual connection:
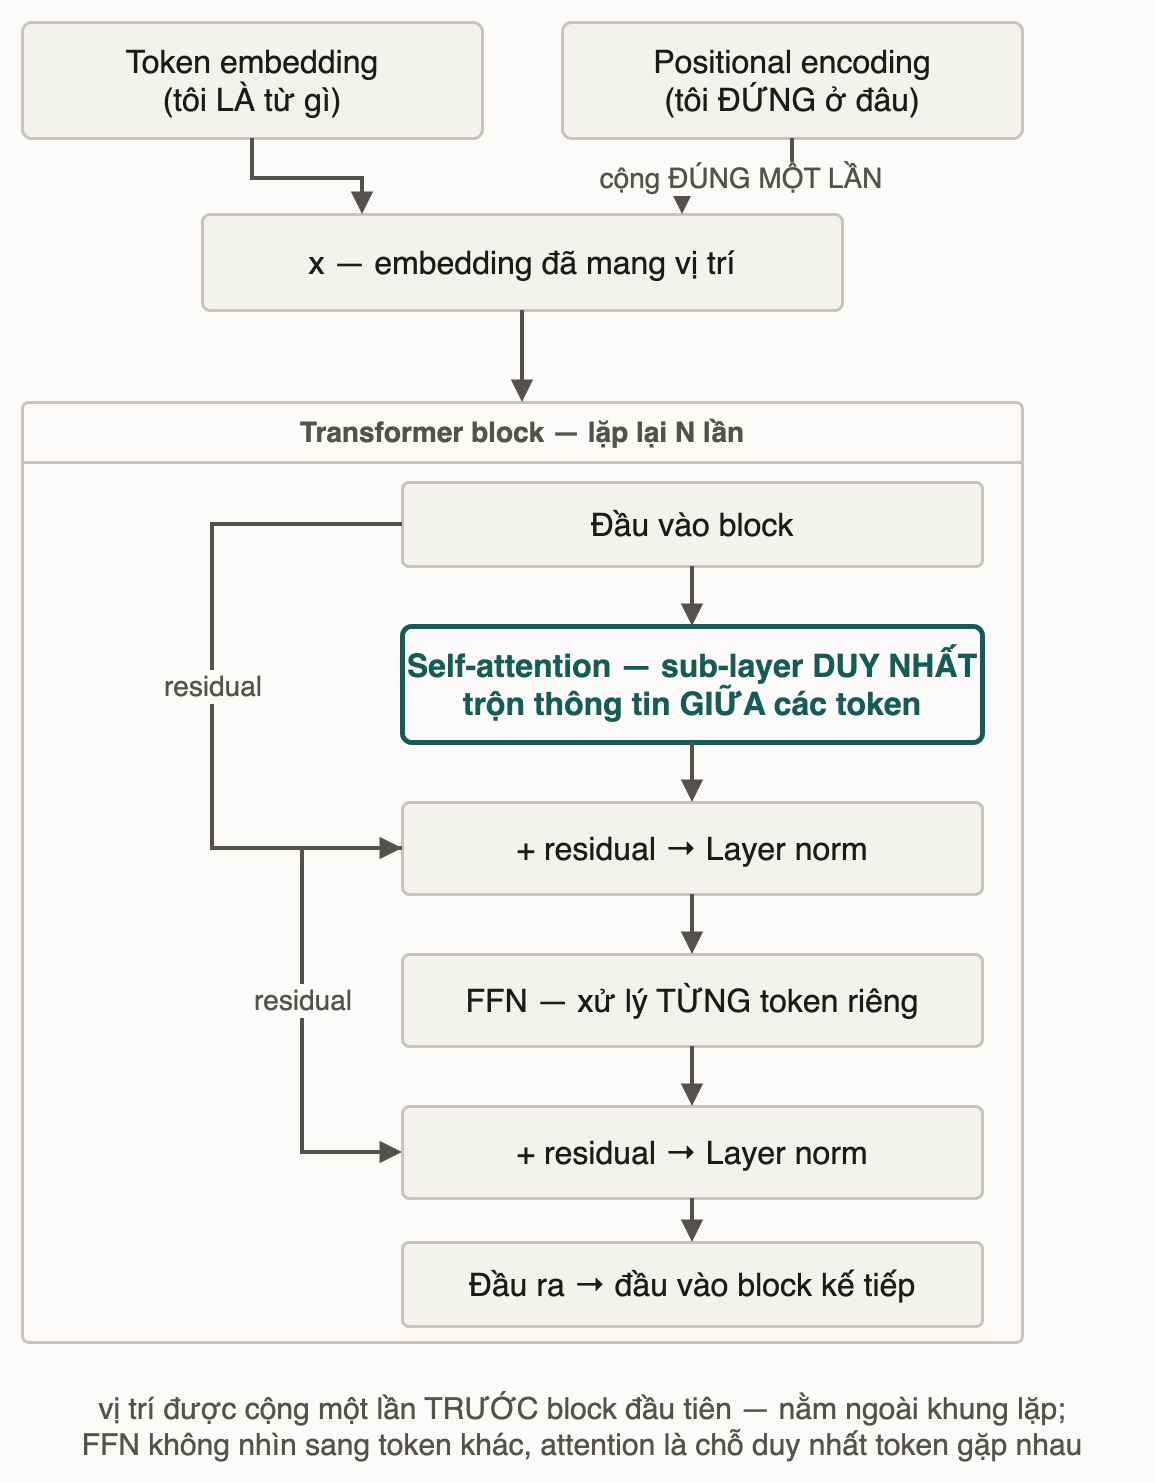
Viết lại bằng pseudocode cho cả N block, áp dụng cho mọi token trong câu cùng lúc:
for each token t in sequence:
    x[t] <- embedding(t) + positional_encoding(vị trí của t)   -- cộng 1 lần duy nhất, trước block đầu tiên

for block b = 1 to N:
    for each token t:
        attn[t] <- self_attention(x[t], toàn bộ x)   -- trộn thông tin GIỮA các token
    for each token t:
        y[t] <- LayerNorm(x[t] + attn[t])            -- residual + norm quanh self-attention
    for each token t:
        ffn[t] <- FFN(y[t])                          -- xử lý TỪNG token riêng, KHÔNG trộn giữa các token
        x[t] <- LayerNorm(y[t] + ffn[t])              -- residual + norm quanh FFN
// x[t] sau block N là vector cuối cùng của token t
Ba mảnh ghép, theo đúng thứ tự trong pseudocode:
- Self-attention: sub-layer duy nhất trộn thông tin giữa các token, đúng cơ chế ở bài 02–03.
- FFN (feed-forward network): một mạng neuron nhỏ gần giống MLP ở bài 02 Module 2, nhưng áp độc lập cho từng token, dùng chung một bộ trọng số cho mọi vị trí. Đây là bước "tiêu hoá" thứ vừa gom được từ self-attention.
- Residual connection (đường tắt): cộng thẳng đầu vào của một sub-layer vào đầu ra của chính nó. Mỗi block có hai đường tắt, một quanh self-attention, một quanh FFN.
Layer normalization đi ngay sau mỗi phép cộng residual, đưa giá trị vector về một khoảng ổn định; bài này không đi sâu cơ chế, chỉ cần biết vị trí của nó trong sơ đồ. Cộng rồi mới chuẩn hoá (Post-LN) là thiết kế gốc năm 2017; từ GPT-2 trở đi, phần lớn LLM hiện đại dùng Pre-LN, chuẩn hoá TRƯỚC self-attention/FFN, để train ổn định hơn khi xếp sâu. Nguyên tắc residual + layer norm quanh mỗi sub-layer vẫn vậy, chỉ đổi thứ tự.
FFN KHÔNG trộn thông tin giữa các token: nó xử lý mỗi token tách biệt hoàn toàn. Trong cả block, self-attention là sub-layer DUY NHẤT cho token này "nhìn thấy" token kia.
5. Thiếu positional encoding thì hỏng gì?
Giả sử một kỹ sư dựng lại đúng sơ đồ block ở mục 4 nhưng VÔ Ý bỏ mất bước cộng positional encoding ở đầu vào, còn self-attention, FFN, residual vẫn y nguyên. Sau khi huấn luyện xong, đưa model này dịch cả hai câu "Chó cắn mèo." và "Mèo cắn chó." sang tiếng Anh. Bạn đoán điều gì xảy ra, và vì sao?
Đúng như mục 2: thiếu positional encoding thì vector đầu vào của "chó" giống hệt nhau ở cả hai câu. FFN xử lý từng token độc lập, residual chỉ cộng dồn chứ không tạo ra thông tin vị trí mới, nên không bước nào bù lại được. Model không phân biệt được "ai đang cắn". Đây là lý do Vaswani và cộng sự (2017) coi positional encoding là bắt buộc, không phải tuỳ chọn.
6. Một token cụ thể đi qua block ra sao?
Bám ví dụ "Chó cắn mèo.", theo chân token "cắn" (vị trí thứ 2) qua một block:
- Đầu vào: vector của "cắn" = embedding cộng positional encoding của vị trí 2.
- Self-attention: "cắn" tạo query, so với key của cả ba token. Nhờ vị trí đã gắn ở bước 1, model học được rằng token đứng NGAY TRƯỚC động từ thường là chủ thể, token đứng SAU là tân ngữ, nên trọng số của "cắn" nghiêng đúng về "chó là chủ thể, mèo là tân ngữ".
- Residual + layer norm quanh self-attention: vector mới = vector bước 1 CỘNG kết quả attention, rồi chuẩn hoá. Nghĩa gốc "cắn là động từ" không bị ghi đè, chỉ được bồi thêm ngữ cảnh chủ thể/tân ngữ.
- FFN: vector đã mang ngữ cảnh đi qua một MLP nhỏ, xử lý MỘT MÌNH, không nhìn "chó" hay "mèo" nữa.
- Residual + layer norm quanh FFN: vector cuối = vector bước 3 cộng kết quả FFN, chuẩn hoá lần nữa. Đó là output của "cắn" ở block này và là đầu vào của block kế tiếp.
Token "chó" và "mèo" đi qua đúng năm bước đó, song song, chỉ khác nội dung vector và trọng số attention.
Thử ngẫmđổi câu "Chó cắn mèo" thành "Mèo cắn chó", giữ nguyên kiến trúc. Trong năm bước vừa theo dõi ở token "cắn", bước nào cho ra kết quả khác, và các bước còn lại có đổi theo không?
7. Xếp chồng N block giúp model bắt quan hệ xa như thế nào?
Output của block 1 trở thành input của block 2: cùng cấu trúc lặp lại, nhưng self-attention ở block 2 không làm việc trên embedding "thô" mà trên vector đã được block 1 xử lý trước.
Xét một câu dài hơn: "Con mèo mà tôi nuôi hôm qua đã ăn hết cá." Chủ thể thật của "ăn" là "con mèo", nhưng hai từ nằm cách xa nhau. Ở block 1, self-attention dễ gom các token liền kề thành cụm có nghĩa: "con" ghép với "mèo" thành một biểu diễn rõ nét hơn. Ở block 2, self-attention làm việc với cụm đã gom sẵn đó, nên nối "con mèo" với "ăn" ở xa dễ hơn, vì phần xử lý cục bộ đã xong.
Xếp chồng thêm block là compose nhiều vòng xử lý lên nhau, đúng nguyên lý ở recall đầu bài: mỗi lớp xây trên đầu ra của lớp trước, nên cả chuỗi N lớp làm được điều một lớp đơn không làm được. Cụ thể là lớp dưới gom quan hệ giữa các token gần nhau, lớp trên ghép các cụm đó thành quan hệ xa và trừu tượng hơn.
Xếp chồng vài chục block nghĩa là gradient lan truyền ngược phải đi qua từng ấy tầng phi tuyến liên tiếp. Không có residual thì gradient dễ tắt dần hoặc bùng nổ, và các block sâu khó học được gì. Residual để mỗi sub-layer chỉ cần học một "phần chỉnh sửa nhỏ" cộng vào input, nên gần như là điều kiện bắt buộc để xếp sâu, không phải một mẹo tăng tốc phụ.
Thử ngẫmhệ thống đọc một hợp đồng 50 trang cần nối điều khoản ở trang 2 với một điều khoản mâu thuẫn ở trang 48. Theo cơ chế xếp chồng N block, việc đó có thể xong ngay ở block đầu tiên không?
8. 📚 Deep Dive
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention Is All You Need. NeurIPS 2017. arXiv:1706.03762: bài báo gốc đề xuất kiến trúc Transformer, bỏ hẳn recurrence và convolution. Đọc Section 3 để thấy sơ đồ block đầy đủ (Figure 1) và công thức sin/cos mà bài này cố ý bỏ qua.
9. Liên hệ các bài khác
- Bài 02 — Attention: truy vấn có trọng số: self-attention (query/key/value) được dùng lại nguyên vẹn trong sub-layer đầu của block.
- Bài 03 — Multi-head: nhiều góc nhìn song song: self-attention ở mục 4 thực chất chạy nhiều head song song; bài này gộp thành một khối.
- Bài 05 — Từ transformer đến LLM: bài kế tiếp lấy đúng cấu trúc block này, thêm causal mask để giải thích vì sao decoder-only LLM sinh từng token một.
- Module 2, bài 02 — Xếp lớp và phi tuyến: nguyên lý composition giải thích vì sao xếp chồng N block (mục 7) mạnh hơn một block đơn.
10. Tóm tắt
- Vị trí được cộng một lần, ngoài khung lặp; LLM hiện đại như Llama dùng RoPE, áp lại vị trí ở mỗi layer.
- Trong block chỉ self-attention cho các token gặp nhau; FFN làm việc trên từng token riêng.
- Mỗi sub-layer có một residual riêng, theo sau là layer norm (Post-LN gốc) hoặc đặt trước (Pre-LN hiện đại).
- Causal mask và cách decoder-only LLM sinh từng token là nội dung bài 05.
11. Tự kiểm tra
- Q1Vì sao self-attention một mình, không có positional encoding, không phân biệt được "Chó cắn mèo" và "Mèo cắn chó"?
- Q2Positional encoding được cộng vào token ở bước nào — mỗi block, hay chỉ một lần? Residual connection giúp gì để thông tin đó không mất qua nhiều lớp?
- Q3Self-attention và FFN khác nhau thế nào về việc một token có "nhìn thấy" token khác hay không?
- Q4Nếu bỏ residual connection ra khỏi một model xếp chồng vài chục block, bạn dự đoán điều gì xảy ra khi huấn luyện?
- Q5Vì sao xếp chồng nhiều block thường giúp model bắt được quan hệ xa và trừu tượng hơn, thay vì chỉ lặp lại đúng một việc nhiều lần?
- Q6Hệ thống đọc hợp đồng cần nối điều khoản ở trang 2 với điều khoản mâu thuẫn ở trang 48. Vì sao việc nối đó khó xong ngay ở block đầu tiên, và xếp nhiều block giúp gì?
Bài tiếp theo: Từ transformer đến LLM
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Multi-head attention — mỗi head một góc nhìn riêng
Bài tiếpTừ transformer đến LLM: causal mask và train song song
Thảo luận & góp ý
Hỏi đáp về bài này