Cost và latency AI feature: tính từ token trước khi code
Chi phí và độ trễ AI feature tính được từ số token vào/ra trước khi viết code — bốn đòn bẩy tham chiếu: cache, model nhỏ, cắt context, streaming.
TL;DR: Cost và latency của một AI feature tính được trước khi viết dòng code nào, chỉ từ số token vào/ra: cost = (token vào × giá vào + token ra × giá ra) × số request, latency = thời gian tới token đầu tiên + thời gian mỗi token × số token ra. Hầu hết nhà cung cấp định giá token ra đắt hơn token vào vài lần. Lý do nằm ở phần cứng: token vào xử lý song song cả loạt, token ra phải sinh tuần tự, mỗi bước đọc lại trọng số model từ bộ nhớ nên GPU phần lớn thời gian ngồi chờ; câu trả lời dài thì đây là phần chậm nhất. Bốn đòn bẩy (cache, model nhỏ hơn cho việc dễ, cắt context, streaming) không đổi công thức, chỉ đổi các biến trong đó. Với người dùng Việt, cùng nội dung tốn token hơn tiếng Anh, nên đếm từ rồi suy ra token là sai ngay từ bước đầu.
Sếp hỏi trước khi bạn viết dòng code đầu tiên: "Chatbot này chạy một tháng tốn bao nhiêu, người dùng chờ bao lâu mới thấy câu trả lời?" Bài này trả lời bằng công thức, không bằng cảm tính.
1. Analogy — bài thi tự luận: đọc đề vs viết bài
Đọc đề thi chỉ tốn một lượt, đề dài thêm vài dòng cũng chẳng lâu hơn bao nhiêu. Viết bài luận thì từng câu một, bài dài gấp đôi là thời gian viết gần gấp đôi thật.
| Đời thường | AI feature |
|---|---|
| Đọc đề: nhìn toàn bộ trong một lượt | Token vào: model xử lý cả loạt trong một lượt tính song song (prefill) |
| Viết bài: từng câu một, công sức tỉ lệ độ dài | Token ra: model sinh tuần tự, từng token một (decode) |
| Đề dài hơn thì đọc lâu hơn chút, vẫn một lượt | Token vào nhiều hơn thì cost tăng, TTFT tăng, mỗi bước sinh cũng chậm đi chút vì context dài hơn |
| Bài dài hơn thì viết lâu hơn thật | Token ra nhiều hơn thì cả cost lẫn latency đều tăng theo |
Đọc đề rẻ và nhanh vì làm một lượt. Viết bài đắt và chậm vì làm từng chữ. Token vào giống đọc đề, token ra giống viết bài.
2. Hai công thức — cost và latency tính từ token vào/ra
Train là khoản chi một lần cho cả đợt huấn luyện; production chỉ chạy inference, và mỗi request là một hoá đơn riêng. Cost và latency trong bài này đều thuộc phía hoá đơn inference.
function cost_moi_request(token_vao, token_ra, gia_vao, gia_ra):
    return token_vao * gia_vao + token_ra * gia_ra   -- gia tinh theo don vi tien / token

function cost_moi_thang(token_vao, token_ra, gia_vao, gia_ra, request_moi_ngay):
    return cost_moi_request(token_vao, token_ra, gia_vao, gia_ra) * request_moi_ngay * 30

function latency_moi_request(ttft, thoi_gian_moi_token, token_ra):
    return ttft + thoi_gian_moi_token * token_ra       -- token ra dai la thu pham chinh
ttft là time-to-first-token: khoảng chờ từ lúc gửi request tới lúc chữ đầu tiên xuất hiện. thoi_gian_moi_token là thời gian sinh thêm một token ra sau đó.
Ở hầu hết nhà cung cấp, giá token ra cao hơn giá token vào vài lần, vì cơ chế ở mục 3.
Thử ngẫmđổi prompt để model trả lời ngắn hơn, token ra giảm từ 500 xuống 100, token vào giữ nguyên. Cost hay latency đổi nhiều hơn?
3. Vì sao token vào rẻ và nhanh hơn token ra?
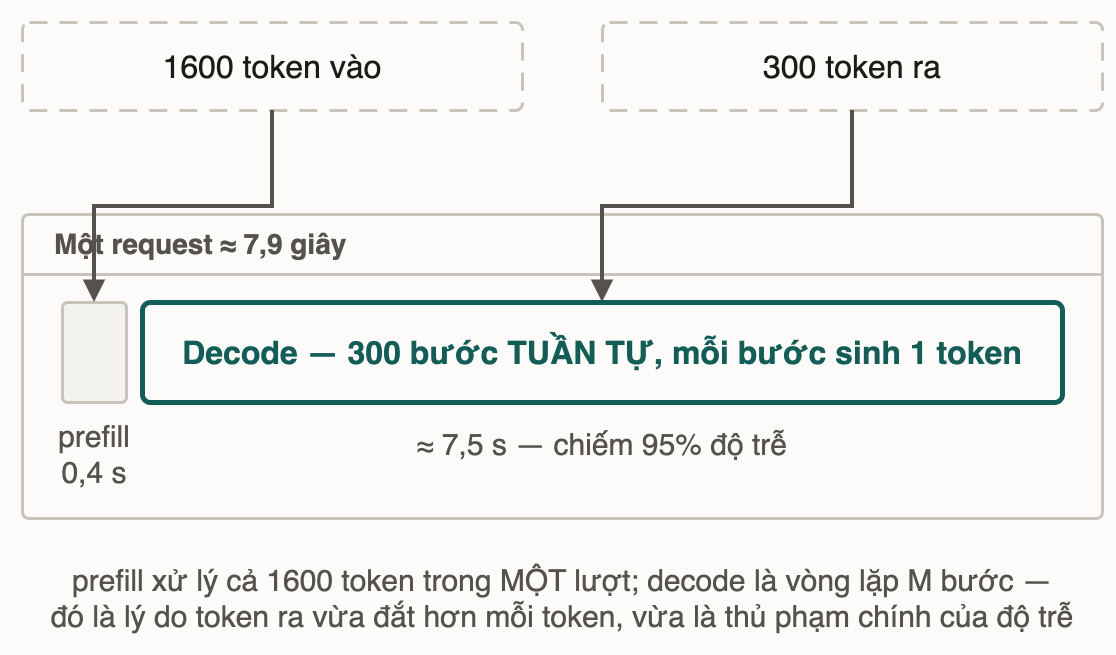
Prefill (đọc token vào): model xử lý toàn bộ N token vào trong một lượt song song, như đọc cả đề cùng lúc. GPU nhận cả loạt token một lần nên dùng gần hết sức tính của nó.
Decode (sinh token ra): muốn sinh token thứ hai phải biết token thứ nhất là gì, nên vòng lặp này bắt buộc chạy tuần tự; sinh M token là M bước. Mỗi bước chỉ ra được đúng một token, nhưng vẫn phải đọc lại toàn bộ trọng số model cùng KV cache (phần lưu tạm của các token trước) từ bộ nhớ GPU. Lượng tính cho một token thì nhỏ, còn lượng dữ liệu phải chở qua bộ nhớ thì lớn, nên decode bị giới hạn bởi băng thông bộ nhớ: GPU phần lớn thời gian ngồi chờ dữ liệu. Nhà cung cấp phục vụ được ít token ra hơn trên cùng một GPU mỗi giây, và giá token ra phản ánh đúng điều đó.
Đây là căn nguyên của cả hai vế: token ra đắt hơn, và khi câu trả lời đủ dài thì token ra chiếm phần lớn thời gian chờ (mục 4 tính tỉ lệ này bằng số).
4. Bài tập ước lượng — chatbot hỗ trợ nội bộ ngân hàng (môi trường dev)
Tình huống: một ngân hàng thử nghiệm chatbot tra cứu quy trình nội bộ ở môi trường dev, chưa lên production. Mỗi request gồm system prompt, câu hỏi và ngữ cảnh trích từ tài liệu, tổng cộng 1600 token vào; câu trả lời trung bình 300 token ra. Khối lượng dùng thử: 200 request mỗi ngày. (Số token ở đây là giả định cho bài tập; hệ thống thật thì phải đo bằng tokenizer, như mục 6.)
Dùng hai công thức ở mục 2, tự tính bậc độ lớn của (a) chi phí một tháng và (b) độ trễ mỗi request trước khi đọc phần Lời giải.
Gợi ý: 200 request mỗi ngày là bao nhiêu mỗi tháng? 300 token ra so với 1600 token vào, phần nào đóng góp nhiều hơn vào cost (nhớ giá ra cao hơn)? Với latency, cần giả định thêm hai đại lượng nào ở mục 2?
Lời giải. Dùng mức giá minh hoạ bậc độ lớn cho một model tầm trung giữa 2026 (không phải giá của một model cụ thể; khi ước lượng thật luôn tra lại provider): giá vào cỡ 0,5 USD/1 triệu token, giá ra cỡ 2,5 USD/1 triệu token.
cost_vao = 1600 * 0,5 USD/1_000_000 = 0,0008 USD
cost_ra  =  300 * 2,5 USD/1_000_000 = 0,00075 USD
cost_1_request ≈ 0,0016 USD

request_thang = 200 * 30 = 6000
cost_thang = 6000 * 0,0016 USD ≈ 9-10 USD/thang
Token ra chỉ bằng chưa tới 1/5 số token vào, vậy mà đóng góp cost gần bằng nhau: giá ra cao hơn bù lại số lượng ít hơn. Bậc độ lớn: cỡ chục đô-la một tháng cho môi trường dev.
TTFT và thời gian mỗi token dưới đây cũng là giả định minh hoạ cho một model tầm trung giữa 2026, không phải số đo thật; ước lượng thật thì đo lại:
ttft = 0,4 giay
thoi_gian_decode = 300 * 0,025 giay/token = 7,5 giay
latency_1_request = 0,4 + 7,5 = 7,9 giay
Decode chiếm 7,5/7,9 ≈ 95% tổng latency: gần như toàn bộ thời gian chờ nằm ở việc sinh 300 token ra, không ở việc đọc 1600 token vào. Lưu lượng gấp 100 lần thì cost gấp 100 lần, còn latency mỗi request không đổi.
5. Bốn đòn bẩy giảm cost và latency (tham chiếu)
| Đòn bẩy | Biến nào giảm | Cơ chế |
|---|---|---|
| Cache | giá của token vào lặp lại; số request chạm model | Prompt caching lưu phần đầu cố định của prompt (system prompt, tài liệu tĩnh). Lần ghi cache đầu tiên đắt hơn giá thường một chút; các lần sau đọc lại phần đó vẫn tính phí nhưng rẻ hơn nhiều, và prefill cũng nhanh hơn. Chỉ lời khi phần cố định đủ dài và lặp lại nhiều lần. Cache câu trả lời cho câu hỏi trùng thì bỏ hẳn một lượt gọi model. |
| Model nhỏ hơn cho việc dễ | giá vào, giá ra, thời gian mỗi token | Model ít tham số hơn thì mỗi bước decode phải đọc ít trọng số hơn, nên rẻ hơn và nhanh hơn mỗi token. Việc dễ (phân loại, trích một trường) không cần model lớn nhất. |
| Cắt context | token vào | RAG chọn lọc chỉ đưa phần liên quan thay vì cả tài liệu; giới hạn lịch sử chat. Token vào giảm thì cost vào và TTFT giảm theo. |
| Streaming | không giảm biến nào | Không đổi tổng thời gian sinh hay tổng tiền, chỉ hiện token dần thay vì đợi sinh xong. Người dùng thấy nhanh hơn, hệ thống thì không nhanh hơn. |
Model lớn hơn thường cho chất lượng cao hơn, nhưng đắt và chậm hơn ở mỗi token sinh ra; không có model nào vừa to vừa rẻ vừa nhanh. Đó là cơ sở của đòn bẩy "model nhỏ hơn cho việc dễ": chuyển việc dễ sang model nhỏ là đổi phần chất lượng dư thừa lấy cost và latency.
6. Vì sao đếm từ tiếng Việt để suy ra token là sai?
Text bị cắt thành token qua BPE, và phép cắt thiên vị theo dữ liệu huấn luyện tokenizer: tiếng Việt bị cắt thành nhiều token hơn tiếng Anh cho cùng nội dung. Giá API tính theo số token, không theo ký tự hay số từ.
Petrov và cộng sự (arXiv:2305.15425) đo được chênh lệch số token giữa các ngôn ngữ lên tới 15 lần ở trường hợp cực đoan (chữ viết không phải Latin); đó không phải số đo riêng cho cặp Việt–Anh. Muốn có con số cụ thể thì tự đo bằng tokenizer định dùng: đưa văn bản mẫu qua, đếm token trả về, rồi thay cho số giả định 1600/300 ở mục 4.
7. Pitfall tổng hợp
❌ Nhầm 1 — gộp chung cost và latency khi lưu lượng tăng:
✅ Cost cộng dồn theo số request; latency mỗi request chỉ phụ thuộc độ dài của chính nó (bỏ qua nghẽn hàng đợi hạ tầng).
❌ Nhầm 2 — cắt token vào để tiết kiệm trong khi token ra mới là phần đắt của request đó:
✅ Request có token ra dài (tóm tắt dài, sinh nhiều code) thì cách giảm đúng là giới hạn độ dài câu trả lời, không phải cắt token vào trong khi token ra vẫn giữ nguyên.
❌ Nhầm 3 — tưởng streaming giảm cost hoặc giảm tổng thời gian sinh:
✅ Streaming chỉ đổi cách hiển thị. Tổng token phải sinh, tổng thời gian và tổng tiền đều giữ nguyên (mục 5).
8. 📚 Deep Dive
Tài liệu chính chủ:
- Anthropic — Prompt caching — cơ chế cache thật: đánh dấu phần prompt cần cache; ghi cache tính giá cao hơn giá thường, đọc lại từ cache tính giá thấp hơn nhiều và prefill nhanh hơn.
- Anthropic — Streaming Messages — cơ chế server-sent events đứng sau đòn bẩy streaming: token được gửi về dần qua từng sự kiện thay vì trả một lần khi sinh xong.
9. Liên hệ các bài khác
- Bài 01 — Nguyên tắc prompt bám cơ chế — prompt dài (few-shot, hướng dẫn chi tiết) cộng thêm token vào, đúng cái giá công thức mục 2 tính ra.
- Bài 04 — Eval & golden set — chạy eval qua nhiều request thật cũng tính hoá đơn theo công thức này.
- Bài 07 — Mini-challenge: ship checklist — nơi bạn chọn đòn bẩy cho một scenario cụ thể.
- Cỗ máy LLM — Tokenization — gốc của mọi con số token trong bài này.
- Latency vs throughput (khoá TCP, HTTP & Web cho Backend) — TTFT đo từ client còn cộng thêm round-trip mạng tới API.
10. Tóm tắt
- Bài tập: 1600 token vào + 300 token ra, 200 request mỗi ngày → cỡ chục đô mỗi tháng, latency cỡ 8 giây, decode chiếm khoảng 95%.
- Decode tuần tự và bị giới hạn băng thông bộ nhớ, nên token ra vừa đắt hơn vừa là phần chậm nhất khi câu trả lời dài.
- Prompt caching không miễn phí: đọc cache vẫn tính phí (rẻ hơn nhiều), ghi cache đắt hơn giá thường; streaming chỉ đổi cảm nhận.
- Số token tiếng Việt phải đo bằng tokenizer thật; cost cộng dồn theo số request, latency mỗi request thì không.
11. Tự kiểm tra
- Q1Vì sao token vào của một request thường được tính giá rẻ hơn token ra, xét theo cách model xử lý chúng?
- Q2Một request có 3000 token vào (tài liệu dài) nhưng chỉ 5 token ra (trả về một nhãn phân loại). Token ra có phải thứ đáng lo nhất về latency của request này không?
- Q3Một feature bật streaming, nhưng đội đo benchmark bằng tổng thời gian tới khi sinh xong toàn bộ câu trả lời và thấy con số này không đổi trước/sau khi bật streaming. Điều này có mâu thuẫn với việc streaming 'cải thiện latency' không?
- Q4System prompt 4000 token giống hệt nhau ở mọi request, lưu lượng 10.000 request mỗi ngày. Prompt caching giúp gì, và vì sao không nên nói 'phần cache là miễn phí'?
- Q5Vì sao ước lượng số token của một đoạn tiếng Việt bằng cách đếm số từ trong câu là một cách làm nguy hiểm?
- Q6Một hệ thống có lưu lượng tăng gấp đôi, trong khi độ dài token vào/ra mỗi request không đổi. Cost/tháng và latency mỗi request thay đổi thế nào?
Bài tiếp theo: Privacy & prompt injection
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Eval & golden set — đo AI feature thay vì tin demo
Bài tiếpPrivacy và prompt injection khi thiết kế AI feature
Thảo luận & góp ý
Hỏi đáp về bài này