Agent trong AI: LLM + tool trong vòng lặp quyết định
Agent không phải phép màu: LLM + tool + vòng lặp quyết định. Mỗi vòng thêm chi phí và nhân xác suất lỗi — nên nhiều bài toán chỉ cần một lần gọi model là đủ.
TL;DR: "Agent" không phải một model thông minh hơn mà là một kiến trúc. Vẫn LLM đó, thêm danh sách tool mô tả bằng text, đặt vào một vòng lặp: model đọc trạng thái, quyết định gọi tool hay trả lời, kết quả tool nối vào context, rồi lặp lại. "Quyết định" ấy vẫn chỉ là sinh text đúng định dạng gọi hàm, cùng cơ chế next-token prediction. Agent làm được điều một lần gọi không làm được (tra dữ liệu mới, gọi API, tính toán thật), đổi lại mỗi vòng thêm token, thêm độ trễ và nhân dồn xác suất lỗi. Việc gọn trong một lần gọi (phân loại, trích xuất, tóm tắt) thì không cần agent; chỉ dùng agent khi số bước không biết trước và phụ thuộc kết quả bước trước.
Team dev một ngân hàng dựng bot nội bộ trả lời QA về trạng thái giao dịch test trên UAT. Câu hỏi đầu dễ: "Giao dịch mã TXN-88213 đang ở trạng thái gì?" Dán kết quả một lần gọi API vào prompt, hỏi model, xong. QA hỏi tiếp: "Hôm nay user U-4471 có giao dịch nào bị treo (pending) quá 10 phút không, và log lỗi ghi gì?" Câu này không trả lời được bằng một cục dữ liệu dán sẵn. Phải để model tự tra nhiều lần.
Bài này tháo "agent" ra xem gồm những gì, nó mạnh hơn một lần gọi ở đâu, và phải trả thêm gì cho sức mạnh đó.
1. Analogy — nhờ trợ lý đặt vé máy bay
Bạn gọi tổng đài hỏi: "Chuyến VN209 ngày 15/8 giá bao nhiêu?" Nhân viên tra bảng giá và đọc ngay con số. Một câu hỏi, một câu trả lời.
Giao việc mở hơn thì khác: "Tìm chuyến rẻ nhất tuần sau, hết chỗ phổ thông thì thử ngày kế, tìm được thì đặt luôn." Nhân viên phải tra giá ngày thứ nhất, hết chỗ thì tự quyết tra ngày kế, so các lần tra rồi mới đặt. Mỗi bước phụ thuộc kết quả bước trước, và phải tự biết lúc nào dừng.
| Đời thường | Agent |
|---|---|
| Hỏi giá một chuyến cụ thể, đọc ngay từ bảng có sẵn | Một lần gọi model, không cần vòng lặp |
| Giao việc mở, tự tra nhiều lần dựa trên kết quả lần trước | Model tự quyết định gọi tool nào tiếp theo |
| Phải biết dừng đúng lúc, không tra vô thời hạn | Vòng lặp cần giới hạn số bước và điểm dừng an toàn |
| Mỗi cuộc gọi tra thêm tốn thời gian, cước phí | Mỗi vòng lặp cộng thêm token: chi phí và độ trễ |
Một lần gọi model giống hỏi giá một chuyến bay cụ thể. Agent giống giao việc mở cho người phải tự tra nhiều lần rồi mới quyết: làm được nhiều hơn, nhưng tốn hơn và có thể tra sai đường.
Thử ngẫmtổng đài chỉ có đúng một nhân viên, vừa tra giá vừa tự quyết lúc nào thôi tìm chuyến rẻ hơn. Khách hàng có cách nào biết nhân viên đã tìm đủ kỹ chưa?
2. Agent gồm những mảnh nào?
Agent không phải một loại model khác hay một "bộ não" tách riêng khỏi LLM. Nó ghép ba thứ:
- Một LLM, vẫn đúng cơ chế cũ: dự đoán token kế tiếp khả dĩ nhất từ văn bản đứng trước.
- Danh sách tool, mô tả bằng văn bản (tên hàm, tham số, tác dụng) và đưa vào cùng prompt. Model không "biết gọi hàm"; nó chỉ được dạy rằng khi cần dữ liệu ngoài, câu trả lời đúng là sinh text theo khuôn gọi hàm đó.
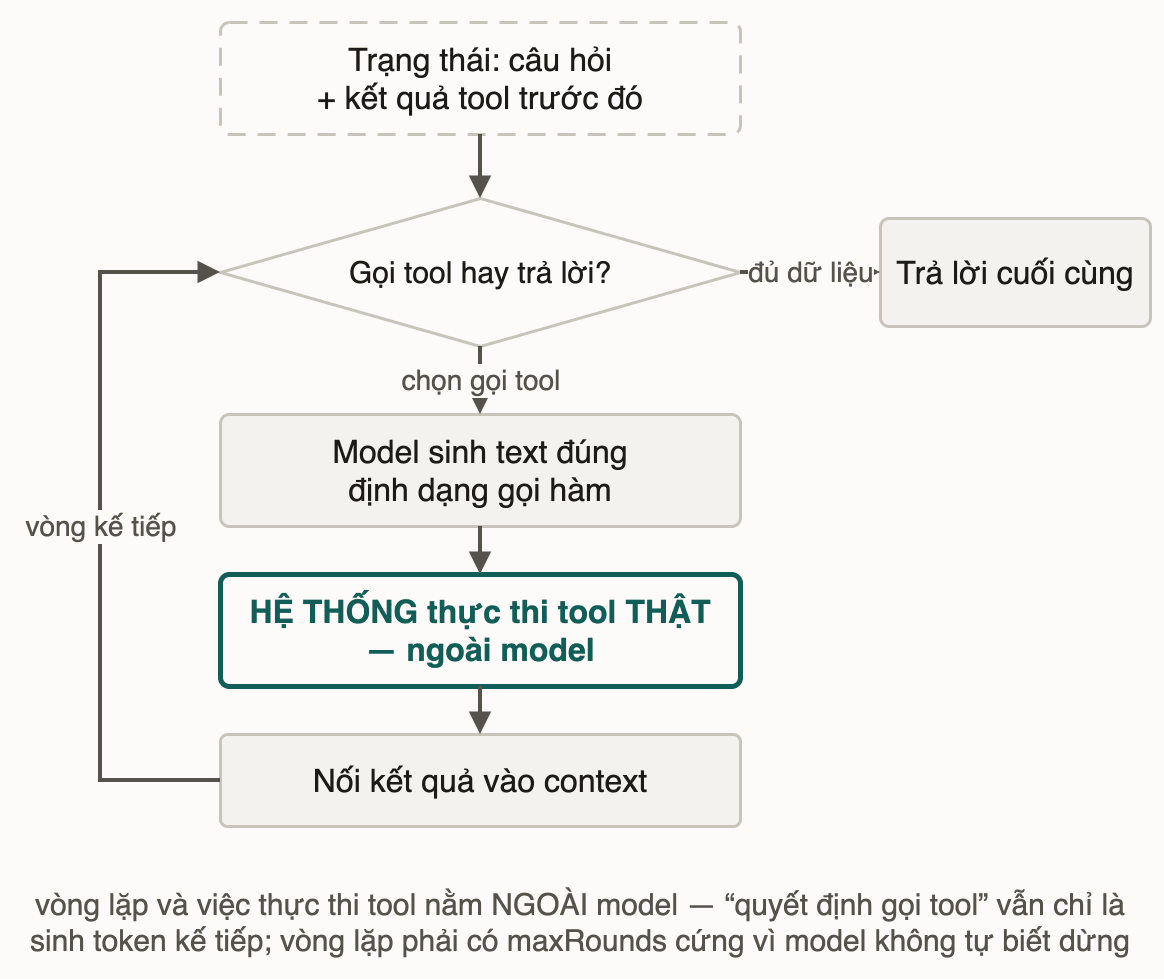
- Một vòng lặp ở tầng hệ thống, nằm ngoài model: đọc trạng thái, nhận quyết định "trả lời" hay "gọi tool X"; nếu gọi tool thì hệ thống thực thi tool thật, nối kết quả vào context rồi lặp lại.
"Quyết định" gọi tool nào vì vậy không phải một bước suy luận riêng. Nó vẫn là next-token prediction, đúng cơ chế bài hallucination đã dạy.
Model không có khái niệm đúng/sai, chỉ chọn token khả dĩ nhất theo phân phối xác suất. Khi context không đủ để chốt phân phối đó, model vẫn phải sinh một token; trong agent, token đó có thể là một lệnh gọi tool sai.
function runAgent(question, tools, maxRounds):
    context <- [question]                        -- lich su: cau hoi + ket qua tool truoc do
    for round in 1..maxRounds:
        decision <- LLM.generate(context, tools)  -- van la du doan token ke tiep
        if decision is "answer":
            return decision.content
        else:
            toolName, args <- parse(decision)      -- doc dung dinh dang goi ham model sinh ra
            result <- executeReal(toolName, args)  -- goi API/DB THAT, ngoai pham vi model
            context <- context + [decision, result]
    return "STOP: vuot maxRounds, chua co cau tra loi chac chan"
// Time: O(maxRounds) lan goi model    Space: O(maxRounds) token tich luy trong context
LLM.generate là chỗ duy nhất gọi tới model, phần còn lại là code hệ thống. Thiếu maxRounds, một model cứ chọn "gọi tool" mãi có thể lặp vô thời hạn và không bao giờ sinh "answer".
3. Agent làm được gì mà một lần gọi không làm được?
Một lần gọi model chỉ biết những gì nằm trong prompt cộng dữ liệu huấn luyện. Nó không tra được dữ liệu mới hoặc riêng tư, không gọi hành động thật ra ngoài (ghi log, gửi email), không tính toán chính xác trên dữ liệu lớn khi chưa biết trước có bao nhiêu bản ghi.
Agent giải cả ba bằng cách để model yêu cầu hệ thống làm hộ (tra API, chạy query, tính toán) rồi đọc kết quả thật để quyết bước tiếp theo. Câu hỏi thứ hai của QA cần đúng điều này: chưa biết trước có bao nhiêu giao dịch bị treo, và mỗi giao dịch tìm được lại cần tra thêm log riêng.
Thử ngẫmbot ngân hàng giờ tự tra hàng loạt giao dịch treo nhờ agent. Cái giá phải trả nằm ở đâu: số lần gọi model, hay độ chính xác của mỗi lần?
4. Cái giá: token cộng dồn và lỗi nhân dồn
4.1 Tổng token tăng theo bình phương số vòng
Mỗi vòng, hệ thống gửi lại toàn bộ lịch sử cho model, vì model không nhớ gì giữa các lần gọi. Giả sử (số minh hoạ) mỗi vòng cộng thêm khoảng 500 token: vòng 1 gửi khoảng 500, vòng 2 khoảng 1000, vòng 3 khoảng 1500... Sau 5 vòng, tổng là 500 + 1000 + 1500 + 2000 + 2500 = 7500 token, gấp 15 lần một lần gọi đơn chứ không phải gấp 5. Tổng dạng 1 + 2 + … + n tăng theo bình phương của n. Độ trễ cũng cộng dồn, vì các vòng chạy tuần tự, không song song được.
4.2 Xác suất lỗi nhân dồn
Giả sử mỗi bước đúng với xác suất 95%. Chuỗi 5 bước phụ thuộc nhau thì xác suất cả chuỗi đúng là 0,95⁵ ≈ 0,77, tức khoảng 77% chứ không phải 95%. Một bước bịa ra một con số thì bước sau đọc con số đó như sự thật đã xác nhận và xây tiếp trên nền sai, trừ khi hệ thống có bước kiểm lại riêng.
Hai con số trên là lý do giới hạn số vòng cộng điểm dừng an toàn (mục 2) là bắt buộc. Thiếu nó, agent vừa tốn token tăng theo bình phương, vừa dồn xác suất sai, vừa không tự dừng để báo "tôi không chắc".
5. Khi nào cần agent, khi nào chỉ cần một lần gọi?
Phần lớn bài toán hằng ngày gọn trong một lần gọi: mọi thông tin cần đã nằm sẵn trong prompt.
| Bài toán | Cách làm | Vì sao |
|---|---|---|
| Phân loại phản hồi tích cực/tiêu cực | Một lần gọi | Input tự đủ, không cần dữ liệu ngoài |
| Trích xuất tên/ngày/số tiền từ hoá đơn | Một lần gọi | Thông tin cần đã nằm trong văn bản đưa vào |
| Tóm tắt một tài liệu | Một lần gọi | Không cần hành động hay dữ liệu ngoài |
| Tra rồi tổng hợp nhiều nguồn, số lần tra không biết trước | Agent | Số bước phụ thuộc kết quả bước trước |
Quay lại câu hỏi QA ở đầu bài: "Hôm nay user U-4471 có giao dịch nào bị treo quá 10 phút không, và log lỗi ghi gì?" Bot có hai tool: listTransactions(userId, status) trả danh sách giao dịch của một user theo trạng thái, và getLogs(transactionId) trả log của một giao dịch. Dựa vào bảng trên, một lần gọi model có đủ không, hay cần vòng lặp agent? Nếu bot chỉ có getLogs thì sao?
Câu này cần agent. Bước đầu gọi listTransactions("U-4471", "pending") để biết có những giao dịch nào đang treo; trước lần gọi đó không ai biết danh sách dài bao nhiêu, nên không thể dán sẵn một cục dữ liệu đủ dùng. Sau đó, với mỗi giao dịch treo quá 10 phút, lại gọi getLogs một lần. Số vòng phụ thuộc kết quả bước đầu. Nếu bot chỉ có getLogs thì agent cũng bó tay: không tool nào liệt kê được giao dịch, và model không thể đoán mã giao dịch. Thiếu tool đúng thì vòng lặp nào cũng vô ích. Ngược lại, câu hỏi đầu ("giao dịch TXN-88213 đang ở trạng thái gì?") đã có sẵn mã, một lần tra là đủ, không cần vòng lặp.
6. Pitfall tổng hợp
❌ Nhầm 1 — coi agent "thông minh hơn" nên dùng cho mọi tính năng AI: agent đổi chi phí và độ trễ (mục 4) lấy khả năng xử lý số bước không biết trước (mục 3). Dùng cho bài toán phân loại chỉ thêm chi phí và thêm chỗ hỏng.
✅ Áp bảng mục 5 trước: dữ liệu cần đã nằm gọn trong một prompt thì một lần gọi rẻ hơn và ít chỗ hỏng hơn.
❌ Nhầm 2 — không đặt giới hạn số vòng, tin model "tự biết dừng": model không có tín hiệu nội tại nào phân biệt "đã đủ dữ liệu" với "cứ tra thêm cho chắc".
✅ Luôn đặt maxRounds cứng (pseudocode mục 2) và một nhánh dừng an toàn. Thà báo không chắc còn hơn lặp vô thời hạn hoặc bịa ra một câu trả lời tự tin.
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao và cộng sự, 2022) — bài báo gốc của mẫu xen kẽ "suy luận" và "hành động" mà vòng lặp mục 2 dựa trên.
- Building Effective AI Agents (Anthropic) — khuyến nghị bắt đầu từ giải pháp đơn giản nhất; nói thẳng hệ thống agent đổi độ trễ và chi phí lấy hiệu quả, và lỗi có thể cộng dồn qua các bước.
7. Liên hệ các bài khác
- Bài 01 — Nguyên tắc prompt — agent chỉ đặt thêm vòng lặp lên nền prompt tốt, không thay được prompt tốt.
- Bài 02 — Fine-tune khi nào — fine-tune không giải quyết chuyện thiếu dữ liệu mới lúc chạy; đó vẫn là việc của tool/agent.
- Bài 04 — Eval & golden set — agent nhiều bước hơn nghĩa là nhiều chỗ sai hơn; golden set đo được điều đó thay vì tin demo.
- Bài 05 — Cost & latency — bài này mới nêu hướng tăng của token (mục 4.1); bài 05 tính con số cụ thể.
- Bài 06 — Privacy và prompt injection — agent gọi tool thật mở thêm bề mặt tấn công so với một lần gọi chỉ sinh text.
8. Tóm tắt
- "Quyết định" gọi tool hay trả lời vẫn là next-token prediction; vòng lặp và việc thực thi tool nằm ở code hệ thống.
- Agent chỉ làm được việc mà tool của nó cho phép: thiếu tool liệt kê thì không vòng lặp nào tìm ra danh sách.
- 5 vòng, mỗi vòng thêm 500 token, tổng 7500 token (gấp 15 chứ không phải 5); 5 bước đúng 95% mỗi bước thì cả chuỗi đúng khoảng 77%.
- Luôn có
maxRoundsvà nhánh dừng an toàn; dùng agent khi số bước không biết trước, còn lại một lần gọi là đủ.
9. Tự kiểm tra
- Q1Vì sao "model quyết định gọi tool hay trả lời" vẫn là next-token prediction, không phải một bộ não suy luận riêng?
- Q2Một agent chạy 3 vòng lặp phụ thuộc nhau, mỗi vòng đúng 90%. Xác suất cả chuỗi đúng là bao nhiêu, vì sao thấp hơn 90%?
- Q3Vì sao vòng lặp agent bắt buộc có giới hạn số vòng tối đa, thay vì để model tự quyết định khi nào dừng?
- Q4Cho hai bài toán: (a) phân loại phản hồi tích cực/tiêu cực, (b) tìm mọi đơn hàng trễ giao trong tuần và gửi email nhắc từng nhà cung cấp. Bài nào cần agent, và agent (b) cần tối thiểu những tool gì?
- Q5Vì sao tổng token của agent 5 vòng lặp là gấp khoảng 15 lần một lần gọi đơn, không phải gấp 5?
- Q6Một bot chỉ cần trả lời "hoá đơn này tổng cộng bao nhiêu tiền" từ văn bản hoá đơn dán sẵn trong prompt — có cần xây thành agent không?
Bài tiếp theo: Eval & golden set — đo thay vì tin demo
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Fine-tune model — khi nào xứng đáng, khi nào không
Bài tiếpEval & golden set — đo AI feature thay vì tin demo
Thảo luận & góp ý
Hỏi đáp về bài này