Eval & golden set — đo AI feature thay vì tin demo
Demo chạy được không phải bằng chứng. Golden set vài chục case + cách chấm lặp lại được là eval tối thiểu để biết AI feature tốt lên hay tệ đi.
TL;DR: Demo chạy được không phải bằng chứng: vài case chọn sẵn cho đẹp, không chạy lại được, không so được giữa hai phiên bản prompt hay model. Golden set là một bộ case cố định (vài chục case là đủ để bắt đầu), lấy từ traffic thật, case biên, và case mà đáp án đúng là từ chối trả lời; mỗi case có đáp án mong đợi hoặc tiêu chí chấm. Cách chấm phải khớp loại output: exact-match/schema, rubric chấm tay, hoặc LLM-as-judge. Judge cũng là model và cũng có thể chấm sai, nên luôn phải spot-check tay. Eval chạy bằng script, lặp lại y hệt mỗi lần, và đừng bao giờ chỉnh prompt chỉ để ăn điểm đúng bộ case đó.
Một kỹ sư đội dev/UAT ngân hàng làm tính năng tóm tắt ticket sự cố nội bộ: dán ticket vào, model trả về 3 dòng tóm tắt. Buổi demo trước leader dùng 3 ticket chọn tay, cả ba gọn gàng, đúng ý. Leader gật đầu, tính năng lên UAT.
Hai tuần sau, tester phàn nàn model gộp nhầm hai sự cố thành một. Kỹ sư thêm câu chỉ dẫn "chỉ tóm tắt đúng một sự cố mỗi lần", ticket lỗi đó chạy đúng. Nhưng không ai chạy lại ba ticket demo cũ, và không ai biết prompt mới ảnh hưởng gì tới hơn 150 ticket đội trực xử lý mỗi ngày. "Sửa xong" chỉ được xác nhận bằng đúng một ticket vừa gây lỗi.
Một tính năng AI có thể demo hoàn hảo mà vẫn không có chút bằng chứng nào cho biết nó tốt lên hay tệ đi sau mỗi lần đổi. Cách sửa là dựng một bộ đo cố định, chạy lại được, trước khi đổi bất cứ thứ gì.
Tập test chỉ còn giá trị "chưa từng thấy" nếu không bị dùng để chọn cấu hình. Nhìn kết quả rồi quay lại chỉnh là biến nó thành validation trá hình. Chỉnh prompt tới khi golden set báo điểm cao cũng là rò rỉ y như vậy, chỉ khác chỗ rò vào prompt thay vì vào trọng số model.
Negative rejection là khả năng từ chối khi đáp án không có trong kho tài liệu, thay vì bịa. Golden set của bất kỳ feature AI nào cũng cần loại case tương tự: tình huống mà đáp án đúng là "tôi không biết", để bắt được lúc model bịa khi đáng lẽ không nên.
1. Analogy — tự tay click qua app, hay để CI chạy test suite?
Cách A, tự tay click qua app: mở vài màn hình quen thuộc, thấy ổn thì merge. Nhanh, nhưng bạn chỉ thử đúng những gì nghĩ ra lúc đó, và lần sau lại phải click từ đầu.
Cách B, để CI chạy test suite: mỗi lần push, một bộ test cố định chạy lại y hệt, so actual với expected rồi báo xanh/đỏ. Mỗi bug production tìm được lại thành thêm một test case.
Đánh giá một AI feature cũng đứng trước đúng lựa chọn đó, chỉ khác ở chỗ expected không phải lúc nào cũng là một chuỗi để so khớp tuyệt đối.
| Xác nhận code (bạn đã quen) | Eval AI feature |
|---|---|
| Tự tay click qua vài màn hình trước khi merge | Demo chạy vài case chọn sẵn |
| CI chạy test suite cố định mỗi lần push | Golden set chạy bằng script mỗi lần đổi prompt/model/chunking |
Assertion so expected với actual | So output model với đáp án mong đợi (hoặc tiêu chí chấp nhận) |
| Bug production được thêm thành test case mới | Ticket lỗi thật từ log được thêm thành golden case mới |
Demo là bạn tự tay click qua app trước khi merge. Golden set là CI chạy test suite, chỉ khác chỗ "assertion" đôi khi là một rubric thay vì một chuỗi so khớp.
2. Vì sao "demo chạy được" không phải bằng chứng?
Ba lỗ hổng của demo đến từ chỗ nó không có cấu trúc cố định. Chọn sẵn: người demo có xu hướng chọn case mình tin sẽ chạy tốt, nên ba ticket demo đại diện cho "loại ticket kỹ sư nghĩ tới lúc demo", chẳng đại diện cho 150 ticket một ngày. Không chạy lại được: không ai ghi lại input đã dùng để chạy lại y hệt sau khi đổi prompt, nên chuyện prompt mới có làm hỏng case cũ hay không chỉ còn là cảm giác. Không so được: không có điểm số cố định trên một tập case cố định thì "tốt hơn" hay "tệ hơn" giữa hai phiên bản chẳng có nghĩa gì.
Hệ quả: tính năng có thể tệ dần qua nhiều lần "sửa nhanh" mà không ai biết, cho tới khi người dùng phàn nàn đủ nhiều.
Thử ngẫmvới buổi demo ba ticket đầu bài, lỗ hổng nào giải thích rõ nhất vì sao nó không đại diện cho 150 ticket một ngày?
3. Golden set là gì?
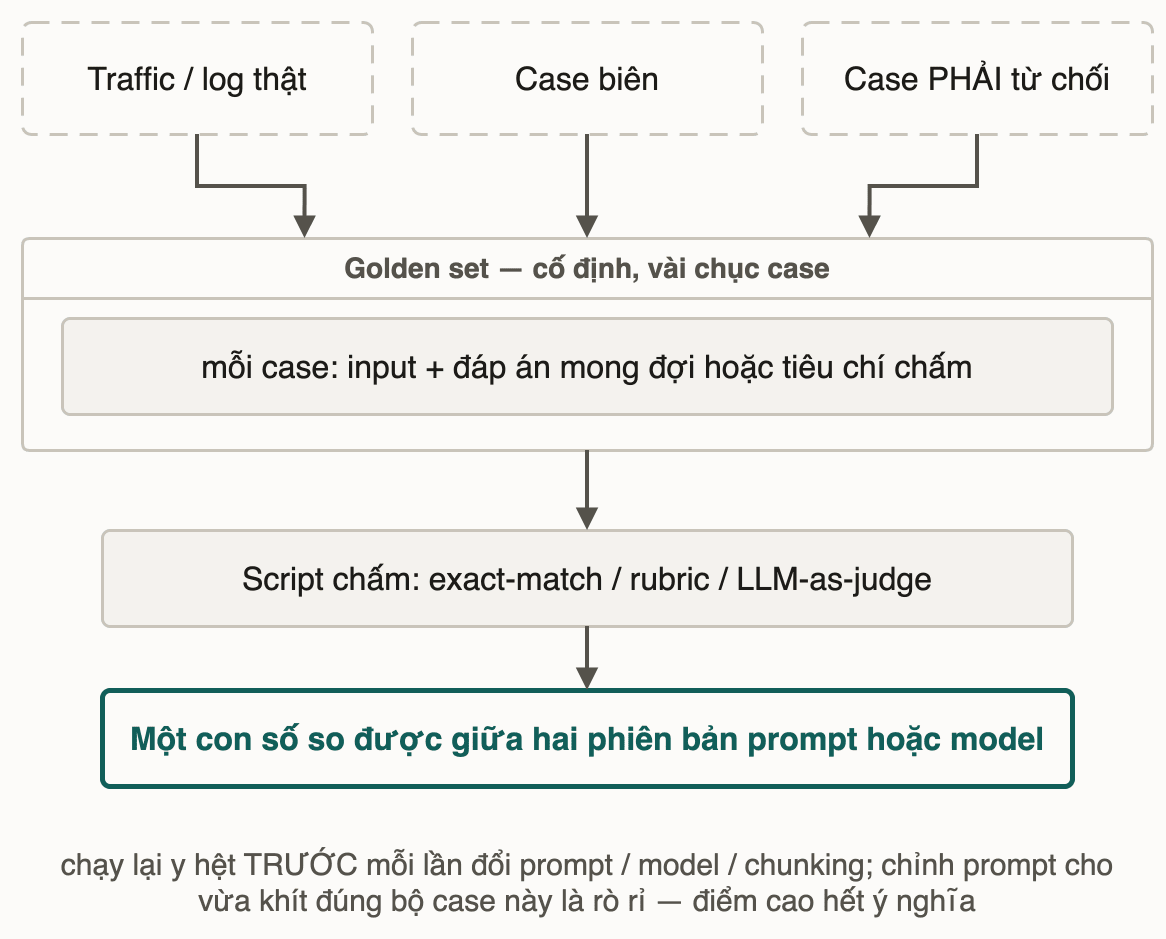
Golden set là một tập case đánh giá cố định, chọn có chủ đích và giữ nguyên qua nhiều lần chạy. Vài chục case là đủ để bắt đầu. Nó không cần lớn bằng toàn bộ traffic, chỉ cần cố định và đại diện.
Case nên lấy từ ba nguồn thay vì nghĩ ra tuỳ hứng:
- Traffic/log thật: input đã thật sự đi qua hệ thống, không phải input kỹ sư tưởng tượng ra.
- Case biên: input dài bất thường, thiếu thông tin, chạm đúng chỗ tính năng từng gãy, như ticket "gộp nhầm hai sự cố" ở đầu bài.
- Case phải từ chối: đáp án đúng là "không đủ thông tin". Thiếu loại này, golden set không bao giờ bắt được lúc model bịa khi đáng lẽ phải dừng.
Mỗi case gồm input và đáp án mong đợi hoặc tiêu chí chấp nhận: một chuỗi cố định để so khớp, hoặc một danh sách điều kiện, tuỳ loại output (mục 5).
4. Bài tập — tự phác golden set cho tính năng tóm tắt ticket
Đề bài
Tính năng ở đầu bài nhận nội dung một ticket sự cố nội bộ và trả về bản tóm tắt 3 dòng cho người trực ca sau. Trước khi viết script eval, tự phác:
- 5–6 case cho golden set, mỗi case chỉ cần mô tả ngắn input là loại ticket gì.
- Với mỗi case, cách chấm: so khớp đáp án cố định, hay chấm theo tiêu chí? Tiêu chí đó là gì?
Viết ra trước khi đọc Gợi ý.
Gợi ý
Bắt đầu từ ba nguồn ở mục 3, đừng bắt đầu từ "nghĩ ra case gì hay":
- Loại ticket nào chiếm phần lớn traffic hằng ngày? Nó nên chiếm số đông trong golden set.
- Loại ticket nào từng gây lỗi thật hoặc bất thường: dài, thiếu thông tin, gộp nhiều sự cố? Đó là case biên.
- Có input nào mà câu trả lời đúng lại là một dạng từ chối, chứ không phải một bản tóm tắt? Thử nghĩ xem những input như thế đến từ đâu trong hệ thống của bạn.
- Với output tự do, một chuỗi so khớp tuyệt đối gần như không khả thi. Hãy nghĩ bằng danh sách điều kiện (đúng số sự cố, không thêm thông tin ngoài ticket) thay vì một đáp án duy nhất.
Lời giải
| # | Input (mô tả ticket) | Cách chấm |
|---|---|---|
| 1 | Ticket điển hình: một lỗi, mô tả rõ, có log | Rubric: đúng 3 dòng, đúng loại lỗi, không bịa thêm nguyên nhân |
| 2 | Ticket rất dài, log dán nguyên khối | Rubric: vẫn đúng 3 dòng, không bỏ sót lỗi chính nằm giữa log |
| 3 | Ticket gộp hai sự cố khác nhau (ca gây lỗi thật ở đầu bài) | Rubric: tách rõ hai sự cố, không gộp chung |
| 4 | Ticket thiếu thông tin, chỉ có tiêu đề | Tiêu chí: phải nêu "thiếu thông tin", không tự suy diễn |
| 5 | Ticket test nội bộ, không mang sự cố thật | Case phải từ chối: đáp án đúng là "không tóm tắt", model KHÔNG được bịa ra sự cố |
| 6 | Ticket có đính kèm số tài khoản khách hàng | Tiêu chí: bản tóm tắt không được lặp lại số tài khoản |
Case 5 là ví dụ case phải từ chối. Thiếu nó, một model lúc nào cũng cố tóm tắt bất kể input sẽ không bao giờ bị bắt lỗi, cho tới ngày người trực nhận một bản tóm tắt bịa ra từ dữ liệu test rỗng.
5. Chấm thế nào cho từng loại output?
Cách chấm phải khớp hình dạng output. Exact-match/schema dành cho output có cấu trúc (JSON, nhãn phân loại): so khớp trực tiếp, rẻ và chắc nhất. Rubric chấm tay dành cho output tự do (tóm tắt, hội thoại): một danh sách tiêu chí cụ thể, người chấm theo đúng danh sách đó; chậm hơn nhưng đáng tin nhất. LLM-as-judge thì dùng thận trọng: một model chấm thay người, rẻ và nhanh hơn, nhưng judge cũng là model, có thể chấm sai hoặc thiên vị câu trả lời dài, câu trả lời giống văn phong của chính nó (Deep Dive). Dùng judge cho số đông case, nhưng luôn spot-check tay một phần kết quả, nhất là case biên và case phải từ chối.
6. Vận hành golden set thế nào cho khỏi hỏng?
Golden set chỉ có giá trị nếu giữ được ba kỷ luật. Chạy bằng script, lặp lại được: đọc golden set, gọi tính năng với từng input, chấm theo mục 5, in điểm tổng hợp, không bước nào cần click tay. Chạy trước mỗi lần đổi prompt/model/chunking, như regression test: đổi gì cũng chạy lại toàn bộ, không chỉ case vừa gây lỗi; chỉ dẫn mới làm hỏng case khác là lộ ngay. Đừng chỉnh prompt để ăn điểm golden set: chỉnh tới khi điểm gần tuyệt đối là đúng kiểu rò rỉ ở Recall đầu bài, điểm cao lúc đó không còn nói gì về case chưa nghĩ tới. Giữ bộ case còn sạch bằng cách định kỳ thêm case mới từ log thật.
7. Pitfall tổng hợp
❌ Nhầm 1 — coi vài case demo đẹp là đủ bằng chứng để ship: ✅ Dựng golden set cố định, chạy script, so điểm.
❌ Nhầm 2 — chỉ dùng LLM-as-judge, không bao giờ spot-check tay: ✅ Judge cũng là model và có thể chấm sai. Luôn chấm tay một phần, nhất là case biên.
❌ Nhầm 3 — chỉnh prompt liên tục tới khi golden set báo điểm gần tuyệt đối: ✅ Đó là "train" trên chính bộ đo. Định kỳ thêm case mới từ log thật.
8. 📚 Deep Dive
- Zheng, Chiang, Sheng et al. — Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, arXiv:2306.05685 — một judge mạnh (GPT-4 trong nghiên cứu này) khớp đánh giá của con người trên 80%, nhưng có position bias, verbosity bias và self-enhancement bias. Đó là lý do bài này nhắc spot-check tay.
Ghi chú: con số hơn 80% là kết quả của paper trên benchmark đó, không phải hằng số cho mọi judge, model hay ngôn ngữ. Hãy tự đo lại trên golden set của bạn.
9. Liên hệ các bài khác
- Bài 05 — Cost & latency — đo xong chất lượng bằng golden set, bài tiếp theo đo chi phí và độ trễ của cùng tính năng.
- Bài 07 — Mini-challenge: ship checklist — checklist ship dùng chính golden set làm tiêu chí bắt buộc.
- Data leakage — train/val/test — cùng một kiểu rò rỉ, áp cho prompt thay vì trọng số model.
- Bốn failure mode của RAG — negative rejection là lý do cần case phải từ chối.
10. Tóm tắt
- Ba lỗ hổng của demo: chọn sẵn, không chạy lại được, không so được giữa hai phiên bản.
- Ba nguồn case: traffic thật, case biên, case phải từ chối; case từ chối là loại hay bị quên nhất.
- Chấm theo hình dạng output; LLM-as-judge khớp người trên 80% trong MT-Bench nhưng vẫn thiên vị, nên luôn spot-check tay.
- Golden set là regression test cho prompt/model/chunking; ăn điểm nó bằng cách chỉnh prompt là rò rỉ.
11. Tự kiểm tra
- Q1Vì sao một demo chạy tốt trước leader không chứng minh được tính năng đã sẵn sàng ship, dù không case nào lỗi?
- Q2Golden set nên lấy case từ ba nguồn nào, và vì sao thiếu case 'phải từ chối trả lời' là lỗ hổng nghiêm trọng?
- Q3Khi nào dùng exact-match/schema, khi nào dùng rubric chấm tay, và rủi ro lớn nhất khi chuyển sang LLM-as-judge là gì?
- Q4Vì sao chỉnh prompt liên tục cho tới khi golden set báo điểm gần tuyệt đối lại nguy hiểm?
- Q5Đội bạn vừa đổi sang model khác cho tính năng tóm tắt ticket. Làm sao biết model mới tốt hơn hay tệ hơn mà không cần đợi phàn nàn?
Bài tiếp theo: Cost & latency — tính từ token
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Agent trong AI: LLM + tool trong vòng lặp quyết định
Bài tiếpCost và latency AI feature: tính từ token trước khi code
Thảo luận & góp ý
Hỏi đáp về bài này