Tổng kết: Tầng quyết định — và cả khoá AI Core
Khép module cuối và cả khoá: từ bản đồ AI đến cỗ máy LLM, transformer, RAG và tầng quyết định của engineer — kèm self-assessment theo learning outcomes.
TL;DR: Module 6 đi qua sáu quyết định của engineer khi ra mắt một AI feature: viết prompt bám cơ chế, biết khi nào fine-tune xứng đáng, hiểu agent và cái giá của nó, đo chất lượng bằng golden set, tính cost/latency từ token, và chẩn đoán rủi ro privacy/injection. Đây cũng là bài khép cả khoá AI Core, sáu module đi từ "AI là gì" tới "tự ra quyết định kiến trúc". Một trang để bookmark.
Đã đi qua những gì
Bạn bắt đầu từ bài 01 với ba nguyên tắc prompt bám cơ chế model: cấu trúc rõ để model tách lệnh khỏi dữ liệu, ví dụ đúng dạng để model bắt chước pattern, tách bước suy luận để tận dụng tính autoregressive. Chúng bền hơn mẹo câu chữ, thứ hết linh ở đời model sau. Bài 02 trả lời câu hỏi tự nhiên tiếp theo: fine-tune dịch chuyển trọng số nên dạy được hành vi lặp lại, nhưng không nạp dữ kiện mới đủ tin cậy; lỗi định dạng thì thử structured outputs trước, và cái giá thật là data nhãn sạch, catastrophic forgetting, một vòng đời vận hành lặp lại. Bài 03 tháo "agent" ra thành ba mảnh (LLM, danh sách tool bằng text, một vòng lặp ở tầng hệ thống): làm được nhiều hơn một lần gọi, đổi lại tổng token tăng theo bình phương số vòng và xác suất lỗi nhân dồn.
Bài 04 chuyển sang đo lường: demo chạy được không phải bằng chứng, golden set gồm case thường gặp, case biên và case phải từ chối mới là phép đo lặp lại được. Bài 05 tính cost và latency thẳng từ số token vào/ra bằng hai công thức, và giải thích vì sao token ra đắt hơn: decode tuần tự, bị giới hạn bởi băng thông bộ nhớ. Bài 06 chẩn đoán hai lớp rủi ro riêng: prompt là dữ liệu gửi đi và chịu retention của bên thứ ba, còn prompt injection lọt được vì vai trò system/user chỉ là ranh giới mềm, nên chỉ có guardrail giảm thiểu. Bài 07 ráp tất cả vào một scenario chatbot ngân hàng thật, buộc bạn tự viết ra kiến trúc, golden set, cost/latency, privacy/injection và fallback trước khi xem lời giải.
🗺️ Cheat sheet
| Concept | Khi nào cần nhớ | Pitfall |
|---|---|---|
| Ba nguyên tắc prompt (cấu trúc, few-shot, chain-of-thought) | Viết prompt cần bền qua nhiều phiên bản model | Sưu tầm "câu thần chú" thay vì bám cơ chế model |
| Structured outputs | Output phải đúng một JSON schema để code phía sau parse | Cố ép định dạng chỉ bằng prompt, hoặc fine-tune để chữa lỗi shape |
| Fine-tune vs RAG | Model cần học hành vi lặp lại, hay cần biết dữ kiện mới | Coi fine-tune là cách nạp "cơ sở dữ liệu nội bộ" vào model |
| Agent (LLM + tool + vòng lặp) | Số bước xử lý không biết trước, phụ thuộc kết quả bước trước | Dùng agent cho việc gọn trong một lần gọi; thiếu tool cần thiết |
| Golden set & LLM-as-judge | Cần biết feature tốt lên hay tệ đi sau mỗi lần đổi prompt/model | Tin vài case demo chọn sẵn là đủ bằng chứng để ship |
| Cost/latency từ token vào/ra | Ước lượng hoá đơn và độ trễ trước khi viết code | Đếm từ tiếng Việt rồi suy ra số token |
| Prompt injection (direct/indirect) | Prompt hoặc RAG có dữ liệu từ nguồn không đáng tin | Tin "system prompt viết chặt" là chặn được injection |
| Checklist ship 5 phần | Trước khi đưa bất kỳ AI feature nào lên production | Ship khi còn thiếu một trong năm phần, không riêng gì code |
📖 Glossary module
| Thuật ngữ | Định nghĩa 1 câu |
|---|---|
| Delimiter | Nhãn/thẻ phân tách vùng chỉ dẫn với vùng dữ liệu trong prompt, định dạng mà model chat được dạy để đọc (ranh giới mềm) |
| Few-shot | Đưa vài ví dụ input–output đúng định dạng vào context để model bắt chước pattern, không cần cập nhật trọng số |
| Chain-of-thought | Yêu cầu model viết bước suy luận trung gian trước kết luận, để các bước đó thành context cho token kết luận |
| Structured outputs | Khai báo JSON schema để lúc decode model chỉ được sinh token hợp lệ với schema, bảo đảm output đúng shape |
| Fine-tune | Train tiếp một base model trên dữ liệu riêng, dịch chuyển trọng số để dạy hành vi lặp lại |
| Catastrophic forgetting | Model sa sút ở khả năng không nằm trong tập fine-tune, vì trọng số bị kéo mạnh về phía tập hẹp vừa train |
| Staleness | Khoảng cách giữa thứ model "biết" (bản chụp trọng số lúc train) và thứ đang đúng ở hiện tại |
| Agent | Kiến trúc ghép một LLM, danh sách tool mô tả bằng text, và một vòng lặp hệ thống đọc, quyết, thực thi rồi lặp lại |
| maxRounds | Giới hạn số vòng lặp tối đa của agent, bắt buộc vì model không có tín hiệu nội tại để tự biết lúc nào nên dừng |
| Golden set | Bộ case đánh giá cố định, chọn có chủ đích từ traffic thật, case biên và case phải từ chối, để đo lặp lại được |
| Negative rejection | Năng lực từ chối khi không có đủ thông tin thay vì bịa; golden set đo nó bằng nhóm case phải từ chối |
| Rubric | Danh sách tiêu chí cụ thể để chấm nhất quán những output tự do không có một đáp án đúng duy nhất |
| LLM-as-judge | Dùng một model khác chấm output thay người: rẻ và nhanh hơn, nhưng có thể chấm sai hoặc thiên vị nên cần spot-check tay |
| TTFT (time-to-first-token) | Khoảng chờ từ lúc gửi request tới lúc token đầu tiên của câu trả lời xuất hiện |
| Prefill | Bước model xử lý toàn bộ token vào trong một lượt tính song song |
| Decode | Vòng lặp sinh token ra tuần tự, mỗi bước đọc lại trọng số và KV cache nên bị giới hạn bởi băng thông bộ nhớ |
| Prompt caching | Lưu phần đầu cố định của prompt; đọc lại từ cache vẫn tính phí nhưng rẻ hơn nhiều, còn lần ghi cache thì đắt hơn giá thường |
| PII | Thông tin định danh cá nhân (số tài khoản, số điện thoại, tên...), không được vào prompt khi chưa masking |
| Prompt injection | Cài chỉ dẫn giả vào dữ liệu model sẽ đọc, khiến model làm theo lệnh giả thay vì chỉ dẫn hệ thống thật (LLM01:2025) |
| Indirect injection | Prompt injection đi qua dữ liệu retrieve về hoặc tài liệu cần xử lý, không qua ô nhập liệu trực tiếp của người dùng |
| Instruction hierarchy | Việc model được huấn luyện để ưu tiên chỉ dẫn system hơn nội dung user/tool; là ranh giới mềm, có thể bị vượt |
| Least privilege | Giới hạn quyền tool/API của agent đúng theo nhu cầu tác vụ, không cấp quyền rộng "phòng khi cần" |
⚠️ Pitfall tổng hợp
1. Sưu tầm "câu thần chú" (hứa tip, đóng vai chuyên gia) thay vì bám cơ chế:
Hiệu ứng của chúng ăn theo quirk huấn luyện của một model cụ thể, mất tác dụng hoặc đảo chiều ở đời sau. Ba nguyên tắc bám cơ chế (cấu trúc, few-shot, chain-of-thought) thì còn đúng qua nhiều đời model.
2. Yêu cầu suy luận từng bước nhưng không ràng buộc định dạng output cuối:
Model lan man, có khi quên luôn kết luận. Luôn kèm cấu trúc output ngay sau yêu cầu suy luận, và bật structured outputs nếu API có.
3. Coi fine-tune là cách nạp "cơ sở dữ liệu nội bộ" vào model:
Fine-tune dạy hành vi, không nạp dữ kiện đủ tin cậy; nạp dữ kiện mới là việc của RAG.
4. Dùng chung một đợt dữ liệu vừa để fine-tune vừa để đánh giá:
Đúng kiểu rò rỉ dữ liệu: điểm đánh giá chỉ phản ánh chuyện học thuộc đợt dữ liệu đó, không nói gì về khả năng tổng quát.
5. Coi "agent thông minh hơn" nên dùng cho mọi tính năng AI:
Agent đổi chi phí và độ trễ lấy khả năng xử lý số bước không biết trước. Việc gọn trong một lần gọi mà dựng agent thì chỉ thêm chi phí và thêm chỗ hỏng.
6. Tin vài case demo chọn sẵn là đủ bằng chứng để ship:
Case demo không đại diện traffic thật, không chạy lại được, không so được giữa hai phiên bản. Golden set mới là bằng chứng còn giá trị theo thời gian.
7. Chỉnh prompt liên tục cho tới khi golden set báo điểm gần tuyệt đối:
Đó là "train" trên chính bộ đo, điểm cao không còn chứng minh gì về case chưa nghĩ tới. Định kỳ thêm case mới từ log thật thay vì tối ưu cho khớp một bộ case cố định.
8. Tưởng streaming giảm cost hoặc giảm tổng thời gian sinh:
Streaming chỉ đổi cách hiển thị; tổng token, tổng thời gian và tổng tiền giữ nguyên. Người dùng thấy nhanh hơn, hệ thống thì không nhanh hơn.
9. Nghĩ "system prompt viết chặt" là chặn được prompt injection:
System prompt được ưu tiên nhờ huấn luyện, nhưng vẫn chỉ là token trong cùng một chuỗi; sự ưu tiên đó có thể bị vượt, nên không đủ chống indirect injection qua dữ liệu retrieve về.
✅ Self-assessment
Bạn đã đạt module này nếu trả lời được:
- Bạn có viết được một prompt cấu trúc rõ (vai trò, ví dụ đúng dạng, tách bước suy luận) bám vào cơ chế model thay vì chỉ áp mẹo câu chữ không?
- Nếu chưa: đọc lại bài 01 mục 2.
- Bạn có giải thích được khi nào fine-tune xứng đáng chi phí, vì sao nó không nạp nổi dữ kiện mới đủ tin cậy, và cái giá catastrophic forgetting + staleness là gì không?
- Nếu chưa: đọc lại bài 02 mục 2–4.
- Bạn có giải thích được agent là gì (LLM cộng tool cộng vòng lặp) và vì sao nó tốn chi phí, dồn rủi ro lỗi hơn một lần gọi model không?
- Nếu chưa: đọc lại bài 03 mục 2 và 4.
- Bạn có tự dựng được một bộ eval tối thiểu bằng golden set (case thường gặp, case biên, case phải từ chối) thay vì chỉ tin vào demo không?
- Nếu chưa: đọc lại bài 04 mục 3–5.
- Bạn có ước lượng được cost và latency của một AI feature từ số token vào/ra, và biết đòn bẩy nào giảm được biến nào không?
- Nếu chưa: đọc lại bài 05 mục 2 và 5.
- Bạn có chẩn đoán được rủi ro privacy và prompt injection của một thiết kế AI feature cụ thể bằng khung OWASP LLM Top 10 không?
- Nếu chưa: đọc lại bài 06 mục 2–3 và 6.
- Bạn có tự thiết kế được một checklist ship tối thiểu (kiến trúc, eval, cost, privacy, fallback) cho một AI feature thật, chứ không chỉ liệt kê từng khái niệm rời rạc không?
- Nếu chưa: đọc lại bài 07 phần Lời giải.
🎓 Cả khoá AI Core: nhìn lại sáu module
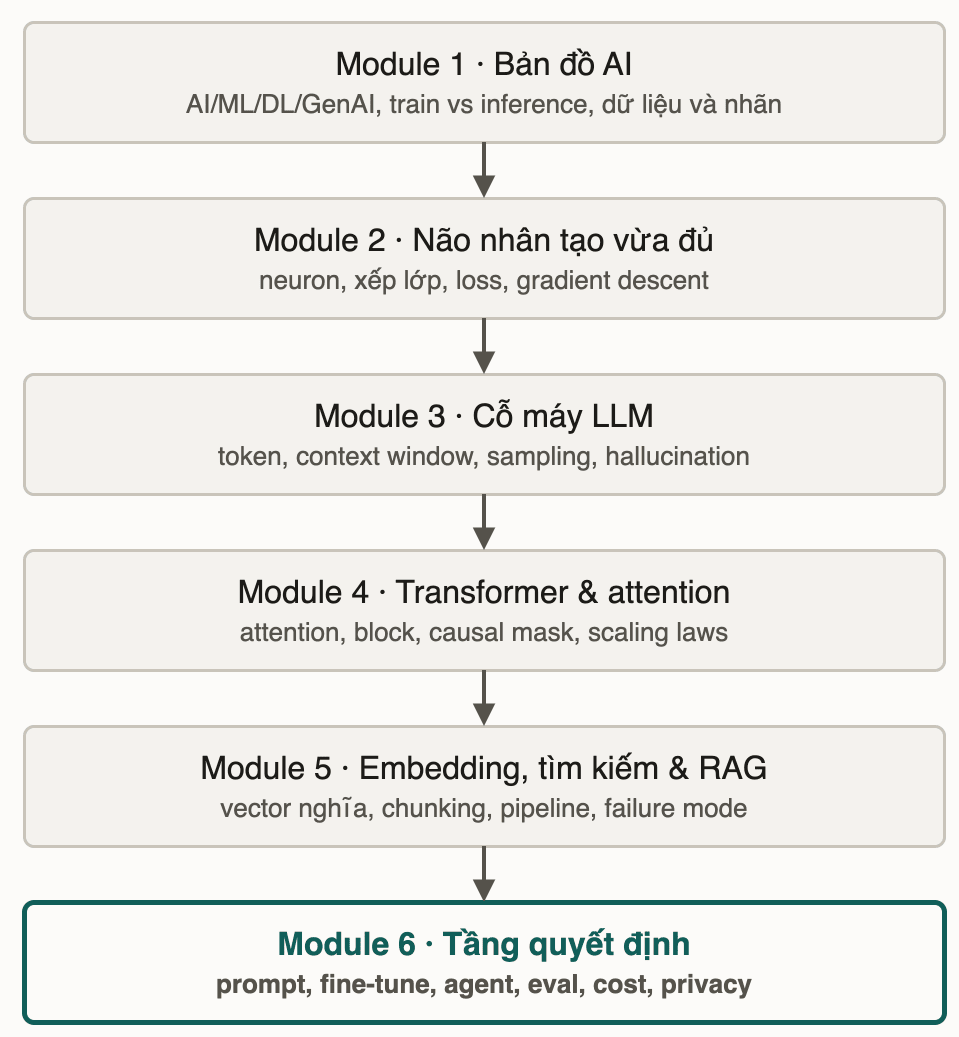
Khoá AI Core đi đúng một đường: định vị AI trên bản đồ lớn (module 1), cơ chế học của mạng neural (module 2), cách một LLM sinh văn bản từng token và vì sao nó bịa (module 3), kiến trúc transformer đứng sau khả năng đó (module 4), rồi cách nối model với dữ liệu riêng qua embedding và RAG (module 5). Module 6 là điểm đến: mọi cơ chế đó dồn về sáu quyết định mà một engineer thật sự phải ra khi ship một AI feature.
Thông điệp chốt của cả khoá: tên framework và API đổi liên tục theo từng quý, còn cỗ máy bên dưới thì không. Token được sinh ra thế nào, vì sao model bịa, embedding đo "gần nghĩa" ra sao, mỗi quyết định kiến trúc tốn bao nhiêu thật: hiểu tới mức đó thì tài liệu của một framework ra mắt tuần sau bạn đọc là hiểu, khỏi chờ ai giải thích lại từ đầu.
🚀 Bước tiếp theo
- Áp checklist ship (bài 07) vào một AI feature thật ở công ty bạn. Không cần chờ dự án lớn; một tính năng nhỏ (tóm tắt, trích xuất, chatbot nội bộ) cũng đủ để kiểm cả năm phần: kiến trúc, eval, cost, privacy, fallback.
- Muốn tự code Spring AI (RAG, tool calling, ChatClient) thay vì chỉ ra quyết định kiến trúc: khoá Spring Deploy, Architecture & AI có module Spring AI riêng, hiện đang sắp ra mắt trên nền tảng. Nội dung module 6 này là nền tư duy cần có trước khi vào phần code.
- Không có "module 7" nào sau đây trong AI Core. Khoá dừng ở đúng điểm một engineer cần: đủ hiểu cơ chế để tự ra quyết định, tự đọc tài liệu mới, và tự chất vấn một AI feature trước khi ship.
📚 Tài liệu mở rộng
- Paper — prompt: Brown et al. — Language Models are Few-Shot Learners (arXiv:2005.14165); Wei et al. — Chain-of-Thought Prompting Elicits Reasoning in Large Language Models (arXiv:2201.11903); Liu et al. — Lost in the Middle (arXiv:2307.03172)
- Paper — fine-tune vs RAG: Ovadia et al. — Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs (arXiv:2312.05934), EMNLP 2024
- Paper — agent: Yao et al. — ReAct: Synergizing Reasoning and Acting in Language Models (arXiv:2210.03629); Anthropic — Building Effective AI Agents
- Paper — eval: Zheng, Chiang, Sheng et al. — Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (arXiv:2306.05685)
- Paper — prompt injection: Greshake et al. — Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection (arXiv:2302.12173)
- Khung tham chiếu: OWASP Top 10 for LLM Applications 2025
- Docs chính chủ: Anthropic — Prompt caching; Anthropic — Streaming Messages
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Thảo luận & góp ý
Hỏi đáp về bài này