Fine-tune model — khi nào xứng đáng, khi nào không
Fine-tune dạy được hành vi — format, giọng điệu, domain — nhưng không nạp nổi dữ kiện mới đáng tin. Cái giá: data nhãn, catastrophic forgetting, vòng đời vận hành.
TL;DR: Fine-tune là train tiếp một model trên dữ liệu riêng. Nó dịch chuyển trọng số, nên dạy được hành vi: format, giọng điệu, thuật ngữ domain, cách ánh xạ dữ liệu. Nó không phải cách nạp dữ kiện mới đáng tin, vì kiến thức trong trọng số vừa mờ vừa đứng yên ở thời điểm train; việc đó thuộc về RAG. Cái giá gồm data nhãn sạch, catastrophic forgetting và một vòng đời vận hành lặp lại mỗi khi model gốc đổi bản. Trước khi tính tới fine-tune, hãy thử những cách rẻ hơn: structured outputs cho lỗi định dạng, few-shot cho hành vi quy mô nhỏ.
Đội tester một ngân hàng dán log giao dịch thô vào chat để model quy về JSON nội bộ chuẩn. Mỗi ngày vài trăm dòng trong đợt UAT, và con số cứ tăng. Prompt đã kèm ba ví dụ mẫu, model đúng phần lớn thời gian, nhưng cứ vài chục log lại lệch schema: sai kiểu amount, thiếu status, hoặc chèn thêm câu giải thích khiến downstream không parse được.
Câu hỏi tự nhiên là "vậy fine-tune model đi cho xong". Bài này trả lời nghiêm túc cho cả ca trên lẫn những ca nghe rất giống mà fine-tune chẳng giúp được gì.
1. Ba tình huống ngân hàng — fine-tune có giúp không?
Cả ba ở môi trường dev/UAT nội bộ, không dùng dữ liệu khách hàng thật. Với mỗi tình huống, tự trả lời có/không kèm một câu vì sao trước khi đọc mục 2.
Tình huống A — chuẩn hoá log giao dịch test. Đúng ca mở bài: model trả JSON theo schema nội bộ (transactionId, amount, currency, status) từ log thô, hàng trăm dòng mỗi ngày và tăng dần suốt đợt UAT.
Tình huống B — trả lời câu hỏi về API mới. Đội dev vừa ra mắt endpoint /api/v3/refund tuần trước, muốn chatbot trả lời đúng field, đúng status code của endpoint này.
Tình huống C — chuẩn hoá report cho một team nhỏ. Team 3 người muốn report tuần luôn đúng định dạng, gọi model chừng 20 lần mỗi ngày.
Viết ra cho cả ba: fine-tune có giúp không, và vì sao. Đây là dạy hành vi hay nạp dữ kiện? Nếu là hành vi, đã có cách nào rẻ hơn chưa thử?
Analogy — đào tạo nhân viên theo quy trình nội bộ
Đào tạo nhân viên theo quy trình nội bộ dạy được cách làm (mẫu báo cáo, giọng email), không dạy được tin tức sáng nay: cái đó phải đọc bản tin đầu ngày. Học dồn quy trình mới còn có thể làm quên vài thói quen cũ vốn tốt.
| Đời thường | Trong bài |
|---|---|
| Đào tạo nội bộ: dạy cách làm, không dạy tin tức | Fine-tune |
| Bản tin đầu ngày: luôn mới | RAG |
| Học dồn, quên thói quen cũ tốt | Catastrophic forgetting |
2. Fine-tune thay đổi cái gì trong model?
Fine-tune train tiếp một base model trên cặp input/output do bạn chọn, thay vì khối văn bản khổng lồ của pretraining. Mỗi bước train chỉnh trọng số để output khớp ví dụ hơn.
Trọng số là hàng tỷ con số phân tán, không phải bảng tra cứu chèn/xoá được, nên fine-tune giỏi đúng một việc: hành vi lặp lại. Giọng điệu nhất quán, thuật ngữ domain, cách ánh xạ log lạ về đúng trường là khuôn mẫu xuyên suốt tập ví dụ, và khuôn mẫu thì train được vào trọng số.
Nhưng cũng chính cơ chế đó khiến fine-tune không phải cách đáng tin để nạp dữ kiện mới. Một chi tiết như "endpoint /api/v3/refund nhận field reasonCode" không nằm ở một ô trọng số nào cả; nó hoà vào hàng tỷ tham số, và model "nhớ" đúng tới đâu thì rất mờ. Ovadia và cộng sự (Fine-Tuning or Retrieval?, EMNLP 2024) so sánh hai cách nạp kiến thức và thấy RAG vượt fine-tune ở cả kiến thức cũ lẫn mới. Lưu ý phạm vi: paper đo fine-tune không giám sát (train tiếp trên văn bản thô), khác supervised fine-tune trên cặp log→JSON có nhãn như ở đây. Kết luận về nạp dữ kiện vẫn áp được, vì lý do cơ chế ở trên không phụ thuộc cách gán nhãn.
Còn một trục thời gian ẩn: trọng số là bản chụp cố định tại lúc train xong. Dữ kiện phát sinh sau đó (API mới, policy vừa đổi) không "vào" được cho tới lần fine-tune tiếp theo. Đó là staleness, khoảng cách giữa thứ model biết và thứ đang đúng bây giờ. Tình huống B vì vậy không cần fine-tune: endpoint mới phải có mặt ngay và còn đúng khi đổi tiếp, là việc của RAG chứ không phải train lại mỗi lần docs đổi.
Tình huống A: thử structured outputs trước đã
Nhìn kỹ ba triệu chứng của A: sai kiểu amount, thiếu status, chèn câu giải thích. Cả ba là lỗi shape, tức output không khớp schema. Loại lỗi này có cách chữa rẻ hơn nhiều: nếu API hỗ trợ structured outputs (khai báo JSON schema, lúc decode model chỉ được sinh token hợp lệ với schema), cả ba triệu chứng biến mất ở tầng decode mà không cần train gì.
Fine-tune cho A chỉ còn đáng bàn khi phần lỗi còn lại nằm ở nội dung mà schema không bắt được: log lạ bị ánh xạ nhầm trường, quy ước nội bộ về trạng thái "treo" bị hiểu sai, và lỗi đó lặp đều ở quy mô lớn. Đó là hành vi, và mục 4 bàn chuyện quy mô.
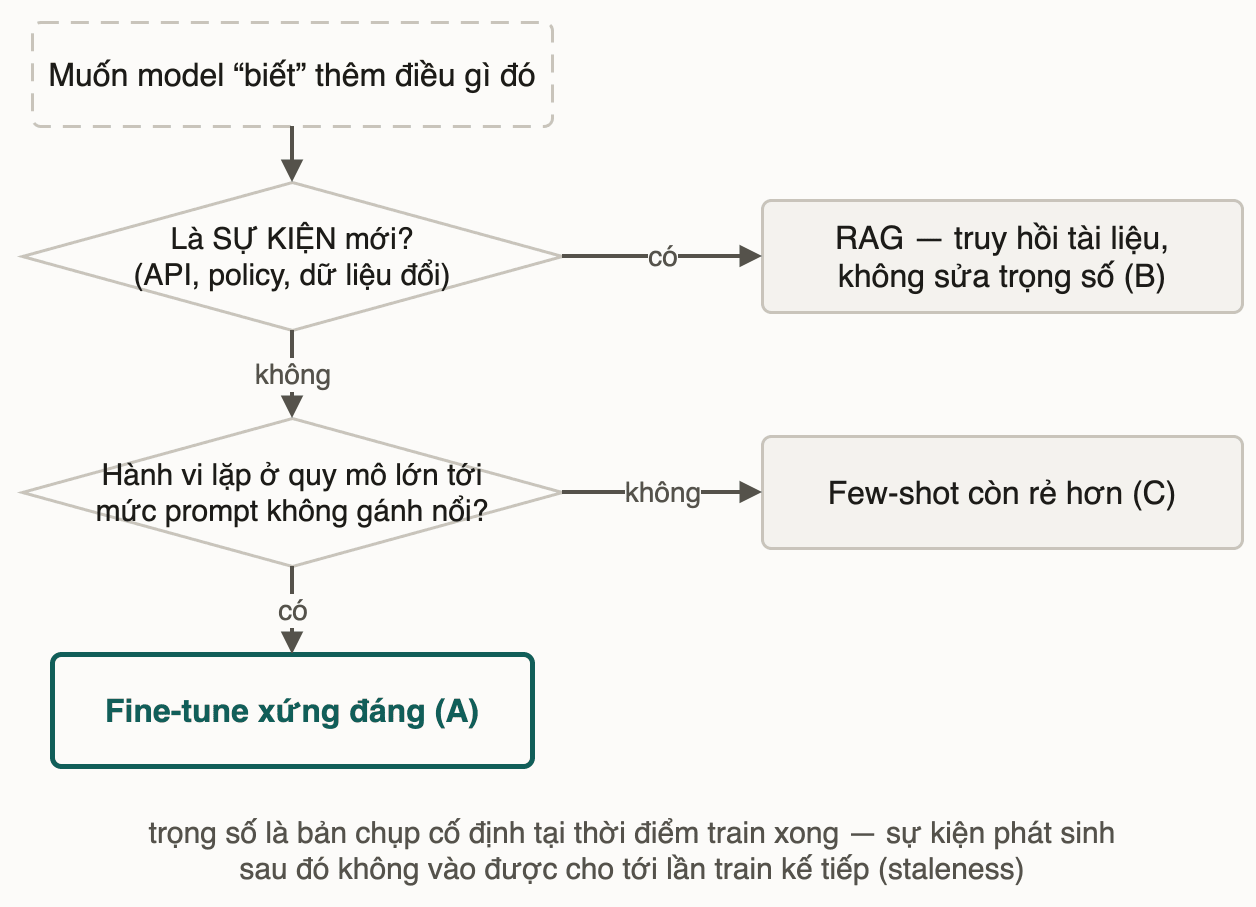
Tình huống C chưa trả lời ở đây. Câu hỏi của C không nằm ở "hành vi hay dữ kiện" (rõ ràng là hành vi) mà ở chỗ hành vi đó có đáng chi phí không. Mục 4 quay lại nó.
Thử ngẫmmột trường fine-tune chatbot tuyển sinh bằng tài liệu năm ngoái. Học phí vừa đổi tuần trước. Chatbot có tự biết không?
3. Cái giá thật của fine-tune
3.1 Data gán nhãn chất lượng
Bài đó dạy hai điều áp thẳng vào đây. Nhãn sai thì model học sai mà chẳng compiler nào bắt. Và tách train/validation/test phải làm TRƯỚC khi chạm dữ liệu: eval rút từ cùng đợt log với train thì điểm "đúng 98%" chỉ phản ánh học thuộc đợt log đó, không phải khả năng tổng quát.
Với tình huống A, "data nhãn" nghĩa là vài trăm cặp log thô → JSON chuẩn đã được review xác nhận đúng, không phải vài ví dụ viết vội trong prompt.
3.2 Catastrophic forgetting
Train tiếp trên một tập hẹp (chỉ log giao dịch, một định dạng) kéo mạnh trọng số về phía tối ưu cho tập đó, và có thể kéo lệch khả năng tổng quát học từ pretraining. Đó là catastrophic forgetting: model giỏi hẳn ở việc vừa train nhưng có thể sa sút ở việc từng làm tốt mà không nằm trong tập fine-tune, ví dụ trò chuyện tự nhiên. Chỗ sa sút thường chỉ lộ ra khi người dùng đụng phải.
3.3 Vòng đời vận hành
Base model sẽ được thay bằng bản mới, và mỗi lần như vậy bạn phải train lại rồi đánh giá lại từ đầu, vì hành vi học trên bản cũ không đảm bảo giữ nguyên trên bản khác.
| Khoản chi phí | Khi nào phát sinh | Vì sao dễ bị bỏ sót |
|---|---|---|
| Data nhãn sạch | Trước khi train | Trông như "chỉ cần vài ví dụ", thực ra cần review và tách tập đúng |
| Catastrophic forgetting | Sau khi train, phát hiện muộn | Chỉ lộ ra ở việc KHÔNG nằm trong tập fine-tune |
| Train lại theo vòng đời | Mỗi lần base model đổi bản | Dễ tưởng "train một lần là xong" |
4. Khi nào hành vi lặp lại xứng đáng fine-tune?
Quay lại tình huống C: team 3 người, khoảng 20 lần gọi mỗi ngày. Đây là hành vi lặp lại, nhưng ở quy mô nhỏ: vài ví dụ mẫu (few-shot) cộng structured outputs cho khung report đã đủ ổn định, và rẻ hơn nhiều so với gán nhãn, train rồi nuôi cả vòng đời fine-tune. Câu trả lời là chưa đáng, vì quy mô chưa tới ngưỡng.
Tình huống A khác ở quy mô: hàng trăm log mỗi ngày và đang tăng. Giả sử đã bật structured outputs mà vẫn còn log bị ánh xạ nhầm đều đặn. Mỗi request vẫn chở theo ba ví dụ mẫu dài, tiền token cộng dồn theo từng lần gọi, mà vẫn sai lác đác. Tới một mức lưu lượng nào đó, train một lần sẽ rẻ hơn cái giá lặp lại kia.
Ba câu hỏi lọc, theo thứ tự:
- Hành vi lặp lại hay dữ kiện mới? Dữ kiện mới → dừng, dùng RAG (mục 2). Hành vi → đi tiếp.
- Lỗi nằm ở shape hay ở nội dung? Shape (thiếu trường, sai kiểu, chèn chữ thừa) → structured outputs, dừng. Nội dung → đi tiếp.
- Hành vi đó có lặp ở quy mô đủ lớn để prompt dài không gánh nổi? Nhỏ, few-shot còn rẻ và ổn định → chưa đáng (C). Lớn, few-shot đã lộ giới hạn hoặc tiền token vượt chi phí train và duy trì → fine-tune xứng đáng (A).
Có những kỹ thuật fine-tune rẻ hơn train lại toàn bộ trọng số (họ LoRA). Nhưng đó là câu hỏi làm thế nào, còn bài này trả lời câu hỏi khi nào.
5. Pitfall tổng hợp
❌ Nhầm 1 — coi fine-tune là cách nạp "cơ sở dữ liệu nội bộ" vào model: ✅ Fine-tune dạy hành vi, không nạp dữ kiện đáng tin. Trả lời đúng theo tài liệu công ty là việc của RAG.
❌ Nhầm 2 — fine-tune để chữa lỗi JSON sai định dạng: ✅ Lỗi shape thì bật structured outputs trước; fine-tune chỉ đáng bàn cho phần lỗi nội dung còn lại.
❌ Nhầm 3 — chỉ test đúng use case vừa fine-tune: ✅ Catastrophic forgetting lộ ra ở việc KHÔNG nằm trong tập fine-tune (3.2), nên giữ thêm một bộ eval tổng quát, rút từ đợt dữ liệu khác với đợt train.
6. 📚 Đào sâu
- Ovadia và cộng sự, Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs, EMNLP 2024 — so sánh fine-tune không giám sát với RAG cho việc nạp kiến thức; RAG thắng ở cả kiến thức có sẵn lẫn kiến thức mới.
7. Liên hệ các bài khác
- Mini-challenge — chọn kiến trúc cho ba bài toán thật — bảng đánh đổi prompt-only/RAG/fine-tune; bài này đào sâu riêng nhánh fine-tune.
- Dữ liệu, nhãn và ba tập không được trộn — nhãn sạch và tách tập đúng, áp vào mục 3.1.
- Bài 01 — Nguyên tắc prompt — structured outputs và few-shot, hai cách rẻ hơn cần thử trước.
- Bài tiếp theo — Agent: vòng lặp và công cụ — quyết xong model nên "biết" gì, tiếp theo là nó hành động ra sao.
8. Tóm tắt
- Fine-tune chỉnh trọng số trên ví dụ riêng, hợp để dạy hành vi lặp lại; dữ kiện mới và dữ kiện hay đổi thuộc về RAG.
- Lỗi shape (thiếu trường, sai kiểu) giải bằng structured outputs ở tầng decode, trước khi nghĩ tới train.
- Ba khoản chi phí ẩn: data nhãn sạch và tách eval đúng, catastrophic forgetting ngoài tập fine-tune, train lại mỗi khi base model đổi bản.
- Ba câu lọc: hành vi hay dữ kiện, shape hay nội dung, quy mô đã đủ lớn chưa.
9. Tự kiểm tra
- Q1Vì sao fine-tune dạy được 'luôn ánh xạ log lạ về đúng trường' nhưng không dạy được 'biết endpoint mới ra tuần trước'? Cả hai đều là thứ bạn muốn model biết thêm.
- Q2Giải thích staleness bằng chính cơ chế train: vì sao fine-tune hôm nay không giúp model 'biết' một chính sách công ty ban hành tuần sau?
- Q3Model trả JSON thỉnh thoảng thiếu trường status và chèn câu giải thích. Đồng nghiệp đề xuất fine-tune ngay. Bạn đề xuất thử gì trước, và vì sao?
- Q4Vì sao catastrophic forgetting thường bị phát hiện muộn, thay vì lộ ra ngay khi vừa fine-tune xong?
- Q5Team dùng chính đợt log giao dịch tuần này để vừa làm ví dụ fine-tune vừa làm ví dụ đánh giá 'model đã học đúng chưa'. Vì sao con số đánh giá đó không đáng tin, và cách sửa là gì?
- Q6Tình huống C (team 3 người, ~20 lần gọi/ngày, muốn report đúng định dạng) và tình huống A (hàng trăm log/ngày, chuẩn hoá JSON) đều là hành vi lặp lại. Vì sao câu trả lời fine-tune lại khác nhau giữa hai tình huống?
Bài tiếp theo: Agent — vòng lặp và công cụ
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Nguyên tắc prompt bám cơ chế: cấu trúc, ví dụ, tách suy luận
Bài tiếpAgent trong AI: LLM + tool trong vòng lặp quyết định
Thảo luận & góp ý
Hỏi đáp về bài này