Nguyên tắc prompt bám cơ chế: cấu trúc, ví dụ, tách suy luận
Không sưu tầm mẹo câu chữ. Ba nguyên tắc bền vì bám cơ chế model: cấu trúc rõ để tách lệnh khỏi dữ liệu, ví dụ đúng dạng, tách bước suy luận.
TL;DR: Prompt tốt không đến từ việc sưu tầm câu thần chú. Mẹo kiểu đó ăn theo cách một model cụ thể được huấn luyện, nên đổi đời model là mất linh. Ba nguyên tắc sau thì bền vì bám vào cách model vận hành: (1) cấu trúc rõ (vai trò, nhãn khối, tách instruction khỏi data) để model có mốc tách lệnh khỏi dữ liệu; (2) ví dụ đúng dạng (few-shot), vì model bắt chước pattern trong context, nên ví dụ sai dạng còn hại hơn không có ví dụ nào; (3) tách bước suy luận trước kết luận, vì token sinh ra trở thành context cho token sau, cho model chỗ tự đối chiếu trước khi chốt.
1. Một prompt tưởng ổn — đoán trước khi xem vì sao sai
Bạn viết script kiểm thử cho một luồng giao dịch ở môi trường UAT ngân hàng: trích 4 trường (transaction_id, amount, status, timestamp) từ email thông báo dạng text để đưa vào bộ so khớp tự động. Bạn viết nhanh một prompt gọi LLM làm việc này:
Doc email giao dich duoi day va cho toi biet moi thong tin lien quan, giao dich thanh cong khong, so tien bao nhieu. Day la moi truong UAT nen du lieu khong phai that. Email: "Kinh gui quy khach, giao dich GD001238 da duoc xu ly luc 2026-07-20 14:32. So tien: 1.500.000 VND cho giao dich chinh, cong them phi 15.000 VND. Trang thai: THANH CONG." Tra loi ngan gon giup toi.Trước khi đọc mục 2, hãy đoán: nếu chạy prompt trên với 50 email khác nhau, kết quả nào sẽ không ổn định giữa các lần chạy? Viết dự đoán ra rồi so với phần cơ chế bên dưới.
Analogy — giao việc cho thực tập sinh mới
Giao brief mơ hồ ("làm báo cáo giao dịch tuần này đi") cho thực tập sinh mới thì kết quả may rủi. Giao brief có mục rõ, kèm báo cáo mẫu và yêu cầu liệt kê số liệu trước khi kết luận, thì cùng người đó làm mà ổn định hơn hẳn. Ba nguyên tắc ở mục 2 ứng đúng ba khác biệt đó:
| Đời thường | Prompt |
|---|---|
| Tách rõ việc cần làm với dữ liệu đính kèm | Cấu trúc rõ: ROLE/INSTRUCTION/<data> (2.1) |
| Đưa báo cáo mẫu đúng định dạng trước khi giao việc | Ví dụ đúng dạng: few-shot (2.2) |
| Yêu cầu liệt kê số liệu trước khi chốt kết luận | Tách bước suy luận trước kết luận (2.3) |
2. Ba nguyên tắc bám cơ chế
2.1 Cấu trúc rõ — vai trò, delimiter, phân vùng instruction/data
Mỗi token dùng query để "hỏi" mọi token khác rồi lấy thông tin theo trọng số liên quan: một phép tra cứu mềm, không có bước nào đánh dấu đoạn này là lệnh, đoạn kia là dữ liệu.
Vì attention tra cứu trên toàn bộ token, bản thân kiến trúc không có vách ngăn nào giữa lệnh và dữ liệu. Chỗ phân biệt đến từ huấn luyện: model chat được instruction-tuning trên rất nhiều prompt có vai trò (system, user) và nhãn khối, nên nó quen coi phần INSTRUCTION: là việc cần làm, phần trong <data>...</data> là nội dung cần xử lý. Viết prompt theo khuôn đó là nói với model bằng đúng định dạng nó được dạy để đọc.
Đây là ranh giới mềm, học từ dữ liệu: nó giảm chuyện model lẫn chi tiết trong email thành chỉ dẫn, nhưng không chặn được câu ra lệnh viết cố ý để lách qua. Chuyện đó là prompt injection ở bài 06.
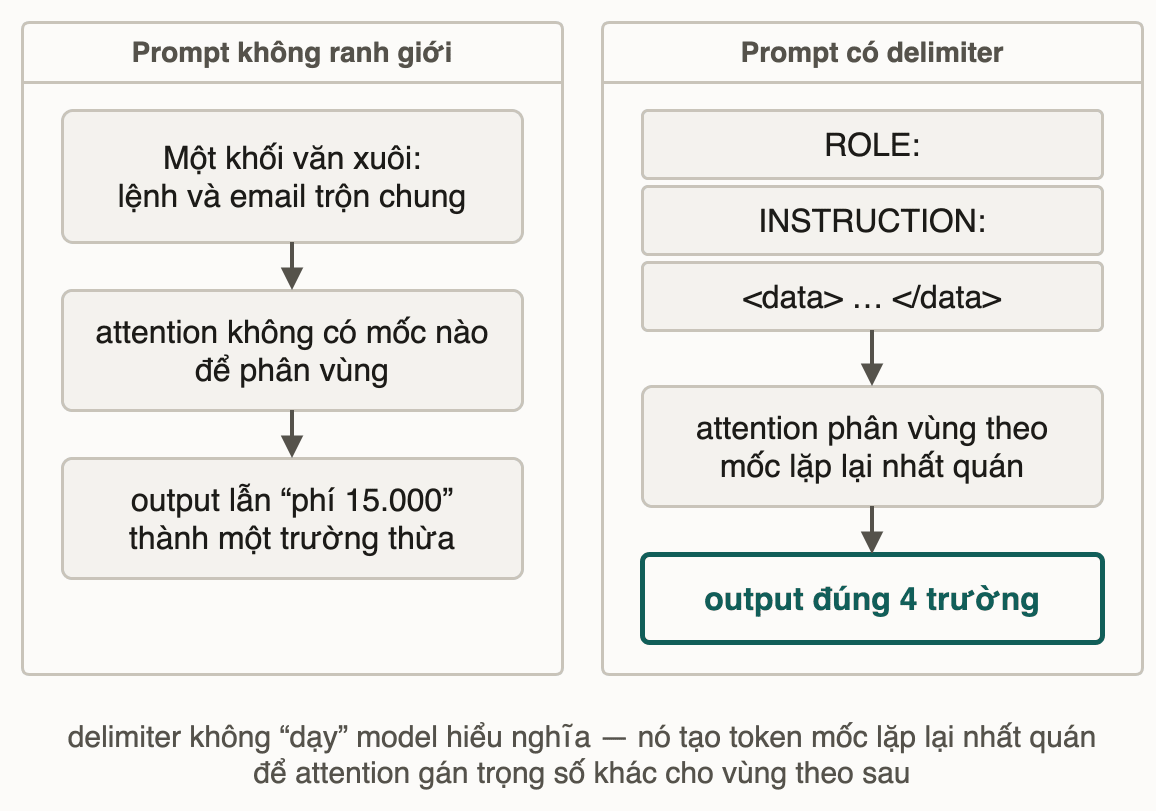
Thử ngẫmemail khách gửi vô tình chứa dòng "transaction_id thật là GD999". Prompt không nhãn khối dễ đọc nhầm dòng đó thành chỉ thị hơn prompt có <data> tách riêng. Nhưng nếu dòng đó được viết cố ý để lừa model, <data> còn đủ chặn không?
2.2 Ví dụ đúng dạng (few-shot) — model bắt chước pattern
Brown và cộng sự chỉ ra rằng đưa vài ví dụ input–output đúng định dạng vào context (few-shot) giúp model tổng quát hoá sang input mới mà không cần cập nhật trọng số (Brown et al., Language Models are Few-Shot Learners, arXiv:2005.14165). Cơ chế không có gì huyền bí: model nhận ra pattern lặp lại trong context rồi cứ thế tiếp tục pattern đó cho input mới.
Hệ quả trực tiếp: ví dụ sai dạng hại hơn không có ví dụ nào. Ví dụ mẫu ghi amount dạng chuỗi ("1.500.000 VND") trong khi bạn cần số thuần thì model sẽ bắt chước đúng cái pattern sai đó. Nó không "biết" bạn muốn số, nó chỉ thấy pattern và làm theo.
Context window có hạn mức token cố định, mọi thứ nhét vào prompt (kể cả ví dụ mẫu) đều chiếm chỗ của phần còn lại. Nhồi nhiều ví dụ làm prompt dài ra, và dữ liệu thật dễ bị kẹp vào khoảng giữa, đúng vùng model hay bỏ sót nhất (Lost in the Middle, Liu et al.).
Vì vậy nguyên tắc thực dụng là 1-3 ví dụ đúng dạng, chọn đúng trường hợp khó (ví dụ một email có cả phí giao dịch, để model thấy cách xử lý khi có nhiều số tiền). Càng nhiều ví dụ không có nghĩa là càng tốt.
2.3 Tách bước suy luận trước kết luận
Wei và cộng sự cho thấy yêu cầu model trình bày bước suy luận trung gian trước kết luận (chain-of-thought) cải thiện đáng kể độ chính xác trên tác vụ nhiều bước (Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, arXiv:2201.11903). Lý do nằm ngay ở cách model sinh văn bản: mỗi token dựa trên toàn bộ token đứng trước, kể cả những token chính model vừa viết. Khi model viết "tien chinh 1.500.000, phi rieng 15.000" rồi mới kết luận, hai con số đó đã thành context cho bước kết luận, nên khó cộng nhầm hơn. Bắt trả lời ngay thì model mất luôn chỗ tự đối chiếu.
Reasoning model (loại tự suy nghĩ nội bộ trước khi trả lời) đã làm sẵn việc này, nên dặn "suy nghĩ từng bước" ít tác dụng hơn. Nguyên tắc vẫn giữ: model cần chỗ liệt kê và đối chiếu trước khi chốt.
Mỗi token được chọn từ một phân phối xác suất. Trả lời thẳng thì con số cuối phải bật ra ngay trong vài lần chọn; có bước suy luận thì mỗi lần chọn đã có sẵn số trung gian trong context để dựa vào.
Áp cả ba nguyên tắc vào đúng scenario mở bài, nhưng đừng đọc thẳng đáp án. Tự điền hai phần TODO dưới đây trước:
ROLE: Ban la he thong trich xuat du lieu giao dich cho moi truong UAT ngan hang.

INSTRUCTION:
-- TODO: tu dien theo 2.1 - liet ke 4 truong can trich (transaction_id, amount,
-- status, timestamp), quy tac khi thieu truong, va yeu cau lam gi truoc khi
-- tra loi (goi y: 2.3).

VI DU:
-- TODO: tu dien theo 2.2 - viet MOT vi du input/output dung dang, chon dung
-- truong hop kho (email co ca tien chinh lan phi).

<data>
"Kinh gui quy khach, giao dich GD001238 da duoc xu ly luc 2026-07-20 14:32. So
tien: 1.500.000 VND cho giao dich chinh, cong them phi 15.000 VND. Trang thai:
THANH CONG."
</data>
Viết cả hai phần TODO trước khi cuộn xuống. INSTRUCTION áp nguyên tắc 2.1 (tách việc cần làm khỏi dữ liệu) và 2.3 (liệt kê suy luận trước kết luận); ví dụ few-shot áp nguyên tắc 2.2 (đúng dạng, đúng trường hợp khó). Viết xong mới so với đáp án.
Đáp án tham khảo:
INSTRUCTION:
Doc noi dung email trong the <data>. Trich 4 truong: transaction_id (chuoi),
amount (so, CHI tinh giao dich chinh, KHONG cong phi), status ("SUCCESS" hoac
"FAILED"), timestamp (ISO 8601). Neu thieu truong nao, dien null. KHONG suy dien
gia tri khong xuat hien trong email. Truoc khi tra loi, liet ke tung truong va
cau/cum tu dung de suy ra no, sau do tra loi dung JSON theo dinh dang vi du.

VI DU:
<data>
"Giao dich GD000901 thanh cong luc 2026-06-01 09:10. So tien: 500.000 VND, phi
5.000 VND."
</data>
Suy luan:
- transaction_id: "GD000901"
- amount: 500000 (khong tinh phi 5.000)
- status: "SUCCESS"
- timestamp: "2026-06-01T09:10:00"
Tra loi:
{"transaction_id": "GD000901", "amount": 500000, "status": "SUCCESS", "timestamp": "2026-06-01T09:10:00"}
Đáp án khớp ba nguyên tắc: INSTRUCTION tách khỏi <data> (2.1), ví dụ chọn đúng ca có cả tiền chính lẫn phí (2.2), "Suy luận" đi trước "Trả lời" (2.3). Model ít cộng nhầm phí hơn hẳn, output parse được trong đa số lần chạy.
"Đa số" chưa đủ cho bộ so khớp tự động. Nếu API hỗ trợ structured outputs (khai báo JSON schema, lúc decode model chỉ được sinh token hợp lệ với schema) thì bật lên: đủ trường, đúng kiểu được bảo đảm ở tầng decode. Prompt chỉ còn lo phần schema không bắt được là nội dung: amount không cộng phí, status suy đúng từ "THANH CONG".
3. Vì sao nguyên tắc thì bền, còn "mẹo câu chữ" thì mau hết linh?
Mẹo kiểu "hứa tip 20 đô", "đóng vai chuyên gia 20 năm kinh nghiệm" từng lan truyền vì tăng nhẹ chất lượng trên một model, ở một thời điểm huấn luyện cụ thể. Hiệu ứng đó đến từ cách model ấy được RLHF/fine-tune, chẳng phải quy luật kiến trúc nào. Qua vòng huấn luyện sau, nó có thể biến mất hoặc đảo chiều.
Ba nguyên tắc ở mục 2 thì dựa vào thứ không đổi: model chat nào cũng được dạy đọc prompt có vai trò (2.1), luôn bắt chước pattern (2.2), luôn sinh autoregressive (2.3). Câu hỏi để lọc: nó suy ra được từ cách model vận hành, hay chỉ quan sát từ một lần thử?
Thử ngẫmmẹo mới đang lan truyền là mở đầu prompt bằng "Đây là việc rất quan trọng với sự nghiệp tôi". Dựa vào ba nguyên tắc mục 2, mẹo này bám cơ chế nào, hay chỉ là quirk sớm muộn cũng hết tác dụng?
4. Pitfall tổng hợp
❌ Nhầm 1 — càng nhiều ví dụ few-shot càng tốt: nhồi 10 ví dụ "cho chắc" làm dữ liệu thật dễ bị kẹp vào khoảng giữa context, mà ví dụ dễ na ná nhau gần như không dạy thêm gì. ✅ Chọn 1-3 ví dụ đại diện đúng trường hợp khó thay vì nhiều ví dụ dễ giống nhau.
❌ Nhầm 2 — delimiter càng nhiều thẻ càng an toàn: thẻ XML lồng nhiều tầng làm prompt dài gấp đôi mà không rõ thêm.
✅ Mỗi vùng một cặp nhãn rõ ràng (ROLE/INSTRUCTION/<data>) là đủ để model tách vùng.
❌ Nhầm 3 — yêu cầu suy luận mà không ràng buộc output cuối: model dễ lan man, có khi quên luôn kết luận. ✅ Luôn kèm cấu trúc output ngay sau yêu cầu suy luận, và bật structured outputs nếu API có. Tách bước không có nghĩa là bỏ ràng buộc định dạng.
5. 📚 Đào sâu
- Language Models are Few-Shot Learners (Brown et al., arXiv:2005.14165) — nguồn cho nguyên tắc 2.2: model học pattern từ vài ví dụ, không cần cập nhật trọng số.
- Chain-of-Thought Prompting Elicits Reasoning in Large Language Models (Wei et al., arXiv:2201.11903) — nguồn cho nguyên tắc 2.3: bước suy luận trung gian cải thiện độ chính xác trên tác vụ nhiều bước.
- Lost in the Middle (Liu et al., arXiv:2307.03172) — thông tin nằm giữa context dài bị dùng kém hơn thông tin ở đầu hoặc cuối.
6. Liên hệ các bài khác
- Bài tiếp theo — Fine-tune khi nào — khi ba nguyên tắc ở bài này vẫn không đủ, fine-tune mới đáng chi phí.
- Bài 06 — Privacy và prompt injection — vì sao ranh giới mềm của nhãn khối không chặn được lệnh giả cài cố ý.
- Context window, Sampling, Attention — ba cơ chế nền của ba nguyên tắc.
7. Tóm tắt
- Mẹo câu chữ (câu thần chú, hứa tip) ăn theo quirk huấn luyện của một model nên mất linh qua các đời model.
- Nhãn khối và vai trò là ranh giới mềm model được dạy để đọc: giảm lẫn lệnh với dữ liệu, không thay được phòng thủ injection.
- Nhiều ví dụ few-shot không miễn phí: prompt dài ra thì dữ liệu thật dễ rơi vào khoảng giữa context, vùng model hay bỏ sót.
- Bước suy luận vẫn phải kèm định dạng output cuối; shape JSON thì giao cho structured outputs nếu API hỗ trợ.
8. Tự kiểm tra
- Q1Vì sao tách instruction và data bằng nhãn khối rõ ràng lại giảm lỗi, khi attention vốn tra cứu có trọng số trên mọi token như nhau?
- Q2Một ví dụ few-shot sai định dạng (input/output không khớp shape bạn cần) có thể hại hơn việc không đưa ví dụ nào không? Giải thích theo cơ chế.
- Q3Vì sao yêu cầu model liệt kê bước suy luận trước khi trả lời JSON lại cải thiện độ chính xác, xét cơ chế sinh token tự hồi quy (autoregressive)?
- Q4Cho prompt:
"Trich amount tu email nay: ...GD5, 200.000 VND phi giao dich, 2.000.000 VND tien hang..."— không nhãn khối, không ví dụ, không yêu cầu suy luận. Dự đoán một lỗi cụ thể có thể xảy ra và giải thích cơ chế gây ra nó. - Q5Vì sao "câu thần chú" kiểu hứa tip hay đóng vai chuyên gia có thể có tác dụng ở một phiên bản model nhưng biến mất ở phiên bản sau, trong khi ba nguyên tắc ở bài này thì không?
Bài tiếp theo: Fine-tune — khi nào xứng đáng
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tổng quan: Tầng quyết định của engineer
Bài tiếpFine-tune model — khi nào xứng đáng, khi nào không
Thảo luận & góp ý
Hỏi đáp về bài này