Hash function — Uniform, avalanche, và hashCode/equals contract
Override equals mà quên hashCode khiến HashSet.contains() trả false, một bug im lặng. Uniform distribution, avalanche effect và hashCode/equals contract.
TL;DR: Hash function (hàm băm, tức quy tắc biến một key thành một con số) ánh xạ key bất kỳ sang số nguyên để định vị bucket trong O(1) — nền móng của HashMap, HashSet, Bloom filter, distributed shard. Hai tính chất cốt lõi: uniform distribution (phân bố đều: output rải đều các bucket, không có bucket nào bị dồn) và avalanche effect (hiệu ứng tuyết lở: đổi 1 bit input thì khoảng 50% bit output đổi, nên key gần nhau không dồn cụm). Contract bắt buộc: nếu a.equals(b) thì a.hashCode() == b.hashCode(). Vi phạm thì HashMap lookup hỏng hẳn, không có exception nào, chỉ lặng lẽ trả kết quả sai.
Một junior Java dev viết class User với equals so sánh userId nhưng quên override hashCode. Unit test pass sạch. Deploy lên production thì userSet.contains(user) trả về false dù user đã add() vào set. HashMap dùng User làm key cũng hỏng y như vậy: put vào rồi get ra null. Không có exception, không có warning, chỉ có hành vi sai mà chẳng ai hay.
Bug này xuất hiện vì HashSet, HashMap, ConcurrentHashMap đều dựa vào hashCode() để định vị phần tử. hashCode sai thì mọi lookup đều thất bại, dù equals báo hai object "bằng nhau". Bài này đi từ trực giác hàm băm đến contract hashCode/equals, và vì sao bug này không báo lỗi gì.
1. Hình dung: Phòng đăng ký số thứ tự
Hình dung một phòng khám có N quầy phục vụ. Khi bệnh nhân vào, nhân viên phát số dựa trên một đặc điểm của bệnh nhân (số CMND, năm sinh) và chỉ họ đến quầy tương ứng.
Hash function là quy tắc phát số đó, biến đặc điểm của bệnh nhân thành chỉ số quầy. Bucket là quầy phục vụ. Khi cần tìm một bệnh nhân, bạn không phải hỏi cả N quầy mà chạy lại quy tắc phát số để biết họ ở quầy nào: tìm kiếm O(1) thay vì O(n).
| Phòng khám | HashMap |
|---|---|
| Bệnh nhân | Key (User, String, ...) |
| Quy tắc phát số | Hash function (hashCode()) |
| Quầy phục vụ | Bucket trong internal array |
| Phân bổ đều mỗi quầy | Uniform distribution |
| Đổi 1 chữ CMND → quầy hoàn toàn khác | Avalanche effect |
| Hai bệnh nhân cùng quầy | Hash collision |
Uniform nghĩa là mỗi quầy nhận xấp xỉ tổng số bệnh nhân chia N, không quầy nào bị ngộp. Avalanche nghĩa là đổi 1 ký tự trong CMND thì bệnh nhân bị chỉ sang một quầy hoàn toàn khác, chứ không phải quầy kế bên.
Hash function = quy tắc phân luồng. Uniform = tải chia đều. Avalanche = input đổi một chút thì output đổi rất nhiều.
2. Định nghĩa hash function
Hash function là hàm h: K -> int ánh xạ key bất kỳ sang một số nguyên trong khoảng cố định. Hash function dùng trong cấu trúc dữ liệu cần bốn tính chất:
| Tính chất | Ý nghĩa | Nếu thiếu |
|---|---|---|
| Deterministic | Cùng input luôn cho cùng output | Lookup không bao giờ tìm lại được key đã put |
| Fast | Tính được trong O(1) | Mỗi thao tác trên Map chậm theo độ dài key |
| Uniform distribution | Output rải đều bucket | Một bucket nhận phần lớn key → O(n) lookup |
| Avalanche effect | 1 bit input đổi → ~50% bit output đổi | Key gần nhau cluster vào cùng bucket |
Hash function cho cấu trúc dữ liệu không cần one-way (không suy ngược được input) hay collision-resistant (không thể tìm ra hai input cùng output); đó là yêu cầu của cryptographic hash như SHA-256. Map chỉ cần nhanh và đều; collision chấp nhận được, miễn là hiếm.
3. Uniform distribution
Uniform distribution nghĩa là với tập input ngẫu nhiên, output trải đều qua mọi bucket, không có "hot spot" (bucket bị dồn quá nhiều key).
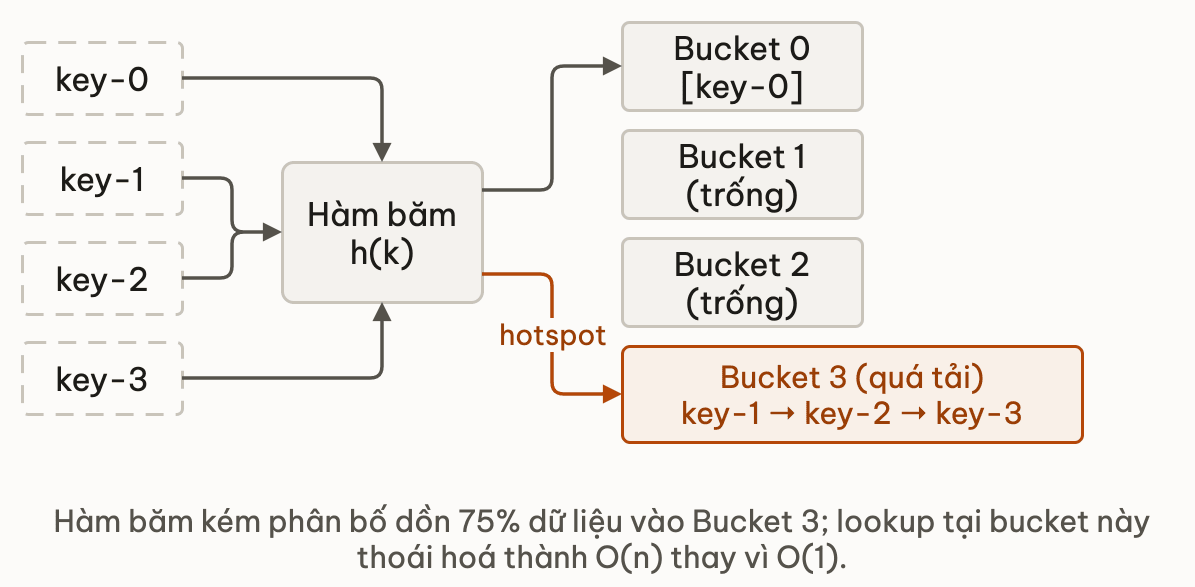
Hash function tệ thì một bucket có thể nhận 80% key trong khi bucket khác gần như trống. Map dùng chaining, mỗi bucket là một linked list, nên bucket quá tải sẽ có chain dài và lookup thành O(n) thay vì O(1).
Muốn đo thì rải N key vào M bucket rồi xem độ lệch:
-- Kiểm tra phân phối của hash function qua 16 bucket
-- Kỳ vọng: ~6250 key mỗi bucket (100_000 / 16)
buckets <- mảng kích thước 16, khởi tạo = 0
for i <- 0 đến 99_999:
    h <- hash("key" + i)
    idx <- h AND 15        -- tương đương mod 16 (power-of-2 trick)
    buckets[idx] <- buckets[idx] + 1
-- Kết quả đúng: mỗi bucket nhận khoảng 6100–6400 key
Time: O(n) Space: O(M)
Với hash function đơn giản như h(k) = k % capacity, capacity là 8 và key là 0, 8, 16, 24..., tất cả đều rơi vào bucket 0, thành worst case O(n). Hash function tốt phải trộn bit để tránh chuyện này.
Thử ngẫmở callout trên, h(k) = k % 8 dồn key 0, 8, 16, 24 vào cùng bucket 0. Đổi 8 thành số nguyên tố có chắc hết hot spot, hay còn tuỳ tập key thực tế?
4. Avalanche effect
Avalanche effect: đổi 1 bit input thì khoảng 50% bit output đổi theo. Mục tiêu là hai key "gần nhau" (chỉ khác vài bit) không bị dồn vào cùng bucket.
Hash function của String trong Java dùng công thức đa thức: s[0]*31^(n-1) + s[1]*31^(n-2) + ... + s[n-1]. Hai string ngắn chỉ khác nhau ở ký tự cuối thì phần lớn bit của hashCode giống hệt nhau. Chuyện này thành vấn đề khi Map capacity nhỏ và chỉ dùng các bit thấp để tính bucket index.
Vì vậy Java HashMap (từ Java 8) trộn bit cao xuống bit thấp trước khi tính bucket ("supplemental hash", băm bổ sung):
-- Supplemental hash: XOR nửa trên vào nửa dưới để cải thiện phân phối
-- Đặc biệt hữu ích cho key mà hashCode chỉ khác ở bit cao
h <- hashCode(key)
h <- h XOR (h dịch phải 16 bit)  -- trộn bit 16-31 vào bit 0-15
bucket_idx <- h AND (capacity - 1)
XOR h với h >> 16 (shift phải 16 bit): các bit từ vị trí 16–31 được trộn vào vị trí 0–15. Nhờ vậy, kể cả khi hai key có hashCode chỉ khác ở bit cao, bucket index của chúng vẫn khác nhau.
5. hashCode/equals contract
Contract gồm ba rule:
Rule 1 — Consistency với equals (MUST): nếu a.equals(b) == true thì a.hashCode() == b.hashCode(). Rule này không được vi phạm: Map dùng hashCode để định vị bucket, rồi dùng equals để xác nhận đúng key. Hai object "bằng nhau" theo equals mà hashCode khác thì lookup tìm sai bucket và không bao giờ gặp được nhau.
Rule 2: Collision OK: a.hashCode() == b.hashCode() không có nghĩa là a.equals(b). Collision chấp nhận được, Map xử lý bằng chaining. Rule 1 chỉ đúng một chiều (suy ra được một phía), không phải "khi và chỉ khi".
Rule 3: Stability (SHOULD): hashCode() phải trả về cùng giá trị giữa các lần gọi trong cùng một lần chạy JVM, miễn là object không đổi các field dùng để tính.
Ví dụ class User đúng contract, equals và hashCode cùng dùng userId:
-- User class với contract đúng
User:
    userId: long (final)
    email: String (final)

    equals(other):
        if other không phải User: return false
        return this.userId = other.userId

    hashCode():
        return hash(userId)       -- cùng field với equals → contract thoả
Nguyên tắc chính: hashCode phải nhất quán với equals. Các field dùng trong equals phải là tập con (hoặc bằng) các field dùng trong hashCode.
Thử ngẫmhai object có cùng hashCode mà equals trả false thì cấu trúc phải làm gì tiếp để không trả nhầm kết quả, và bước đó tốn thêm chi phí gì?
6. Các bẫy thường gặp
Bẫy 1: Override equals nhưng quên override hashCode
Khi không override hashCode, Java dùng identity hash: một số gắn với từng object, không tính từ nội dung. Hai object cùng userId vẫn là hai object riêng nên hashCode khác nhau, Map tìm sai bucket, lookup thất bại. Nếu chưa quen ý "hai biến trỏ cùng một ô nhớ" khác "hai ô nhớ chứa cùng giá trị", ôn lại ở Biến và phép gán.
-- BUG: equals override nhưng hashCode dùng identity hash mặc định
UserBroken:
    equals(other): so sánh userId  -- đúng
    -- hashCode(): KHÔNG override → dùng identity hash

u1 <- UserBroken(userId=1)
u2 <- UserBroken(userId=1)
u1.equals(u2)          -- true (cùng userId)
S <- Set rỗng
S.add(u1)
S.contains(u2)         -- false! u2 có hashCode khác u1 → tìm sai bucket
Time: O(1) (mong đợi) Space: O(n)
-- CORRECT: cả equals và hashCode đều dùng userId
User:
    equals(other): so sánh userId
    hashCode(): return hash(userId)  -- cùng field → contract thoả

u1 <- User(userId=1)
u2 <- User(userId=1)
S <- Set rỗng
S.add(u1)
S.contains(u2)         -- true ✓
Time: O(1) Space: O(n)
Bẫy 2: Mutable field trong hashCode
Nếu hashCode dựa trên field có thể đổi sau khi object đã put vào Map, thì hashCode sau khi đổi sẽ khác hashCode lúc put. Key bị "lạc" trong bucket cũ và get ra null.
-- BUG: hashCode phụ thuộc vào field có thể thay đổi
MutableUser:
    userId: long (final)
    email: String     -- có thể thay đổi!
    hashCode(): return hash(userId, email)  -- email là mutable → NGUY HIỂM

u <- MutableUser(userId=1, email="[email protected]")
M <- Map rỗng
M.put(u, "admin")
M.get(u)              -- "admin" (đúng)

u.email <- "[email protected]"   -- thay đổi field dùng trong hashCode!
M.get(u)              -- null! hashCode đã đổi, key "lạc" sang bucket khác
-- Entry vẫn trong map (memory leak) nhưng không thể truy cập qua get()
Cách làm tốt: hashCode chỉ dùng field final (bất biến).
Bẫy 3: Dùng hashCode làm ID lưu database
hashCode() không ổn định giữa các lần restart JVM. Hash function mặc định dựa trên identity nên đổi mỗi lần chạy. String.hashCode() tuy cố định nhưng chỉ là int 32-bit, dễ trùng và không đủ làm ID.
-- WRONG: lưu hashCode làm record ID
recordId <- user.hashCode()   -- int 32-bit, có thể collision, không stable
db.save(recordId, user)       -- sai khi restart JVM hoặc với object khác nhau

-- CORRECT: dùng UUID hoặc cryptographic hash cho persistence
recordId <- UUID.randomUUID()
Hãy dùng UUID làm ID lưu trữ. Nếu cần ID cố định suy ra từ nội dung, dùng cryptographic hash (SHA-256).
7. Bảng hash function phổ biến
| Class | Cách tính | Ghi chú |
|---|---|---|
| Mặc định (Object) | Identity hash (gắn theo object, sinh ở lần gọi đầu) | Đổi giữa các lần chạy JVM, không ổn định |
| String | s[0]*31^(n-1) + ... + s[n-1] | Spec cố định, ổn định. Cache lại sau lần tính đầu. |
| Integer | return value; | Chính value là hash — đơn giản nhất |
| Long | (int)(v XOR (v dịch phải 32 bit)) | Trộn nửa trên vào nửa dưới |
Long.hashCode(v) đáng chú ý: XOR nửa trên vào nửa dưới của số 64-bit để trộn bit trước khi cắt về int. Cùng tư tưởng với supplemental hash của Map, chỉ khác là làm ở tầng key.
Thử ngẫmbảng trên cho thấy hash function của Integer chỉ trả chính value, không trộn bit. Nếu bạn dùng các số liên tiếp 1, 2, 3... làm key trong cấu trúc có capacity nhỏ, việc thiếu avalanche này có gây hot spot không?
8. Ứng dụng thực tế
Xử lý collision trong Map — Java 8+ dùng chaining: mỗi bucket là một linked list; khi chain dài quá 8 node và table đã có từ 64 bucket trở lên thì treeify (đổi thành red-black tree), worst case lookup là O(log n) thay vì O(n); table nhỏ hơn 64 bucket thì HashMap resize thay vì treeify. HashMap internals (khoá Java) đào sâu resize và load factor 0.75. Riêng chuyện chain dài biến thành cây và vì sao kẻ tấn công khai thác được điều đó, xem Treeify và collision DoS.
ConcurrentHashMap — từ Java 8, khoá ở mức từng bucket: bucket trống thì ghi bằng CAS, bucket có dữ liệu thì synchronized trên node đầu của nó. Hai thread ghi vào hai bucket khác nhau không chặn nhau, nên hash function đều cũng quyết định throughput.
Distributed sharding — Hệ thống phân tán dùng hash function mạnh (như MurmurHash3) để tính vị trí cho mỗi partition key. Consistent hashing đặt hash value vào một vị trí trên ring; node "gần" nhất trên ring sẽ giữ partition đó. Hash function phân bố đều hay không ảnh hưởng trực tiếp đến việc tải có cân bằng giữa các node.
Bloom filter — cần k hash function độc lập cho cùng một key. Thực tế người ta dùng tổ hợp tuyến tính của 2 hash: h_i(k) = h1(k) + i * h2(k) để tạo ra k hash function từ hai hash function ban đầu. Bài 09 (Bloom filter) của module này trình bày chi tiết.
9. Đào sâu
- Effective Java, 3rd Edition, Item 11: "Always override hashCode when you override equals" (Joshua Bloch).
- The Art of Computer Programming, Vol. 3, Knuth, mục 6.4 (Hashing): phân tích độ dài chain kỳ vọng và xác suất collision.
- MurmurHash3 (Austin Appleby, 2011) và xxHash (Yann Collet): hash không mật mã, nhanh và trộn bit tốt, hay gặp trong hệ thống phân tán.
- HashMap internals (khoá Java): chaining, treeify, load factor, resize. Bài 03 của module này: open addressing và tombstone.
Bài liên quan trong khoá học:
- Open Addressing: chiến lược giải quyết va chạm thay cho Chaining.
- Bloom Filter: hàm băm trong cấu trúc dữ liệu xác suất.
- Consistent Hashing: băm phân tán định tuyến node.
- Cùng ý tưởng ở track khác — hash index của database cũng băm khoá ra bucket; xem Hash index.
- Cùng ý tưởng ở track khác — hash partition dùng hàm băm rải khoá đều lên node, chống hot spot; xem Key-range vs hash.
10. Tóm tắt
Checklist khi tự viết key cho HashMap hoặc HashSet:
- Override
equalsthì override luônhashCode, và chỉ tính từ các fieldfinal. Quên một trong hai, hoặc đổi field sau khi đã put, thì key "lạc" mất trong Map mà không có lỗi nào báo. - Hash function cho cấu trúc dữ liệu chỉ cần nhanh và đều, không cần chống suy ngược. Khi cần chống suy ngược (mật khẩu, checksum) mới dùng cryptographic hash.
- Key là số liên tiếp hoặc chuỗi giống nhau ở bit thấp thì dễ dồn vào vài bucket; Map thường trộn thêm bit cao xuống bit thấp để bù.
- Đừng lưu
hashCode()làm ID: nó đổi theo từng lần chạy JVM, chỉ có 32 bit và hay trùng. Dùng UUID. - Hash function còn dùng ngoài Map: Bloom filter cần k hash function độc lập, sharding cần hash đều để chia tải.
11. Tự kiểm tra
- Q1Vì sao nhiều Map thêm XOR với h >>> 16 vào hash của key trước khi tính bucket index?
- Q2Override equals mà không override hashCode thì bug xuất hiện ở đâu, và vì sao nó im lặng?
- Q3Field có thể đổi (mutable) nằm trong hashCode thì chuyện gì xảy ra với Map key sau khi field đó đổi?
- Q4Vì sao hash function của String ổn định giữa các lần chạy JVM còn hash function mặc định (Object) thì không? Khác nhau ở cơ chế nào?
- Q5Avalanche effect đo thế nào? Hash function nào tệ nhất về avalanche?
- Q6Distributed cache cần hash function 'consistent' thay vì chỉ 'uniform', hai thứ khác nhau chỗ nào?
Bài tiếp theo: Open addressing, linear/quadratic probing, robin hood
Hash table này chạy thật ở đâu?
HashMapcủa Java chính là một hiện thực của nó. Nếu bạn học Java, Java Internals — HashMap internals cho thấy cách JDK xử lý va chạm: separate chaining, và treeify từ Java 8 khi một bucket quá dài.
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Module 1 — Tìm kiếm nhanh: tổng quan
Bài tiếpOpen addressing — Probing, Robin Hood và vì sao Java chọn chaining
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này