Gộp feed lúc đọc: vì sao một câu JOIN đúng vẫn vỡ p99
Phương án đơn giản nhất: mỗi lần mở feed JOIN bảng theo dõi với bảng bài đăng. Tự chạy với 50, 500, 2.000 theo dõi, đọc EXPLAIN, đo p99 và chỉ ra điểm vỡ.
TL;DR: Cách dựng feed ngây thơ nhất là không lưu gì sẵn: mỗi lần mở feed, JOIN danh sách bạn đang theo dõi với bảng bài đăng, sắp theo thời gian, lấy 50 dòng. Chi phí của nó tỉ lệ với số tài khoản bạn theo dõi chứ không với 50 dòng trả về. Bài này bắt bạn tự chạy EXPLAIN (ANALYZE, BUFFERS) và pgbench với người đọc theo dõi 50, 500, 2.000 tài khoản, rồi tự chỉ ra điểm vỡ so với p99 dưới 200 ms và tải đọc đỉnh. Ở 2.000 theo dõi, p99 là 660 ms so với ngưỡng 200 ms.
Phương án đầu tiên nghĩ ra thường là phương án ngắn nhất: bảng follows đã biết ai theo dõi ai, bảng posts đã có mọi bài đăng, thì mỗi lần mở feed chỉ cần nối hai bảng, sắp bài mới nhất lên đầu, lấy 50 dòng. Không bảng phụ, không worker. Một người dùng thì chạy tức thì. Bạn sẽ tự chạy nó với ba loại người đọc, rồi tự nói nó vỡ ở đâu trước khi đọc lời giải.
1. Ràng buộc và phương án ngây thơ
Bạn chấm phương án theo đúng các dòng đã chốt ở bài 01:
| Ràng buộc | Giá trị |
|---|---|
| Lượt mở feed | trung bình ≈ 1.160/giây, đỉnh ≈ 3.500/giây |
| Số tài khoản một người theo dõi | trung vị 200, trần 5.000 |
| Một trang feed | 50 bài, p99 dưới 200 ms |
| Độ tươi | bài mới tới người theo dõi trong ≤ 5 giây; người đăng thấy ngay |
Hai dòng làm nên bài này là p99 dưới 200 ms cho một trang 50 bài, và người đọc theo dõi tới 5.000 tài khoản chứ không phải 50. Phương án ngây thơ là một câu truy vấn trên hai bảng follows và posts:
SELECT p.id, p.author_id, p.created_at
FROM follows f JOIN posts p ON p.author_id = f.followee_id
WHERE f.follower_id = :r
ORDER BY p.created_at DESC LIMIT 50;
Bằng lời: lấy mọi bài của mọi tài khoản mà :r theo dõi, sắp mới nhất lên đầu, giữ 50 bài. Về độ tươi nó hoàn hảo: bài vừa đăng nằm sẵn trong posts, nên lần mở feed kế tiếp thấy ngay, cả với người đăng. Câu hỏi còn lại là nó chạy nhanh đến đâu.
2. Tự chạy: dựng dữ liệu, đọc EXPLAIN ở ba mức theo dõi
Chạy setup.sql ở bài 01 trên database feedlab (đã chạy rồi thì dùng lại). Nó sinh 100.000 người dùng, 2 triệu bài rải 90 ngày và khoảng 4,45 triệu cạnh theo dõi với phân bố đuôi dài. Bài này thêm ba người đọc giả theo dõi đúng 50, 500, 2.000 tài khoản (id 100001, 100002, 100003):
INSERT INTO users(id) VALUES (100001),(100002),(100003);
INSERT INTO follows SELECT 100001, f FROM (SELECT DISTINCT floor(exp(random()*ln(100000)))::int + 1 f FROM generate_series(1,200)) s LIMIT 50;
INSERT INTO follows SELECT 100002, f FROM (SELECT DISTINCT floor(exp(random()*ln(100000)))::int + 1 f FROM generate_series(1,3000)) s LIMIT 500;
INSERT INTO follows SELECT 100003, f FROM (SELECT DISTINCT floor(exp(random()*ln(100000)))::int + 1 f FROM generate_series(1,20000)) s LIMIT 2000;
VACUUM ANALYZE;
Rồi chạy câu truy vấn của mục 1 cho từng người đọc, đổi :r thành 100001, 100002, 100003. Chạy mỗi câu 4 lần, bỏ lần đầu:
EXPLAIN (ANALYZE, BUFFERS)
SELECT p.id, p.author_id, p.created_at
FROM follows f JOIN posts p ON p.author_id = f.followee_id
WHERE f.follower_id = 100001
ORDER BY p.created_at DESC LIMIT 50;
Người đọc 2 theo dõi gấp 10 lần người đọc 1, người đọc 3 theo dõi gấp 4 lần người đọc 2. Trước khi chạy, viết ra ba con số của riêng bạn: số hàng posts mỗi mức phải đọc, tỉ lệ thời gian mỗi bước, và dòng nào trong plan sẽ tốn nhất. Chạy xong mới so.
Kết quả của tác giả (Apple M4, PostgreSQL 16 trong Docker, mặc định work_mem 4 MB). Dữ liệu ngẫu nhiên nên số hàng của bạn lệch nhẹ, hình dạng phải giống. EXPLAIN ANALYZE cộng chi phí bấm giờ từng node nên chỉ đọc cột thời gian theo tỉ lệ:
| Theo dõi | Hàng bài đọc | Sort | Buffers | Execution (4 lần) | Plan |
|---|---|---|---|---|---|
| 50 | 1.016 | top-N heapsort 30 kB | hit ≈ 1.200 | 0,9 đến 1,4 ms | Index Scan posts lặp 50 vòng |
| 500 | 10.015 | top-N heapsort 30 kB | hit ≈ 11.600 | 5,8 đến 6,4 ms (một lần 40 ms) | như trên, lặp 500 vòng |
| 2.000 | ≈ 39.989 chia cho 3 tiến trình | top-N heapsort 30 kB mỗi tiến trình | hit ≈ 9.900 + read ≈ 28.700 | 55 đến 64 ms | Parallel Seq Scan posts + Hash Join |
3. Vì sao số hàng đọc tăng tuyến tính, và vì sao ở 2.000 planner bỏ index?
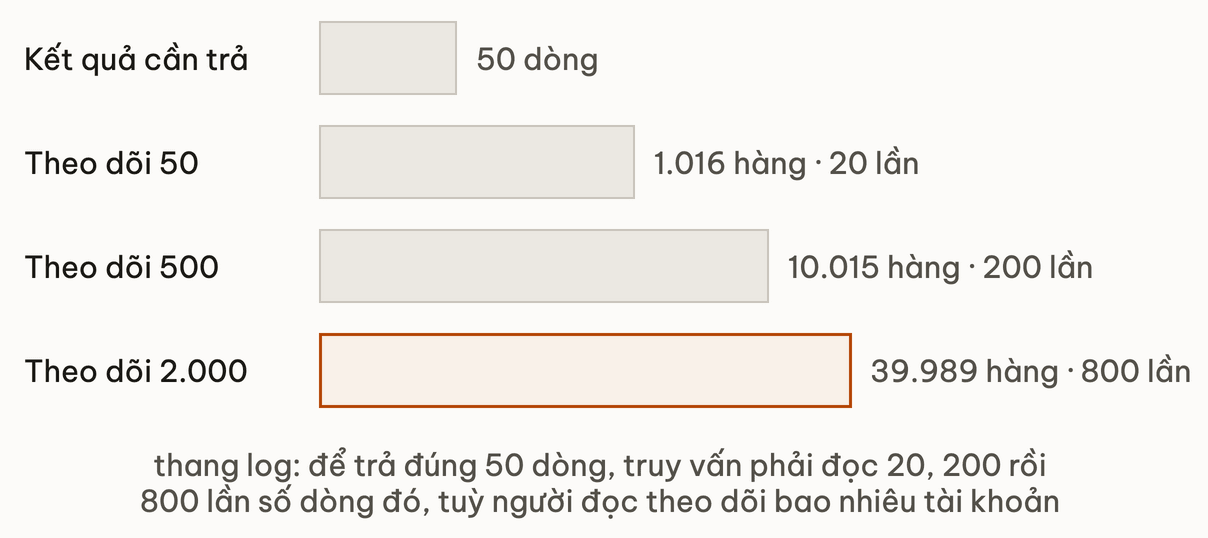
Đọc bảng theo hai cột. Cột hàng: theo dõi tăng 10 lần thì hàng đọc tăng 9,9 lần, rồi tăng 4 lần thì hàng đọc tăng 4 lần nữa. Mỗi tài khoản theo dõi kéo theo khoảng 20 bài (2 triệu bài chia 100.000 tác giả), và cả 20 bài phải được đọc lên, vì chưa đọc thì chưa biết bài nào nằm trong 50 bài mới nhất. Tỉ lệ ứng viên trên kết quả vì thế là 20, 200, 800 lần.
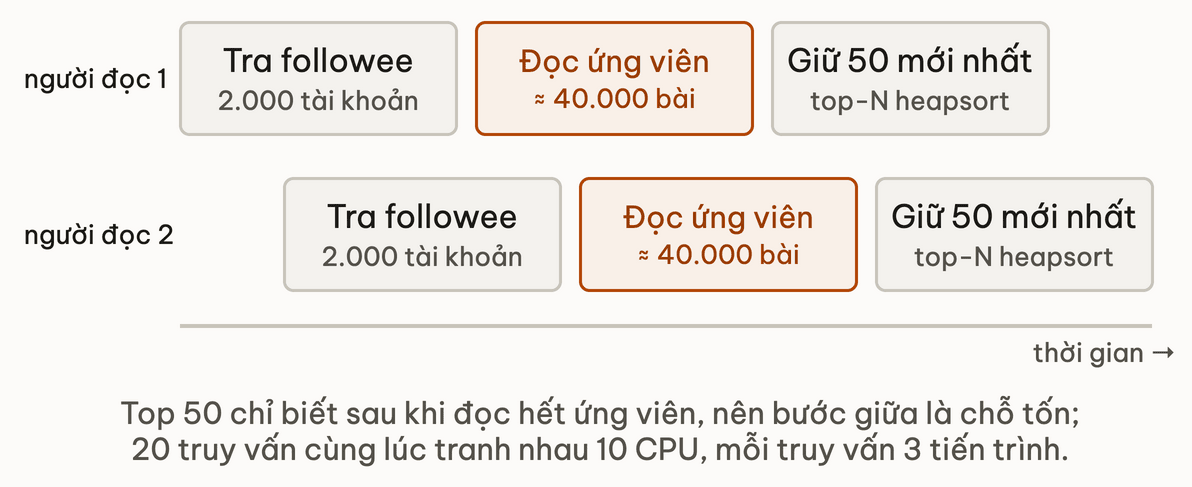
Cột Sort là chỗ nhiều người đoán sai: top-N heapsort chỉ dùng 30 kB, vì LIMIT 50 cho phép giữ đúng 50 phần tử tốt nhất trong lúc quét chứ không sắp cả tập. Sort rẻ. Cái tốn là phải đọc hết ứng viên trước khi biết top 50. Index posts_author_created_idx sắp bài theo thời gian trong từng tác giả, không có cấu trúc nào sắp qua nhiều tác giả, nên không có đường tắt.
Planner chọn giữa index scan và quét toàn bảng theo ước lượng số hàng sẽ đọc. Hệ quả ở đây: 50 lần tra index thì rẻ, 2.000 lần tra rải khắp bảng thì quét thẳng cả bảng rẻ hơn.
Dòng cuối bảng là điều đáng nhớ. Ở 2.000 theo dõi, planner ước lượng gần 40.000 hàng cần đọc từ 2.000 chỗ khác nhau của một bảng 2 triệu hàng, và quyết định bỏ index, quét song song cả bảng posts (read ≈ 28.700 page, gần bằng toàn bộ bảng) rồi Hash Join. Ép planner quay lại nested loop (SET enable_seqscan = off kèm SET max_parallel_workers_per_gather = 0) cho cùng 39.989 hàng thì mất khoảng 53 ms. Đo bằng pgbench ở mục 4, plan ép này cho p50 khoảng 48 ms khi một kết nối và p99 khoảng 116 ms ở 20 kết nối, nên p99 qua được ngưỡng 200 ms, nhưng thông lượng chỉ khoảng 209 truy vấn mỗi giây (so với 15.570 ở 50 theo dõi). Hai plan cùng một kết luận: chi phí đi theo số ứng viên, và số ứng viên đi theo số tài khoản theo dõi.
4. Tự chạy: p99 khi một người đọc và khi 20 người cùng đọc
Một lần EXPLAIN chỉ đo một người đọc chạy một mình. Ràng buộc nói về p99 trong lúc nhiều người đọc cùng lúc, nên giờ đo thật bằng pgbench. Lưu câu truy vấn thành naive.sql (biến :r được truyền bằng -D):
SELECT p.id, p.author_id, p.created_at
FROM follows f JOIN posts p ON p.author_id = f.followee_id
WHERE f.follower_id = :r
ORDER BY p.created_at DESC LIMIT 50;
pgbench -P không cho percentile, nên p99 phải tính từ log từng giao dịch (-l, cột thứ ba là thời gian micro giây). Lưu thành p99.sh, chạy ./p99.sh 100001 1, ./p99.sh 100001 20, rồi tương tự cho 100002 và 100003:
# usage: ./p99.sh <reader_id> <clients>
r=$1; c=$2; j=$(( c>4 ? 4 : c ))
pgbench -n -f naive.sql -D r=$r -c $c -j $j -T 3 feedlab > /dev/null   # warm-up, bo
rm -f pgbench_log*
pgbench -n -f naive.sql -D r=$r -c $c -j $j -T 8 -l feedlab | grep tps
cat pgbench_log* | awk '{print $3}' | sort -n > lat.txt
n=$(wc -l < lat.txt)
echo "p50_ms=$(sed -n "$((n*50/100+1))p" lat.txt | awk '{printf "%.2f",$1/1000}') p99_ms=$(sed -n "$((n*99/100+1))p" lat.txt | awk '{printf "%.2f",$1/1000}')"
Kết quả của tác giả (trung vị của 3 lần chạy, dải giữa các lần hẹp):
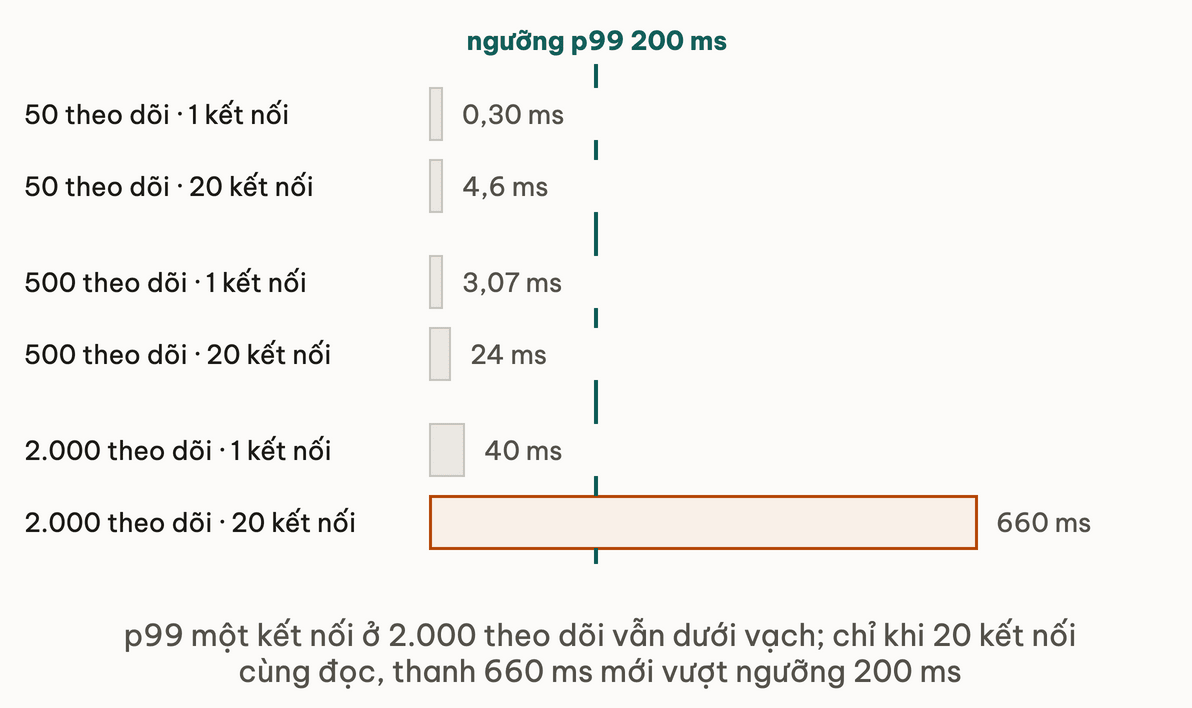
| Theo dõi | p99, 1 kết nối | p99, 20 kết nối | p50, 20 kết nối | Truy vấn/giây, 20 kết nối |
|---|---|---|---|---|
| 50 | 0,30 ms | 4,6 ms | 0,95 ms | 15.570 |
| 500 | 3,07 ms | 24 ms | 11,1 ms | 1.753 |
| 2.000 | 40 ms | 660 ms | 457 ms | 48 |
Một cái bẫy đo: ở 2.000 theo dõi p99 một kết nối là 40 ms, dưới 200 ms, nên chỉ chạy -c 1 hoặc một lần EXPLAIN sẽ cho kết luận "đạt". Hai kiểu tăng chồng lên nhau. Theo chiều ngang: từ 1 lên 20 kết nối, p99 tăng khoảng 15 lần, 8 lần, 16 lần. Theo chiều dọc: từ 50 lên 2.000 theo dõi, p99 ở 20 kết nối tăng từ 4,6 lên 660 ms (khoảng 140 lần) và thông lượng tụt từ 15.570 xuống 48 truy vấn mỗi giây (khoảng 320 lần). Ở mức 2.000 mỗi truy vấn dùng 3 tiến trình đọc cả bảng, nên 20 truy vấn tranh nhau 10 CPU. Nút thắt là CPU và đọc trang, không phải khoá.
p99 ở 20 kết nối là trải nghiệm của người xui nhất khi hệ đang chịu tải, đúng điều ràng buộc yêu cầu giữ dưới 200 ms.
5. Điểm vỡ nằm ở đâu, và bài này chưa kết luận gì?
Trước khi đọc tiếp, viết ra điểm vỡ theo cách của bạn: với mỗi dòng ràng buộc, phương án đạt hay trượt, ở mức theo dõi nào, vì sao. Đáp án để so (máy lab không phải cụm production nên chỉ đọc theo thứ tự và tỉ lệ):
- p99 dưới 200 ms. Plan mặc định trượt rõ ở 2.000 theo dõi khi có 20 kết nối (660 ms). Ở 500 theo dõi vẫn đạt (24 ms), nên điểm vỡ nằm giữa 500 và 2.000, trong khi trung vị người dùng theo dõi 200 và trần là 5.000.
- Tải đọc đỉnh. Thông lượng giảm từ 15.570 xuống 1.753 rồi 48 truy vấn mỗi giây khi người đọc theo dõi nhiều hơn. Nhu cầu đỉnh (≈ 3.500 lượt mở feed mỗi giây) không co lại theo người đọc, nên khoảng cách giữa cái làm được và cái cần giãn ra theo đúng tỉ lệ đó.
- Độ tươi. Đạt tuyệt đối, vì không có gì dựng sẵn để bị cũ. Đây là điểm mạnh duy nhất của phương án này, và là thứ bạn sẽ phải đem ra đổi ở các bài sau.
Cơ chế chung của mọi điểm vỡ trên: mỗi lần mở feed trả toàn bộ chi phí gộp, và chi phí đó tỉ lệ với số tài khoản đang theo dõi (N), thứ bạn không điều khiển được và trần tới 5.000. Đây là trục chi phí của người đọc, độc lập với trục của tác giả (số người theo dõi họ) mà các bài sau sẽ chạm tới.
Bài này mới chứng minh được một điều: câu JOIN đọc hết bài của mọi tài khoản theo dõi rồi mới chọn 50 thì vỡ. Gộp lúc đọc nói chung thì chưa kết luận gì. Có những cách gộp khéo hơn, chẳng hạn mỗi tác giả chỉ đóng góp một số ít bài mới nhất, và có thể kéo chi phí xuống. Kéo đủ xuống chưa, hay vẫn phải dời cái giá sang lúc ghi, bài 03 sẽ đo. Giữ ngưỡng bạn vừa tìm làm thước: phương án nào cũng phải qua được 2.000 theo dõi ở 20 kết nối với p99 dưới 200 ms và đủ thông lượng cho tải đỉnh.
Đào sâu
- PostgreSQL 16, Using EXPLAIN: cách đọc
actual time,rows,Buffersvà vì sao planner chọn Seq Scan hay Index Scan theo ước lượng chi phí. - PostgreSQL 16, pgbench:
-Dđặt biến,-fchạy script riêng,-lghi log từng giao dịch dùng để tính p99 (-Pkhông cho percentile).
Liên hệ các bài khác
- Bài 01: nguồn của
setup.sqlvà phân bố người theo dõi dùng ở đây. - Bài 03: thử gộp lúc đọc làm khéo hơn và so với dựng sẵn timeline.
- Bài 04: trục tác giả, độc lập với trục người đọc ở bài này.
6. Tự kiểm tra
- Q1Chỉ ra điểm vỡ của phương án JOIN lúc đọc so với ràng buộc, kèm con số bạn đã đo.
- Q2Vì sao số hàng đọc tăng tuyến tính theo số tài khoản theo dõi, dù chỉ cần trả 50 dòng?
- Q3Ở 2.000 theo dõi, planner bỏ index và quét song song cả bảng posts. Nếu bạn ép nó quay lại nested loop bằng index thì có qua được ràng buộc không?
- Q4Một đồng nghiệp đo p99 một kết nối ở 2.000 theo dõi được 40 ms và nói phương án đạt. Bạn trả lời thế nào?
- Q5Từ số đo này, có kết luận được rằng mọi cách gộp feed lúc đọc đều hỏng không? Bạn muốn kiểm chứng gì tiếp theo?
Bài tiếp theo: 03: Trả giá lúc ghi hay lúc đọc.
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Ràng buộc và ước lượng: một bài đăng nở thành bao nhiêu lần ghi?
Bài tiếpTrả giá lúc ghi hay lúc đọc: dựng sẵn timeline hay gộp khi mở
Thảo luận & góp ý
Hỏi đáp về bài này