Ràng buộc và ước lượng: một bài đăng nở thành bao nhiêu lần ghi?
Công bố bảng ràng buộc news feed, tự tính tải đọc, tải ghi và số hàng timeline mỗi giây, rồi đo trên Postgres phân bố người theo dõi của một dataset đuôi dài.
TL;DR: Trước khi vẽ bất kỳ kiến trúc nào, hãy chốt ràng buộc bằng số rồi tự tính ra các con số suy ra: tải đọc, tải ghi, và số hàng timeline mà mỗi bài đăng kéo theo nếu dựng sẵn timeline cho người theo dõi. Hai tham số quyết định cả case là tỉ lệ đọc/ghi và phân bố người theo dõi. Bạn sẽ tự tính cái thứ nhất bằng giấy và tự đo cái thứ hai trên Postgres của mình.
Một đồng nghiệp hỏi: "Làm news feed cho 10 triệu người dùng thì tốn bao nhiêu máy?" Chưa ai trả lời được, vì chưa biết họ mở feed bao nhiêu lần, đăng bao nhiêu bài, và mỗi bài tới bao nhiêu người. Mỗi con số đó đổi đáp án nhiều lần.
Bài này công bố bảng ràng buộc của cả case, dạy bạn tự tính các số suy ra, rồi cho một lab nhỏ để đo thứ phép tính giấy không cho biết: người theo dõi phân bố ra sao. Chưa có thiết kế nào ở đây, chỉ có số và câu hỏi.
1. Bảng ràng buộc: những con số cả case đứng trên
Bảng dưới là ràng buộc tự đặt, không phải số của công ty thật nào. Đề thiếu số thì mỗi người hiểu một kiểu, rồi tranh cãi kiến trúc khi thật ra đang tranh cãi đề. Các bài 02 đến 06 trích lại đúng bộ số này.
| Ràng buộc | Giá trị |
|---|---|
| Người dùng hoạt động mỗi ngày | 10 triệu |
| Lượt mở feed | 10 lần mỗi người mỗi ngày |
| Bài đăng mới | 2 triệu mỗi ngày |
| Hệ số đỉnh so với trung bình | ×3 |
| Người theo dõi một tài khoản | trung vị 150, trung bình 400 (đuôi dài), lớn nhất 5 triệu |
| Số tài khoản một người đang theo dõi | trung vị 200, trần 5.000 |
| Một trang feed | 50 bài, p99 dưới 200 ms |
| Độ tươi | bài mới tới feed người theo dõi trong 5 giây (mục tiêu, không phải cam kết cứng); người đăng thấy bài mình ngay |
| Timeline dựng sẵn (nếu có) | giữ 500 bài gần nhất mỗi người |
Chỗ cần nhìn kỹ: trung vị 150 mà trung bình 400. Trung bình gấp gần 3 lần trung vị nghĩa là có đuôi dài kéo nó lên, và đuôi đó chạm tới 5 triệu.
Ràng buộc "p99 dưới 200 ms" dùng đúng ý bài đó: trải nghiệm thật nằm ở đuôi, không ở trung bình.
Feed ở đây theo thời gian: 50 bài mới nhất, không xếp hạng bằng machine learning.
2. Tải đọc và tải ghi: bao nhiêu lượt mỗi giây?
Phép tính bằng giấy, kiểu back-of-envelope: đủ để biết bậc độ lớn, không cần chính xác đến chữ số cuối. Một ngày có khoảng 86.400 giây. Hãy tự tính trước khi xem đáp án.
Từ bảng ràng buộc, tính lượt mở feed mỗi giây (trung bình, rồi đỉnh) và bài đăng mới mỗi giây (trung bình, rồi đỉnh). Rồi chia ra tỉ lệ đọc/ghi theo số request. Ghi mỗi con số ra giấy trước khi sang phần sau.
Lời giải:
- Lượt mở feed: 10 triệu người × 10 lần = 100 triệu lượt mỗi ngày. Chia 86.400 giây ra khoảng 1.160 lượt mỗi giây trung bình, nhân hệ số đỉnh 3 ra khoảng 3.500 lượt mỗi giây.
- Bài đăng mới: 2 triệu mỗi ngày chia 86.400 ra khoảng 23 bài mỗi giây trung bình, đỉnh khoảng 70 bài mỗi giây.
- Tỉ lệ đọc/ghi: 1.160 chia 23 xấp xỉ 50 : 1. Cùng hệ số đỉnh nên tỉ lệ ở đỉnh vẫn thế.
50 : 1 nghe như một hệ đọc nhiều điển hình. Nhớ con số này, vì bước kế tiếp sẽ làm nó đảo chiều.
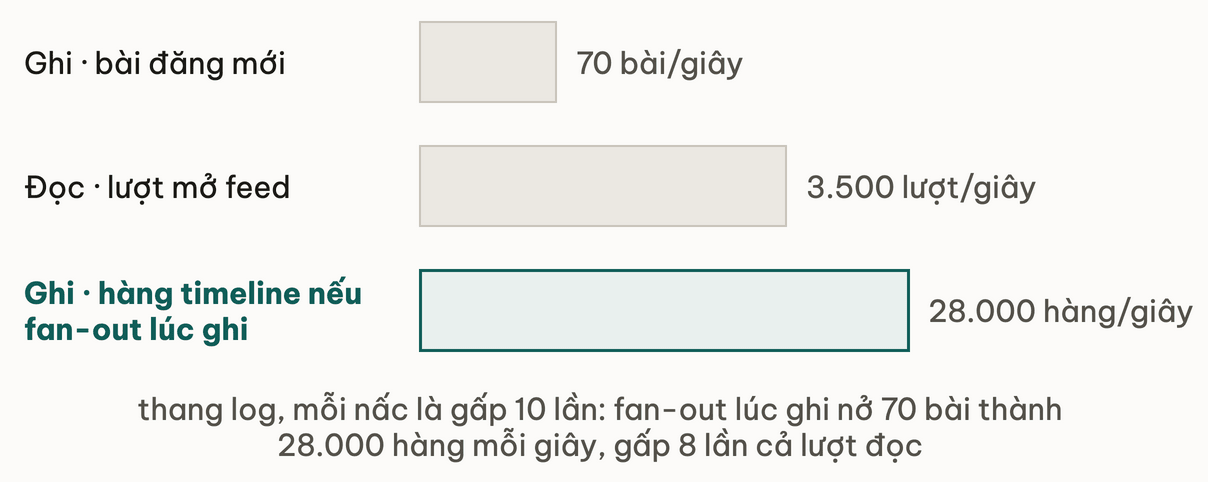
3. Một bài đăng nở thành bao nhiêu lần ghi?
Nếu hệ thống chuẩn bị sẵn một "timeline" cho từng người (danh sách bài đã xếp sẵn, đọc ra là xong) thì mỗi bài đăng kéo theo một lần ghi vào timeline của từng người theo dõi. Chưa bàn nên làm vậy hay không, chỉ tính cái giá nếu làm.
Nếu mỗi bài đăng ghi vào timeline của toàn bộ người theo dõi, hệ thống ghi bao nhiêu hàng timeline mỗi giây, ở mức trung bình và ở đỉnh? Chọn trung vị hay trung bình của dòng "người theo dõi một tài khoản", nói vì sao, rồi mới tính.
Lời giải: dùng trung bình 400, không dùng trung vị 150. Tổng số hàng ghi bằng tổng số cạnh theo dõi, mà trung bình chính là tổng chia số tài khoản nên cộng đúng. Trung vị chỉ cho biết tài khoản ở giữa, bỏ sót cái đuôi nơi nhiều cạnh nhất nằm.
- Trung bình: 23 bài × 400 ≈ 9.200 hàng mỗi giây.
- Đỉnh: 70 bài × 400 ≈ 28.000 hàng mỗi giây.
So với tải đọc ở mục 2: 9.200 hàng ghi mỗi giây trên 1.160 lượt mở feed mỗi giây là khoảng 8 lần. Tỉ lệ 50 : 1 đọc nhiều đã đảo thành ghi nhiều gấp chừng 8 lần, vì mỗi bài đăng mang theo cả đoàn người theo dõi.
Fan-out là một load parameter: 70 bài mỗi giây nghe nhẹ, 28.000 hàng mỗi giây thì không.
Bây giờ tới cái đuôi dài. Trung bình 400 che mất người ở đầu bên kia.
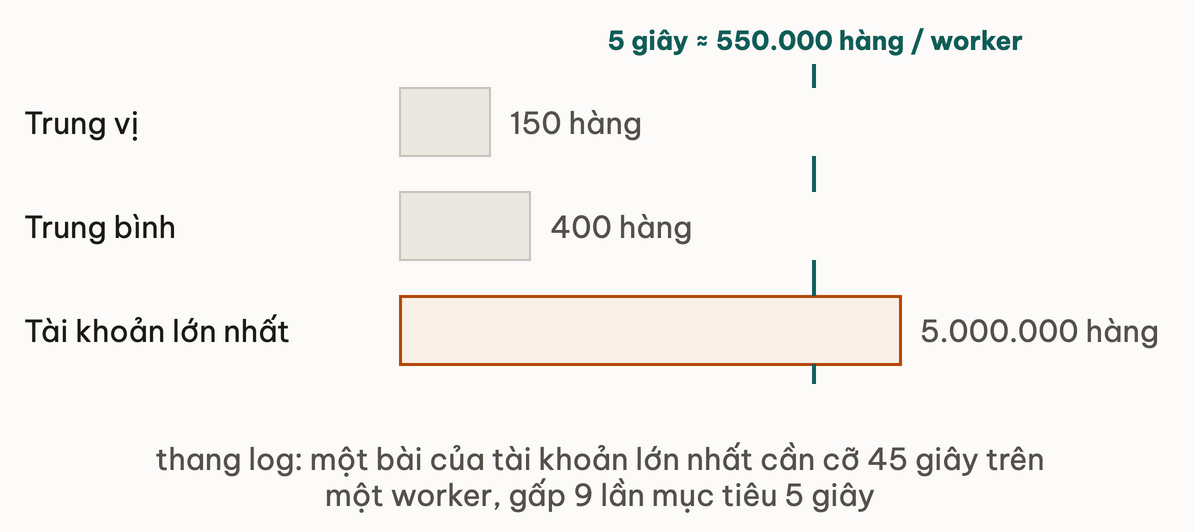
Một tài khoản có 5 triệu người theo dõi (lớn nhất trong bảng) đăng một bài. Trong lab của tác giả, ghi hàng loạt vào timeline đạt cỡ 110.000 hàng mỗi giây trên một worker (đo ở bài 03, mượn trước). Bài đó cần bao nhiêu hàng và bao lâu để ghi hết? So với mục tiêu "tới người theo dõi trong 5 giây" thì sao?
Lời giải: 5 triệu hàng, chia 110.000 hàng mỗi giây ra khoảng 45 giây trên một worker, gấp 9 lần mục tiêu 5 giây. Một bài đăng đủ làm hỏng cam kết độ tươi nếu ghi tuần tự bằng một worker. Số đo ở máy tác giả (Apple M4, Postgres 16 trong Docker); điều đáng nhớ là thương số hàng chục giây chứ không phải vài giây.
Còn một con số nữa, và nó quyết định bạn có đủ chỗ chứa hay không.
Timeline dựng sẵn giữ 500 bài gần nhất cho mỗi người trong 10 triệu người. Mỗi hàng timeline (kể cả index) tốn cỡ 115 byte theo số đo của tác giả. Ước dung lượng cỡ bao nhiêu? Ghi con số trước khi sang phần sau.
Lời giải: 10 triệu × 500 = 5 tỷ hàng, nhân 115 byte ra khoảng 575 GB: vượt xa một máy dùng chung, chưa ngoài tầm vài node có phân mảnh. Con số 115 byte có là vì mỗi hàng còn kéo theo hai index; bài 03 cho số đo.
4. Lab: đo phân bố người theo dõi
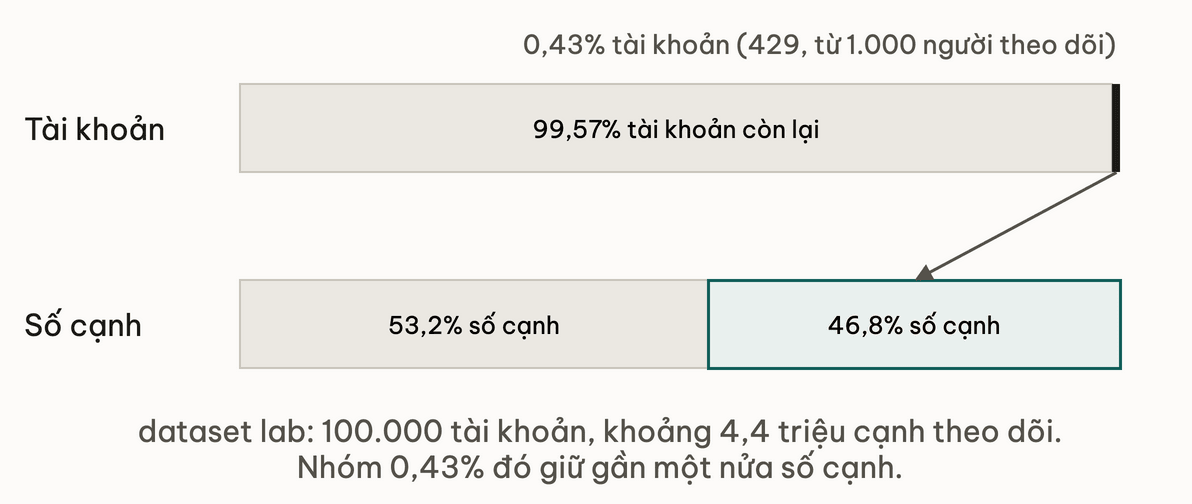
Lab dựng một dataset thu nhỏ (100.000 người dùng, 2 triệu bài, khoảng 4,4 triệu cạnh theo dõi) để bạn thấy đuôi dài bằng mắt mình. Trung vị người theo dõi ở đây chỉ 9, lớn nhất cỡ 95.000, nhỏ hơn bảng ràng buộc nhiều, nên hãy so tỉ lệ, không so số tuyệt đối.
Bước 1: dựng dataset
Cần một Postgres chạy được. Tạo database riêng rồi chạy script. Đây là setup.sql duy nhất của cả module: các bài sau chỉ chạy lại file này rồi thêm phần bổ sung riêng, không dán lại. Trên máy tác giả mất khoảng 32 giây.
createdb feedlab
psql feedlab -q -f setup.sql
-- file: setup.sql
SELECT setseed(0.42);
DROP TABLE IF EXISTS follows, posts, users CASCADE;
CREATE TABLE users (id int PRIMARY KEY, follower_count int NOT NULL DEFAULT 0);
CREATE TABLE posts (
  id bigserial PRIMARY KEY, author_id int NOT NULL,
  created_at timestamptz NOT NULL, body text NOT NULL DEFAULT '', deleted_at timestamptz);
CREATE TABLE follows (
  follower_id int NOT NULL, followee_id int NOT NULL,
  PRIMARY KEY (follower_id, followee_id));

INSERT INTO users(id) SELECT g FROM generate_series(1,100000) g;

-- 5M follow attempts; the FOLLOWED account is drawn from a long-tail distribution
INSERT INTO follows(follower_id, followee_id)
SELECT 1 + floor(random()*100000)::int,
       floor(exp(random()*ln(100000)))::int + 1
FROM generate_series(1,5000000)
ON CONFLICT DO NOTHING;
DELETE FROM follows WHERE follower_id = followee_id;

-- 2M posts spread over 90 days, authors uniform
INSERT INTO posts(author_id, created_at, body)
SELECT 1 + floor(random()*100000)::int,
       now() - random() * interval '90 days',
       repeat('x', 100)
FROM generate_series(1,2000000);

CREATE INDEX follows_followee_idx ON follows(followee_id);
CREATE INDEX posts_author_created_idx ON posts(author_id, created_at DESC);
UPDATE users u SET follower_count = c.n
FROM (SELECT followee_id, count(*) n FROM follows GROUP BY 1) c WHERE c.followee_id = u.id;

VACUUM ANALYZE;
Đuôi dài đến từ exp(random()*ln(100000)): id nhỏ được chọn nhiều hơn hẳn id lớn. ON CONFLICT DO NOTHING làm 5 triệu lượt thử còn khoảng 4,45 triệu cạnh vì các cặp trùng tập trung ở đầu đuôi.
Bước 2: đo phân bố người theo dõi
Trước khi chạy, đoán xem: những tài khoản có từ 1.000 người theo dõi trở lên chiếm bao nhiêu phần trăm tài khoản, và nắm bao nhiêu phần trăm tổng số cạnh theo dõi?
SELECT percentile_cont(0.5)  WITHIN GROUP (ORDER BY follower_count) AS median_followers,
       percentile_cont(0.99) WITHIN GROUP (ORDER BY follower_count) AS p99_followers,
       max(follower_count) AS max_followers
FROM users WHERE id <= 100000;

SELECT count(*) FILTER (WHERE follower_count >= 1000) AS accounts_ge_1k,
       round(100.0 * count(*) FILTER (WHERE follower_count >= 1000) / count(*), 2) AS pct_accounts,
       round(100.0 * sum(follower_count) FILTER (WHERE follower_count >= 1000) / sum(follower_count), 1) AS pct_edges
FROM users WHERE id <= 100000;
Số của tác giả (số bạn lệch nhẹ, tỉ lệ thì giữ):
| Chỉ số | Tác giả | Máy bạn |
|---|---|---|
| Người theo dõi mỗi tài khoản: trung vị / p99 / lớn nhất | 9 / 432 / 95.131 | ? |
| Tài khoản có từ 1.000 người theo dõi trở lên | 429 (0,43%) | ? |
| Phần số cạnh trỏ vào nhóm đó | 46,8% | ? |
Đọc kết quả bằng tỉ lệ: p99 gấp 48 lần trung vị, lớn nhất gấp cỡ 10.000 lần trung vị, và 0,43% tài khoản nắm gần một nửa số cạnh. Với thiết kế, hình dạng mới đáng nhớ chứ con số 9 hay 432 thì không: số đông tài khoản rất nhỏ, vài tài khoản cực lớn, và gần nửa lượng công việc nằm ở vài tài khoản đó. Một con số "trung bình" duy nhất bỏ sót tất cả chuyện này.
Hai tham số tải của cả case
Trục một là tỉ lệ đọc/ghi: 50 : 1 theo request, đảo thành ghi nhiều hơn khi fan-out lúc ghi. Trục hai là phân bố người theo dõi: chi phí fan-out tăng theo số người theo dõi tác giả, và đuôi dài làm trục này lệch nặng. Mỗi cách thiết kế hứng một trục. Bài 02 sẽ tự chạy phương án đơn giản nhất để thấy chi phí dựng feed theo số tài khoản người đọc theo dõi; các bài sau là chọn trả giá ở đâu.
Đào sâu: nguồn để tự kiểm số của mình
- Aggregate functions (PostgreSQL 16):
percentile_contvà các hàm ordered-set dùng để đo trung vị, p99 của phân bố.
Liên hệ các bài khác
- Bài 02: Gộp feed lúc đọc: chạy
setup.sqlở đây rồi đo chi phí dựng feed bằng JOIN, chỉ ra chỗ nó vỡ p99. - Bài 04: Tài khoản triệu người theo dõi: quay lại con số 5 triệu hàng và 45 giây của mục 3, cùng phân bố đuôi dài ở mục 4.
Tóm tắt
- Việc cần làm sau bài này: tự tính lại bốn con số (tải đọc, tải ghi, hàng timeline mỗi giây, dung lượng) từ bảng ràng buộc, và chạy lab để điền cột "máy bạn".
- Câu hỏi mở chuyển sang bài sau: nếu mỗi lượt mở feed phải gom bài của vài trăm tài khoản đang theo dõi, ở 3.500 lượt mỗi giây thì chuyện gì xảy ra?
5. Tự kiểm tra
Các câu 1, 2, 3 và 5 dùng bảng ràng buộc mới: 50 triệu người dùng mỗi ngày, 3 lượt mở feed mỗi người, 5 triệu bài mỗi ngày, hệ số đỉnh ×3, trung vị 40 và trung bình 200 người theo dõi.
- Q1Với bảng ràng buộc mới, tính lượt mở feed mỗi giây và bài đăng mới mỗi giây ở đỉnh, rồi tỉ lệ đọc/ghi theo request. Trình bày phép tính.
- Q2Nếu fan-out lúc ghi, số hàng timeline mỗi giây ở đỉnh là bao nhiêu? Vì sao dùng trung bình 200 chứ không dùng trung vị 40?
- Q3Một tài khoản 2 triệu người theo dõi đăng một bài, một worker ghi 110.000 hàng mỗi giây. Mất bao lâu, và nó nói gì về cam kết 5 giây? Máy nhanh gấp đôi thì kết luận có đổi không?
- Q4Trên dataset lab, 0,43% tài khoản nắm khoảng 47% số cạnh theo dõi. Vì sao một con số trung bình duy nhất không đủ để thiết kế, và hai tham số tải nào cần ghi lại?
- Q5Sản phẩm đổi: mỗi người chỉ mở feed 1 lần mỗi ngày, các số khác giữ nguyên. Tính tỉ lệ đọc/ghi theo request, rồi theo hàng timeline nếu fan-out lúc ghi. Con số nào đảo chiều?
Bài tiếp theo: Gộp feed lúc đọc: vì sao một câu JOIN đúng vẫn vỡ p99
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
News feed — tổng quan case trả giá lúc ghi hay lúc đọc
Bài tiếpGộp feed lúc đọc: vì sao một câu JOIN đúng vẫn vỡ p99
Thảo luận & góp ý
Hỏi đáp về bài này