Trả giá lúc ghi hay lúc đọc: dựng sẵn timeline hay gộp khi mở
Gộp lúc đọc với index tốt, hay ghi sẵn bài vào timeline từng người theo dõi: một bên trả bằng CPU lúc đọc, một bên trả bằng số lần ghi và dung lượng. Chọn rồi đo.
TL;DR: Gộp feed lúc đọc làm khéo (LATERAL lấy top-k bài mỗi tác giả, có index) vẫn tốn thời gian tăng theo số tài khoản người đọc theo dõi, và lần mở feed nào cũng phải trả khoản đó. Dựng sẵn timeline lúc ghi đổi khoản ấy thành chi phí ghi: đọc chỉ 0,097 đến 0,149 ms dù theo dõi 50 hay 2.000 tài khoản, nhưng mỗi hàng timeline tốn khoảng 115 byte và một bài của tài khoản lớn nhả ra hàng nghìn tới hàng triệu hàng. Cả hai đều qua p99 dưới 200 ms ở 20 kết nối. Thứ phân biệt chúng là số lõi CPU ở tải đỉnh 3.500 lượt mở feed mỗi giây (tăng theo N) so với 575 GB và ghi khuếch đại (tăng theo số người theo dõi).
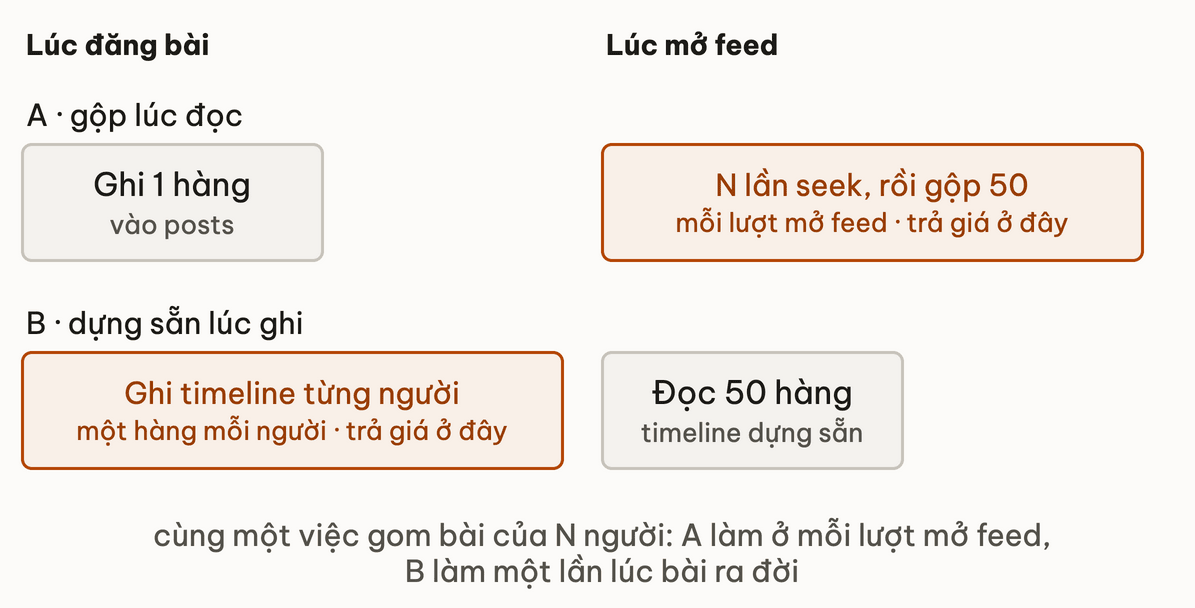
Việc "gom bài của N người thành 50 bài mới nhất" có hai chỗ để làm: lúc người đọc mở feed (fan-out lúc đọc, pull) hoặc lúc tác giả đăng bài (fan-out lúc ghi, push). Hình dung một sạp báo: bạn ra sạp tự gom báo của từng toà soạn mình theo dõi, hoặc toà soạn giao báo tận nhà từng người đặt mua.
| Sạp báo | News feed |
|---|---|
| Bạn ra sạp tự gom báo | Truy vấn gộp bài của N tài khoản lúc mở feed (A) |
| Giao báo tận nhà từng người đặt | Ghi một hàng timeline cho từng người theo dõi lúc đăng (B) |
| Hòm thư mỗi nhà | Bảng timeline, giữ 500 bài gần nhất mỗi người |
| Toà soạn có triệu người đặt mua | Tài khoản triệu người theo dõi: một bài thành triệu lần giao |
Bài 02 cho thấy bản thô của cách thứ nhất vỡ; làm khéo nó thì có đủ không? Bạn chọn trước rồi đo.
1. Trả giá lúc đọc hay lúc ghi, ràng buộc này gánh được cái giá nào?
Ràng buộc là bảng chuẩn ở bài 01: 10 triệu người dùng mỗi ngày, đỉnh khoảng 3.500 lượt mở feed/giây và 70 bài/giây, trang 50 bài với p99 dưới 200 ms, bài mới tới feed trong 5 giây. A là gộp lúc đọc đã làm khéo; B là timeline dựng sẵn lúc ghi.
Ràng buộc: 10 triệu người dùng/ngày · đỉnh 3.500 lượt mở feed/giây và 70 bài/giây · đọc/ghi 50 : 1 · trang 50 bài, p99 dưới 200 ms · bài mới tới feed trong 5 giây
Với 3.500 lượt mở/giây và 70 bài/giây, bạn muốn trả giá bằng CPU lúc đọc hay bằng số lần ghi và dung lượng?
Chọn trước khi đọc tiếp — phần sau phân tích từng cái giá.
Chọn một phương án và ghi lý do trước khi đọc tiếp. Hai phương án cùng một trục, chỗ trả giá: A để việc đến lúc có người hỏi, B làm sẵn từ lúc bài ra đời.
p99 chỉ nói 99% lượt nhanh hơn một ngưỡng, không nói hệ thống tốn bao nhiêu tài nguyên để giữ ngưỡng đó. Hai phương án dưới có thể cùng đạt p99 mà cái giá khác hẳn.
2. Gộp lúc đọc "làm khéo" là làm gì?
Bản thô ở bài 02 đọc mọi bài của mọi tài khoản đang theo dõi. Bản khéo chặn lại: mỗi tài khoản chỉ đóng góp tối đa k bài mới nhất, lấy bằng một lần seek trên index (author_id, created_at DESC).
LATERAL cho subquery trong FROM nhìn thấy cột của hàng đứng trước, nên chạy một lần cho mỗi hàng: đúng khuôn "top-N mỗi nhóm".
SELECT p.id, p.author_id, p.created_at
FROM follows f
CROSS JOIN LATERAL (
  SELECT id, author_id, created_at FROM posts
  WHERE author_id = f.followee_id
  ORDER BY created_at DESC LIMIT 50
) p
WHERE f.follower_id = :r
ORDER BY p.created_at DESC LIMIT 50;
Truy vấn làm N lần seek (N là số tài khoản người đọc theo dõi; trung vị 200, trần 5.000) rồi gộp xuống 50. Số lần seek bằng N và lặp lại ở mỗi lần mở feed.
3. Tự đo cả hai trên máy bạn
Số trong bài đo trên mô hình thu nhỏ (Apple M4, Postgres 16 trong Docker, cấu hình mặc định): so tỉ lệ, đừng so số tuyệt đối. Chạy setup.sql ở bài 01 và thêm ba người đọc giả ở bài 02 trên database feedlab (dùng lại nếu đã có). Dữ liệu: 100.000 người dùng, 2 triệu bài rải 90 ngày (khoảng 20 bài mỗi tác giả), khoảng 4,45 triệu cạnh theo dõi.
Phương án B cần thêm bảng timeline dựng sẵn. Dựng cho 10.000 người đọc đầu và ba người đọc giả (khoảng 9 triệu hàng), rồi đọc từ đó:
CREATE TABLE timeline (user_id int NOT NULL, post_id bigint NOT NULL, created_at timestamptz NOT NULL);
INSERT INTO timeline(user_id, post_id, created_at)
SELECT f.follower_id, p.id, p.created_at
FROM follows f JOIN posts p ON p.author_id = f.followee_id
WHERE f.follower_id <= 10000 OR f.follower_id > 100000;
ALTER TABLE timeline ADD PRIMARY KEY (user_id, post_id);
CREATE INDEX timeline_user_created_idx ON timeline(user_id, created_at DESC);
VACUUM ANALYZE timeline;

-- tl_read.sql
SELECT p.id, p.author_id, p.created_at
FROM timeline t JOIN posts p ON p.id = t.post_id
WHERE t.user_id = :r
ORDER BY t.created_at DESC LIMIT 50;
Lưu truy vấn ngây thơ ở bài 02 thành naive.sql và truy vấn LATERAL ở mục 2 thành lateral.sql, rồi chạy từng file với r là 100001, 100002, 100003. -P của pgbench không cho percentile, nên p99 tính từ log -l:
pgbench -n -f lateral.sql -D r=100002 -c 1 -T 8 -l feedlab
cat pgbench_log* | awk '{print $3}' | sort -n | awk '{a[NR]=$1} END {print "p50_ms", a[int(NR*0.5)+1]/1000, "p99_ms", a[int(NR*0.99)+1]/1000}'
Bỏ 3 giây khởi động, chạy ít nhất 3 lần mỗi ô, thêm một lượt -c 20 -j 4 cho p99 dưới tải. Cuối cùng đo chi phí ghi của B cho ba tác giả có khoảng 100, 10.000 và nhiều người theo dõi nhất (đăng, fan-out, ROLLBACK):
BEGIN;
INSERT INTO posts(author_id, created_at) VALUES (:a, now()) RETURNING id AS pid \gset
EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)
INSERT INTO timeline(user_id, post_id, created_at)
SELECT follower_id, :pid, now() FROM follows WHERE followee_id = :a;
ROLLBACK;
Trước khi mở bảng dưới, ghi ra một con số: ở người đọc theo dõi 50 tài khoản, LATERAL nhanh hơn truy vấn ngây thơ bao nhiêu lần? Và ở 2.000 tài khoản?
4. So ba cách đọc trên cùng người đọc giả
p50 một kết nối, ms, trên dữ liệu gốc:
| Người đọc theo dõi | Ngây thơ (bài 02) | LATERAL | Timeline dựng sẵn | Ngây thơ / timeline |
|---|---|---|---|---|
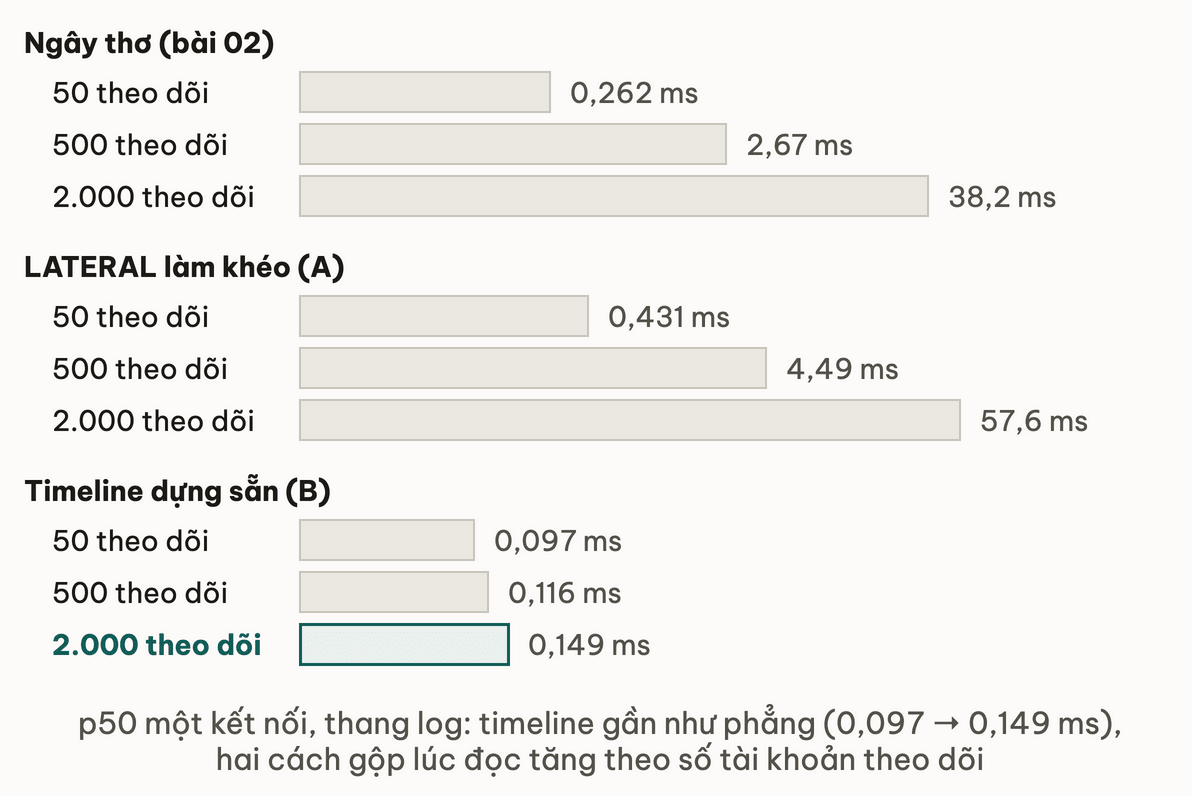
| 50 (1.016 bài ứng viên) | 0,262 | 0,431 | 0,097 | 2,7× |
| 500 (10.015) | 2,67 | 4,49 | 0,116 | 23× |
| 2.000 (39.989) | 38,2 | 57,6 | 0,149 | 256× |
Nếu bạn đoán LATERAL thắng thì đoán trật rồi: nó chậm hơn truy vấn ngây thơ 1,6 / 1,7 / 1,5 lần ở ba mức (người đọc ngẫu nhiên: 1,3 lần). Mỗi tác giả chỉ có khoảng 20 bài, nên LIMIT 50 không cắt được gì: cả hai đọc đúng 1.016 / 10.015 / 39.989 hàng, còn LATERAL trả thêm phí cố định mỗi tài khoản.
Chặn k bài chỉ có lợi khi tác giả đăng nhiều hơn k bài. Thử với posts_heavy, cùng 2 triệu bài nhưng tác giả cũng phân bố đuôi dài (tạo bằng đoạn dưới, rồi đổi tên bảng trong naive.sql và lateral.sql):
CREATE TABLE posts_heavy (
  id bigserial PRIMARY KEY, author_id int NOT NULL, created_at timestamptz NOT NULL,
  body text NOT NULL DEFAULT '', deleted_at timestamptz);
INSERT INTO posts_heavy(author_id, created_at, body)
SELECT floor(exp(random()*ln(100000)))::int + 1, now() - random()*interval '90 days', repeat('x',100)
FROM generate_series(1,2000000);
CREATE INDEX posts_heavy_author_created_idx ON posts_heavy(author_id, created_at DESC);
ANALYZE posts_heavy;
Ở đó LATERAL nhanh hơn 144 lần ở 50 theo dõi, 97 lần ở 500 và 1,8 lần ở 2.000 (59,8 so với 109 ms). Nhưng nó vẫn tăng ×12,6 rồi ×12,3 khi N tăng ×10 rồi ×4 (0,388 → 4,88 → 59,8 ms): LATERAL bảo vệ khỏi tác giả đăng nhiều, không bảo vệ khỏi N lớn.
5. Cái giá của B, và chọn dưới ràng buộc chuẩn
Timeline đọc gần như phẳng theo N: từ 50 đến 2.000 theo dõi (timeline dài 39 lần) chỉ chậm 1,5 lần, vì việc đọc là 50 lần seek theo khoá chính của posts, không phụ thuộc độ dài timeline. Việc gom bài của N người vẫn phải làm, chỉ là làm lúc ghi: mỗi bài nở thành một hàng cho từng người theo dõi. Chi phí fan-out một bài, đo bằng script cuối mục 3:
| Tác giả có | Hàng chèn | Thời gian một bài (trung vị) | µs mỗi hàng |
|---|---|---|---|
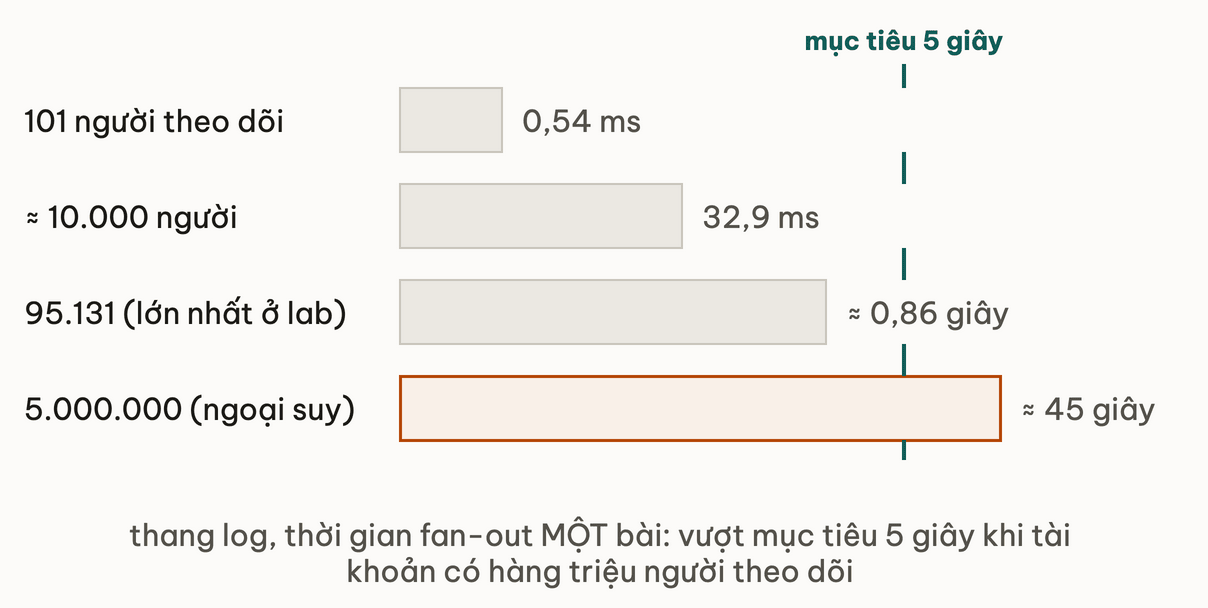
| 101 người theo dõi | 101 | 0,54 ms | 5,3 |
| khoảng 10.000 | 9.953 | 32,9 ms | 3,3 |
| 95.131 (lớn nhất) | 95.132 | khoảng 0,86 giây (0,80 đến 1,18) | 9,0 |
Người theo dõi ×99 thì thời gian ×61; thêm ×9,6 nữa thì ×26, tệ hơn tuyến tính vì mỗi hàng chèn rơi vào chỗ ngẫu nhiên của hai B-tree. Một bài của tác giả lớn nhất làm request đăng bài đứng gần 1 giây nếu fan-out chạy đồng bộ.
Dung lượng: mỗi hàng timeline đo được 115 byte gồm cả hai index (heap khoảng 50 B, mỗi index khoảng 30 B), vì index chiếm gần nửa. Theo bảng ràng buộc, 10 triệu người × 500 bài × 115 B ≈ 575 GB. Ở lab, fan-out toàn bộ 2 triệu bài là khoảng 10,3 GB so với 412 MB của posts: khuếch đại khoảng 25 lần.
Đặt hai bên vào cùng ràng buộc, lấy 500 theo dõi và 3.500 lượt mở/giây. Một lần mở bằng LATERAL tốn 4,49 ms; nhân 3.500 là khoảng 15.700 ms công việc mỗi giây, mười mấy lõi CPU chỉ để dựng feed (nếu tỉ lệ ở máy đo giữ nguyên); ở 2.000 theo dõi là khoảng 200 lõi. Từ timeline, cùng tải chỉ cỡ nửa lõi (0,116 ms × 3.500).
Phía B, đỉnh 28.000 hàng/giây mà một worker ghi được khoảng 110.000 hàng/giây (số lab): cỡ một phần tư worker. Cái giá của B nằm ở hai chỗ: 575 GB phải giữ nóng, và đuôi dài, nơi một bài của tài khoản 5 triệu người theo dõi là 5 triệu hàng, ngoại suy khoảng 45 giây trên một worker, vượt xa mục tiêu 5 giây. Đó là cái giá lộ ra của B; xử lý nó là chuyện của bài 04.
Còn p99 thì sao? Ở 20 kết nối, p99 (ms) của ba cách đọc:
| Theo dõi | Ngây thơ | LATERAL (A) | Timeline (B) |
|---|---|---|---|
| 50 | 4,6 | 6,3 | 1,5 |
| 500 | 24 | 33 | 2,4 |
| 2.000 | 660 | 171 | 3,0 |
A khéo đạt p99 dưới 200 ms ở cả ba mức, nên p99 không phân biệt được A với B. Trục phân biệt thật là tài nguyên ở tải đỉnh: A cần số lõi tăng theo N, B cần 575 GB và một đường ghi chịu được đuôi dài. Dưới đúng bảng ràng buộc, B gánh được: đọc phẳng khoảng 0,1 ms, chi phí ghi trung bình nhỏ. "B thắng" chỉ đúng với tỉ lệ đọc/ghi này; câu tự kiểm bên dưới bắt bạn đổi tỉ lệ.
Bẫy hay gặp
- Phân trang timeline bằng
OFFSETđọc rồi bỏ từng hàng, lại trùng hoặc thiếu bài khi bài mới chèn lên đầu. Dùng con trỏWHERE (created_at, post_id) < (:ts, :id). - Timeline không giới hạn độ dài: bảng phình mãi. Cắt đuôi, giữ 500 bài gần nhất mỗi người, bài cũ hơn gộp lúc đọc.
Tài liệu chính thức của PostgreSQL 16:
- SELECT: LATERAL subqueries: ngữ nghĩa
LATERALtrong mệnh đềFROM. - pgbench:
-f,-D,-l.
6. Tóm tắt
- Con số mang theo: 115 byte mỗi hàng timeline; 0,54 ms / 33 ms / khoảng 0,86 s để fan-out một bài của tài khoản 101 / khoảng 10.000 / 95.131 người theo dõi.
Bài tiếp theo: Tài khoản triệu người theo dõi xử lý cái giá lộ ra của B.
Liên hệ các bài khác
- Bài 01: nguồn của bảng ràng buộc và phép ước lượng 9.200 hàng/giây, 575 GB mà bài này đo lại.
- Bài 02: truy vấn ngây thơ làm mốc so sánh cho LATERAL và timeline.
7. Tự kiểm tra
- Q1Vì sao đọc từ timeline dựng sẵn chỉ chậm 1,5 lần khi số tài khoản theo dõi tăng từ 50 lên 2.000, trong khi LATERAL chậm khoảng 134 lần? Công việc đã đi đâu?
- Q2Đồng nghiệp đo thấy ở 2.000 theo dõi, A có p99 171 ms ở 20 kết nối, dưới 200 ms, nên kết luận "A đạt, khỏi dựng timeline". Bạn trả lời thế nào?
- Q3Tình huống mới: người dùng chỉ mở feed 1 lần/ngày (thay vì 10) và số bài đăng lên 20 triệu/ngày (gấp 10); các thông số khác giữ bảng chuẩn. Tính số hàng timeline phải ghi cho mỗi lần mở feed ở bảng chuẩn và ở tình huống mới, rồi chọn A hay B và nêu cái giá bạn chấp nhận.
- Q4Tình huống mới: dữ liệu thật của bạn có mỗi tác giả đăng hàng nghìn bài trong cửa sổ feed, nhưng người dùng chỉ theo dõi khoảng 30 tài khoản và đỉnh chỉ 200 lượt mở feed/giây. Dùng số đo ở mục 4, bạn chọn gì và vì sao chưa cần dựng timeline?
- Q5Một worker ghi khoảng 110.000 hàng/giây nên đỉnh 28.000 hàng/giây của B nghe rẻ. Cái giá thật của B nằm ở đâu?
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Gộp feed lúc đọc: vì sao một câu JOIN đúng vẫn vỡ p99
Bài tiếpTài khoản triệu người theo dõi: fan-out cho ai, gộp lúc đọc cho ai?
Thảo luận & góp ý
Hỏi đáp về bài này