Tổng kết case news feed: thiết kế hoàn chỉnh và các cái giá
Ráp bảng ràng buộc, phương án ngây thơ và ba quyết định thành một thiết kế feed hoàn chỉnh, kèm bảng cái giá bạn đã chấp nhận ở từng bước.
TL;DR: Thiết kế hoàn chỉnh cho feed 10 triệu người dùng gồm bốn mảnh ráp lại: timeline dựng sẵn lúc ghi để đọc rẻ, một ngưỡng T tách tài khoản nhiều người theo dõi ra khỏi fan-out để hàng đợi không tắc, hàng đợi cộng worker để request đăng bài không treo, và hai bước bù lúc đọc (bài của chính mình, lọc bài đã xoá) để khoảng trễ không lộ ra. Không mảnh nào miễn phí. Bài này gom cái giá của từng mảnh vào một bảng, rồi đo thêm một phép còn thiếu: chi phí đọc cộng dồn của cả bốn phần trong một truy vấn.
Bạn bắt đầu từ một câu hỏi nghe đơn giản: mở feed thì hiện 50 bài mới nhất. Sáu bài sau, câu hỏi đó đã có số, có tên, và có giá. Bài này không có cơ chế mới, chỉ ráp các mảnh lại để bạn kiểm xem mình giải thích được từng mảnh hay chưa.
1. Ráp thành một thiết kế
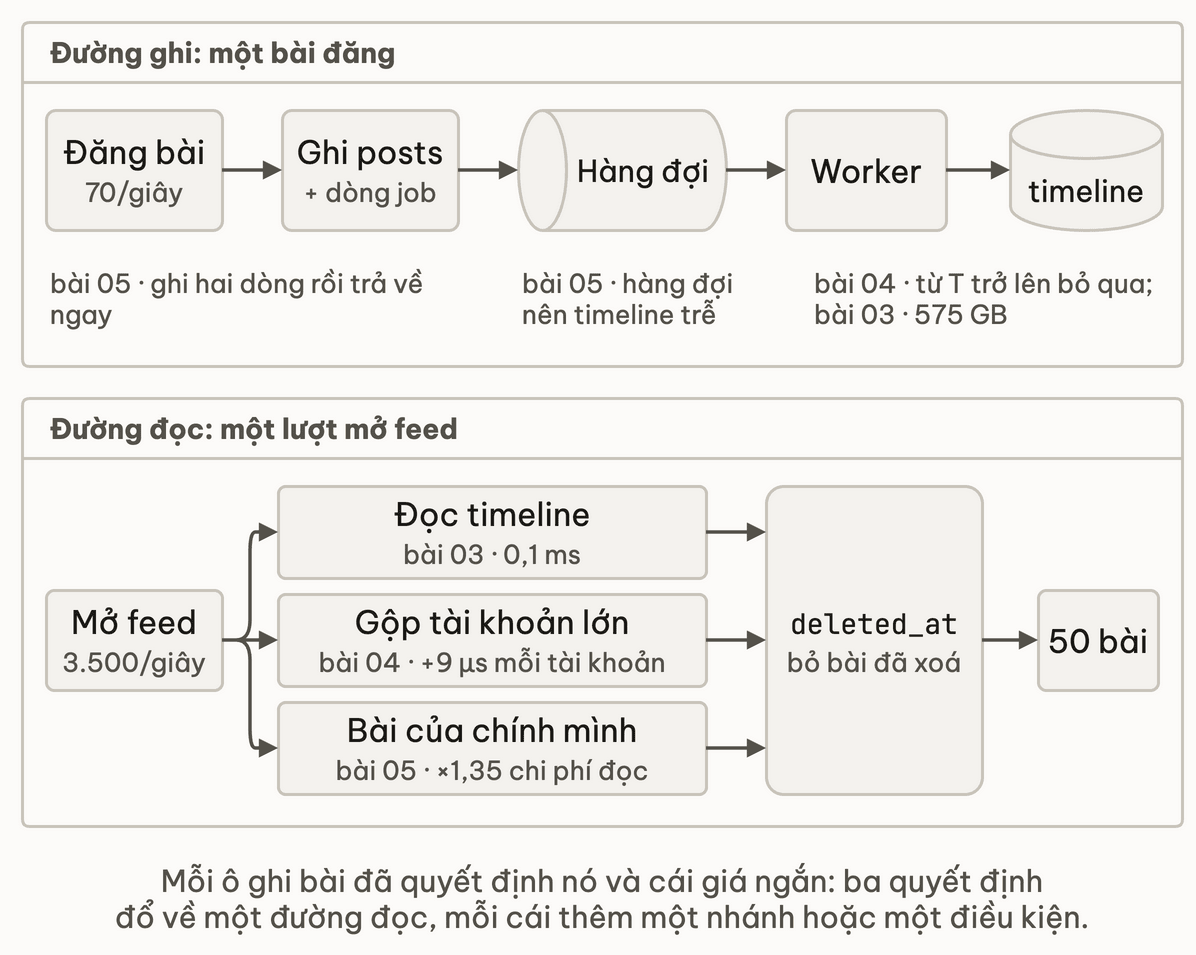
Đi theo hai đường: đường ghi (một bài đăng) và đường đọc (một lượt mở feed).
Đường ghi. Request đăng bài ghi posts và một dòng công việc trong cùng một transaction rồi trả về ngay (bài 05). Worker nhặt job và chèn một hàng timeline cho từng người theo dõi, nhưng chỉ với tác giả dưới ngưỡng T (bài 04). Tác giả từ T người theo dõi trở lên không được fan-out: một bài của họ chỉ là một hàng trong posts. Việc dựng sẵn timeline là quyết định gốc (bài 03), dựng trên bảng ràng buộc ở bài 01.
Đường đọc. Mở feed đọc 50 hàng từ timeline của người đó, rồi gộp thêm bài mới nhất của các tài khoản lớn mà họ theo dõi, thêm bài của chính họ (để người đăng thấy bài mình trong khoảng job chưa chạy), và bỏ bài có deleted_at. Mỗi phần là một nhánh hoặc một điều kiện trong cùng truy vấn.
2. Bảng cái giá bạn đã chấp nhận
Cột "lựa chọn" chỉ đúng dưới ràng buộc chuẩn của case, không phải khuyến nghị chung. Mọi số là số đo của tác giả trên Apple M4, Postgres 16 trong Docker; máy bạn cho số khác nhưng tỉ lệ phải giống.
| Bước | Lựa chọn | Cái giá | Số đo bằng chứng |
|---|---|---|---|
| Ràng buộc (bài 01) | Chốt bảng số, tải đỉnh là chuẩn | Tự đặt số, sai thì sai cả thiết kế; phân bố lệch nên không dùng trung bình | Fan-out lúc ghi nở 70 bài mỗi giây thành khoảng 28.000 hàng mỗi giây; 0,43% tài khoản giữ 46,8% số cạnh theo dõi |
| Ngây thơ (bài 02) | Bỏ: JOIN follows với posts mỗi lần mở feed | Chi phí tăng theo số tài khoản người đọc theo dõi; vỡ p99 khi có nhiều người đọc cùng lúc | Ở 2.000 theo dõi và 20 kết nối: p99 660 ms (ràng buộc 200 ms), thông lượng 48 truy vấn mỗi giây so với 15.570 ở 50 theo dõi |
| Chỗ trả giá (bài 03) | Dựng sẵn timeline lúc ghi | 115 byte mỗi hàng; ghi nhiều hơn đọc về số hàng; một bài của tài khoản lớn thành rất nhiều hàng | Đọc 0,097 đến 0,149 ms bất kể 50 hay 2.000 theo dõi; ở 3.500 lượt mở/giây, LATERAL cần mười mấy lõi CPU ở 500 theo dõi so với cỡ nửa lõi cho timeline; timeline 10 triệu người × 500 bài ≈ 575 GB; 5 triệu hàng ≈ 45 giây trên một worker |
| Ngưỡng tài khoản lớn (bài 04) | Hybrid: từ T người theo dõi không fan-out, gộp lúc đọc | Mọi đường đọc có thêm một nhánh; danh sách tài khoản lớn phải luôn đúng; cột follower_count thành hàng nóng ở tài khoản lớn | T = 1.000 tách 429 tài khoản, tiết kiệm 47% hàng ghi; T = 10.000 tách 40 tài khoản, tiết kiệm 25%. Đọc 2,3 lần chỉ-timeline khi không theo dõi tài khoản lớn nào, 4,1 đến 4,2 lần khi theo dõi 20; thêm khoảng 9 µs mỗi tài khoản lớn |
| Fan-out trễ (bài 05) | Hàng đợi cộng worker, bù lúc đọc | Có khoảng trễ thật; thêm worker lợi giảm dần; hai bước bù đều nằm trên đường đọc; xoá thật cần index | khi hàng đợi còn job nặng, 8 worker xả nhanh 3,5 lần so với 1 (có cổng T: 5,4 lần); gộp bài của mình tốn khoảng 1,35 lần chi phí đọc; lọc deleted_at đổi p50 từ 0 đến 4%; index post_id tốn 85 MB (+8,6%) |
Đọc cột cuối theo hàng ngang, bạn thấy mỗi cái giá đều có một con số đứng sau. Khi ai đó hỏi "sao không dùng cách X", câu trả lời tốt là chỉ vào hàng tương ứng, không phải nói "vì nó phức tạp hơn".
Bảng ở trên còn thiếu một phép: chi phí đọc cộng dồn của cả bốn phần trong cùng một truy vấn. Đo thêm trên lab, với truy vấn gộp timeline, các tài khoản lớn, bài của chính người đọc, và lọc deleted_at ở mọi nhánh (1% bài đã xoá, T = 1.000; với T = 10.000 chỉ đổi số 1000 thành 10000):
-- feed_full.sql
SELECT id, created_at FROM (
  (SELECT p.id, p.created_at FROM timeline t JOIN posts p ON p.id = t.post_id
    WHERE t.user_id = :r AND p.deleted_at IS NULL
    ORDER BY t.created_at DESC LIMIT 50)
  UNION
  (SELECT p.id, p.created_at
     FROM follows f JOIN users u ON u.id = f.followee_id AND u.follower_count >= 1000
     CROSS JOIN LATERAL (SELECT id, created_at FROM posts
                          WHERE author_id = f.followee_id AND deleted_at IS NULL
                          ORDER BY created_at DESC LIMIT 50) p
    WHERE f.follower_id = :r)
  UNION
  (SELECT id, created_at FROM posts
    WHERE author_id = :r AND deleted_at IS NULL
    ORDER BY created_at DESC LIMIT 50)
) x ORDER BY created_at DESC LIMIT 50;
Hai người đọc, người theo dõi 50 tài khoản và người theo dõi 2.000 tài khoản (cùng cách chọn tài khoản theo đuôi dài như bài 02, timeline chỉ gồm tác giả dưới T), median của 3 lần chạy 6 giây. Cột "chỉ timeline" là truy vấn đọc timeline có lọc xoá của cùng người đọc:
| Người đọc | T | Chỉ timeline: p50 1 kết nối, p99 20 kết nối | Truy vấn đầy đủ: p50 1 kết nối | Truy vấn đầy đủ: p99 20 kết nối |
|---|---|---|---|---|
| 50 theo dõi, 19 tài khoản lớn | 1.000 | 0,098 ms, 1,6 ms | 0,363 ms | 5,7 ms |
| 50 theo dõi, 5 tài khoản lớn | 10.000 | 0,097 ms, 1,5 ms | 0,270 ms | 4,1 ms |
| 2.000 theo dõi, 126 tài khoản lớn | 1.000 | 0,148 ms, 2,6 ms | 3,26 ms | 30 ms (dải 27,5 đến 32,0) |
| 2.000 theo dõi, 14 tài khoản lớn | 10.000 | 0,149 ms, 2,5 ms | 2,32 ms | 21,6 ms (dải 21,4 đến 21,8) |
Trường hợp xấu nhất, p99 khoảng 30 ms, vẫn dưới 200 ms nhiều lần, nên thiết kế hoàn chỉnh không phá ngân sách p99. Cái giá nằm ở CPU: nhân p50 một kết nối với 3.500 lượt mở/giây (bỏ qua tranh chấp), người đọc 50 theo dõi tốn cỡ 1,3 lõi, còn nếu mọi người đọc đều theo dõi 2.000 tài khoản thì cỡ 11 lõi. Ở 50 theo dõi, phần cộng thêm so với chỉ timeline là 0,265 ms; trừ phí cố định của nhánh phụ khoảng 0,13 ms (bài 04) thì còn khoảng 7 µs mỗi tài khoản lớn ((0,265 trừ 0,128) chia 19), khớp với 9 µs của bài 04. Ở 2.000 theo dõi với 126 tài khoản lớn, phần cộng thêm là khoảng 3,1 ms. Nhánh phụ phải duyệt và nối users cho mọi dòng follows của người đọc, nên phí cố định tăng theo số tài khoản đang theo dõi, và từ số đo này không tách được nó khỏi phí mỗi tài khoản lớn.
Nhìn lại từng mảnh: bài 01 chốt đỉnh 3.500 lượt mở feed và 70 bài mỗi giây, bài 03 đổi chi phí đọc lấy chi phí ghi, bài 04 tách tài khoản lớn bằng ngưỡng T, bài 05 đưa fan-out vào hàng đợi và bù hai bước lúc đọc.
3. Đổi ràng buộc, quyết định nào đổi?
Ba quyết định nằm trên ba trục riêng, nên một thay đổi ràng buộc thường chỉ lật một trục. Điểm nối cần nhớ là đường đọc: mỗi quyết định thêm một phần vào truy vấn mở feed, nên đổi một ràng buộc có thể làm đường đọc nặng thêm chứ không chỉ đổi quyết định nằm trên trục đó. Giờ tự thử với ba tình huống, rồi so với đáp án mẫu.
- Q1Nếu tỉ lệ đọc/ghi đổi từ khoảng 50 : 1 xuống còn 1 : 1 (người dùng ít mở feed hơn nhiều, đăng nhiều hơn), quyết định nào đổi?
- Q2Nếu phân bố người theo dõi bớt lệch: người theo dõi nhiều nhất chỉ còn 5.000 thay vì 5 triệu, quyết định nào đổi?
- Q3Nếu bài mới phải tới người theo dõi trong 1 giây thay vì 5 giây, cái giá nào nặng thêm?
Liên hệ các bài khác
- Bài 06: Đối chiếu thực tế nhắc rằng hệ thống thật chọn khác vì ràng buộc của họ khác. Bảng cái giá ở trên là công cụ để làm phép so sánh đó.
- Bài 01 là nơi mọi con số trong bảng bắt đầu.
Tóm tắt
- Phép đo cộng dồn cho thấy phí cố định của nhánh gộp tăng theo số tài khoản đang theo dõi, nên con số cộng thêm của bài 04 (phí cố định cộng 9 µs mỗi tài khoản lớn) chỉ là cận dưới khi người đọc theo dõi hàng nghìn tài khoản.
- Việc cần làm sau bài này: đổi một dòng trong bảng ràng buộc, rồi xem quyết định nào lật và quyết định nào kéo theo.
✅ Self-assessment
- Ước lượng tải đọc, tải ghi và số ghi timeline mỗi giây của một news feed từ bảng ràng buộc tự đặt và phân bố người theo dõi đo trên máy mình
- Nếu chưa: đọc lại bài 01, mục tải đọc, tải ghi và lab đo.
- Chẩn đoán vì sao dựng feed bằng JOIN lúc đọc vỡ p99 khi số tài khoản đang theo dõi và tải đọc tăng
- Nếu chưa: đọc lại bài 02, mục p99 khi một người đọc và khi 20 người cùng đọc.
- Chọn giữa fan-out lúc ghi và fan-out lúc đọc theo tỉ lệ đọc/ghi và chi phí ở tải đỉnh
- Nếu chưa: đọc lại bài 03, phần
<DesignChoice>và mục cái giá của B.
- Nếu chưa: đọc lại bài 03, phần
- Thiết kế ngưỡng tách tài khoản nhiều người theo dõi khỏi fan-out lúc ghi theo phân bố người theo dõi
- Nếu chưa: đọc lại bài 04, mục phân bố lệch và mục gộp lúc đọc trả giá bao nhiêu.
- Thiết kế luồng fan-out bất đồng bộ giữ read-your-writes cho người đăng và gỡ được bài đã xoá khỏi feed
- Nếu chưa: đọc lại bài 05, mục người đăng không thấy bài của mình và mục bài đã xoá.
- Biện luận vì sao một mạng xã hội thật chọn khác thiết kế của bạn dựa trên ràng buộc của họ
- Nếu chưa: đọc lại bài 06, cách tách ràng buộc, lựa chọn và phần thiết kế của bạn sẽ đổi.
Bài tiếp theo
Case news feed khép lại ở đây. Muốn đào sâu một mảnh bạn vừa chạm, các khoá khác của OLHub bàn về chia dữ liệu và độ trễ sao chép, những thứ bài 04 và 05 chỉ nhắc tới. Đọc thêm, không phải tiên quyết: Key range vs hash trong data-phan-tan và Replication lag trong data-phan-tan.
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Đối chiếu thực tế: các mạng xã hội đã dựng feed thế nào?
Khoá tiếp theoThông báo: không mất, không gửi trùng
Case thứ ba của tuyến Thiết kế Hệ thống. Bạn tự đặt ràng buộc gửi OTP, tin giao dịch và tin khuyến mãi qua nhà cung cấp ngoài, tự mô phỏng timeout và worker chết trên Postgres để đếm tin trùng và tin mất, rồi tự chọn mức giao nhận cho từng loại, khoá chống trùng và cách cách ly luồng gửi — mỗi lựa chọn kèm cái giá — trước khi đối chiếu cách các hệ thống thông báo thật đã làm.
8 bài · ~1.5 giờThảo luận & góp ý
Hỏi đáp về bài này