Fan-out chạy trễ: người đăng, người theo dõi và bài đã xoá thấy gì?
Fan-out đẩy sang worker nền thì bài tới timeline chậm hơn. Thiết kế để người đăng vẫn thấy bài mình, bài đã xoá biến mất, và biết cần bao nhiêu worker.
TL;DR: Fan-out trong request đăng bài làm tài khoản lớn treo hàng chục giây, nên nó đi vào hàng đợi cho worker nền. Đổi lại, bài tới timeline trễ: người đăng có thể không thấy bài mình và bài đã xoá có thể vẫn hiện. Người đăng muốn thấy bài mình thì phải gộp thêm một nhánh lúc đọc, tốn khoảng 1,35 lần chi phí đọc. Lọc bài đã xoá lúc đọc thì gần như miễn phí, còn xoá thật khỏi mọi timeline thì cần thêm index 85 MB.
Bạn vừa đăng một bài rồi quay lại trang chủ. Bài đâu? Ở bài 03 và 04, fan-out là một câu lệnh chèn hàng loạt, và bạn chưa hỏi nó chạy lúc nào, ở đâu. Bài này đổi trục sang thời gian: từ lúc đăng đến lúc bài có mặt ở timeline người khác là bao lâu, và trong khoảng đó ai thấy gì.
1. Đưa fan-out ra khỏi request đăng bài
Từ bảng ràng buộc ở bài 01: bài mới tới feed người theo dõi trong 5 giây, và người đăng thấy bài mình ngay.
Từ bài 03 bạn đã chọn dựng sẵn timeline lúc ghi. Nhưng một bài của tài khoản 5 triệu người theo dõi là 5 triệu hàng, khoảng 45 giây trên một worker (ước lượng bài 01). Nếu việc đó nằm trong request đăng bài, người đăng nhìn vòng quay gần một phút. Bài 04 đã tách tài khoản từ ngưỡng T trở lên khỏi fan-out; hàng đợi này chỉ phục vụ phần còn lại.
Muốn request đăng bài trả về trong vài mili-giây dù tài khoản có 5 triệu người theo dõi, bạn cần lưu lại điều gì, và ai làm phần việc còn lại? Hai worker cùng nhìn danh sách việc thì làm sao không nhặt trúng cùng một việc? Ghi ra hai câu trả lời trước khi đọc tiếp.
Lời giải gồm hai mảnh. Request đăng bài chỉ ghi bài vào posts và một dòng công việc vào fanout_jobs trong cùng một transaction rồi trả về. Phần chèn hàng loạt vào timeline là việc của worker, tiến trình nền lặp: lấy một job chưa làm, fan-out, đánh dấu xong.
Mảnh thứ hai là chỗ nhiều worker không giẫm chân nhau. SELECT ... FOR UPDATE khoá dòng job đã chọn; thêm SKIP LOCKED thì dòng nào đang bị worker khác khoá sẽ bị bỏ qua thay vì chờ, nên mỗi worker nhặt một job riêng. Job nào bị bỏ sót lượt này sẽ được nhặt lượt sau (tài liệu PostgreSQL 16).
CREATE TABLE fanout_jobs (
  id        bigserial PRIMARY KEY,
  post_id   bigint NOT NULL,
  author_id int NOT NULL,
  posted_at timestamptz NOT NULL DEFAULT clock_timestamp(),
  status    text NOT NULL DEFAULT 'pending',
  done_at   timestamptz
);
CREATE INDEX fanout_jobs_pending_idx ON fanout_jobs (id) WHERE status = 'pending';
Index partial chỉ phủ job còn pending nên tìm job kế tiếp luôn rẻ. Một lượt worker là một câu, một transaction. Tự điền hai chỗ TODO trước khi xem lời giải:
-- worker.sql skeleton: one job per run
WITH j AS (/* TODO: take the smallest pending job that no other worker holds */),
ins AS (INSERT INTO timeline (user_id, post_id, created_at)
  /* TODO: followers of the author (only if author is under T), plus the author */
  RETURNING 1)
UPDATE fanout_jobs SET status = 'done', done_at = clock_timestamp()
FROM j WHERE fanout_jobs.id = j.id;
Viết hai đoạn TODO ra giấy, nhớ rằng tác giả từ T trở lên không được fan-out, rồi đối chiếu với lời giải dưới đây.
Lời giải. Cổng follower_count < :T (truyền bằng pgbench -D T=...) là chỗ bài 04 móc vào hàng đợi:
-- worker.sql (solution)
WITH j AS (
  SELECT id, post_id, author_id FROM fanout_jobs
  WHERE status = 'pending' ORDER BY id
  FOR UPDATE SKIP LOCKED LIMIT 1),
ins AS (
  INSERT INTO timeline (user_id, post_id, created_at)
  SELECT f.follower_id, j.post_id, now()
  FROM j JOIN users a ON a.id = j.author_id AND a.follower_count < :T
         JOIN follows f ON f.followee_id = j.author_id
  UNION ALL
  SELECT j.author_id, j.post_id, now() FROM j
  RETURNING 1)
UPDATE fanout_jobs SET status = 'done', done_at = clock_timestamp()
FROM j WHERE fanout_jobs.id = j.id;
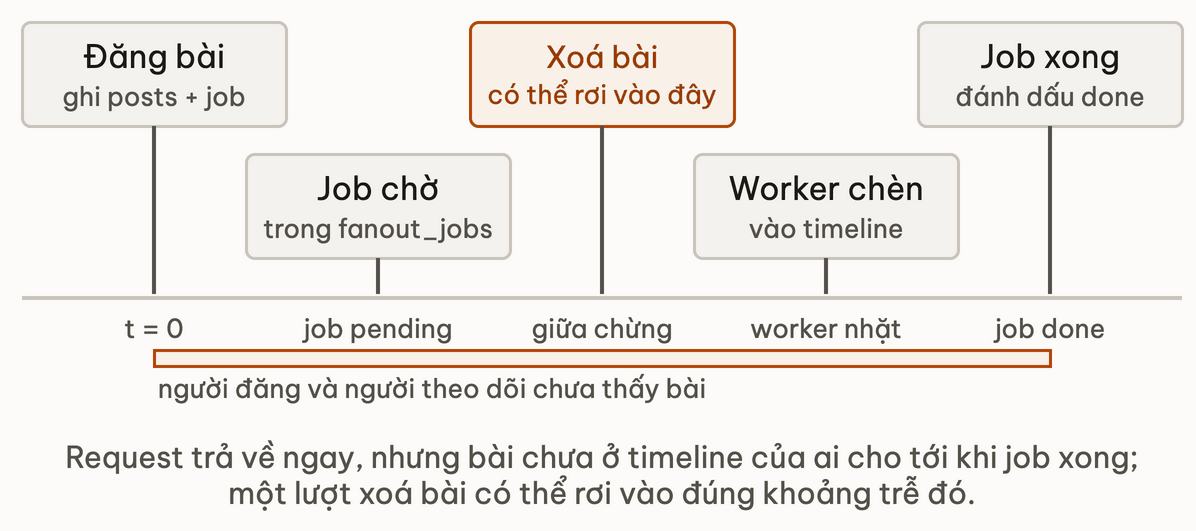
Worker chết giữa chừng thì transaction rollback, job trở lại pending. Cái giá nằm ở chỗ khác: giờ có một khoảng thời gian bài đã đăng nhưng chưa có trong timeline của ai.
2. Bao nhiêu worker thì hàng đợi không tồn?
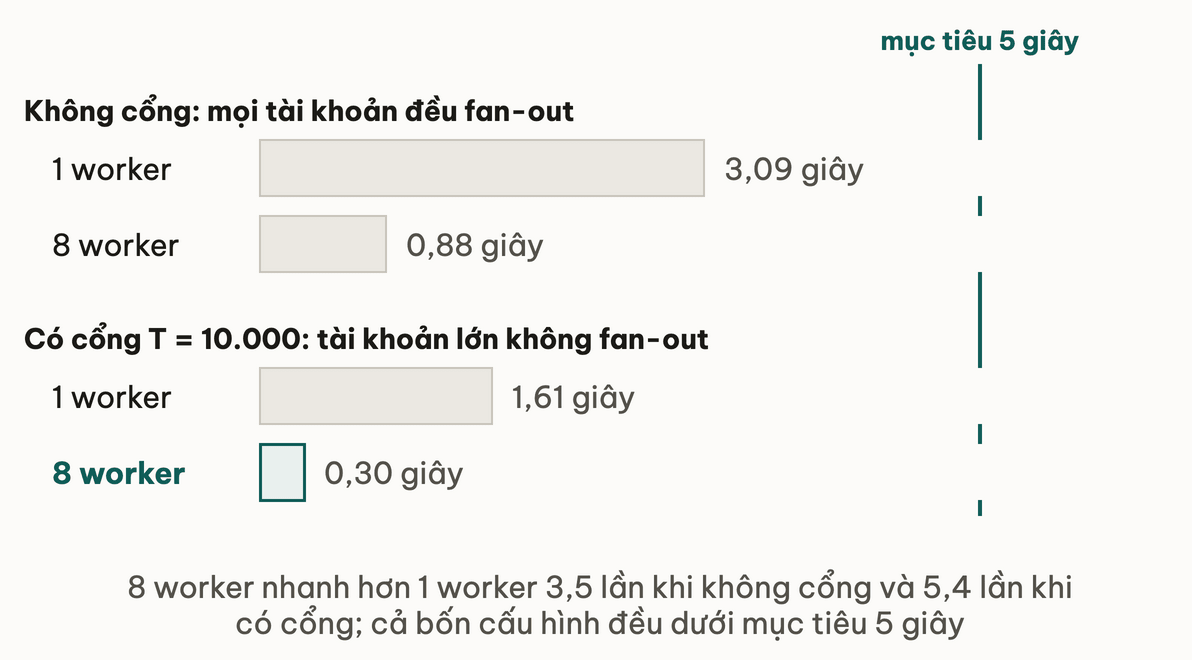
Thêm worker rút khoảng trễ, nhưng rút bao nhiêu thì tuỳ hàng đợi có job nặng hay không. Thí nghiệm: đăng dồn 1.000 bài, trong đó 52 bài của 40 tài khoản từ 10.000 người theo dõi trở lên, rồi cho W client pgbench chạy worker.sql (-c W -j W -t $((1000/W))) vào bản sao rỗng của timeline. Đo hai lần: không cổng (-D T=1000000000, để thấy tác động của job nặng) và có cổng -D T=10000 như bài 04. Trên Apple M4, Postgres 16 trong Docker, median 3 lần chạy: 8 worker xả hết 1.000 job nhanh 3,5 lần so với 1 worker khi không cổng (3,09 s xuống 0,88 s), và nhanh 5,4 lần khi có cổng (1,61 s xuống 0,30 s).
Khi hàng đợi còn 52 job nặng, job nặng cuối cùng quyết định thời gian xả hết, nên thêm worker lợi giảm dần. Bỏ 52 job đó bằng cổng T thì cùng 8 worker nhanh hơn rõ. Vậy tách tài khoản lớn mới là đòn chính, thêm worker là đòn phụ: job nguyên khối 45 giây của tài khoản 5 triệu người theo dõi không chẻ nhỏ được bằng cách thêm worker.
3. Người đăng không thấy bài của chính mình
Cái giá thứ hai. Bạn đăng bài, job còn pending, feed đọc từ timeline dựng sẵn. Tác giả đã chạy kịch bản đó: đăng một bài, chưa chạy worker, đọc top 50 từ timeline.
Chỉ đọc từ timeline và job chưa chạy: trong 50 dòng trả về, có bao nhiêu dòng là bài bạn vừa đăng?
Không dòng nào: kết quả đo là 0/50. Bài nằm an toàn trong posts, nhưng timeline của bạn chưa có nó. Đây là read-your-writes của bài replication lag, chỉ khác nguồn trễ: ở đó follower chưa áp log, ở đây worker chưa chèn timeline.
Người dùng phải thấy thứ mình vừa ghi, bằng cách đọc từ nơi chắc chắn đã có. Ở đây nơi đó là posts.
Áp vào đây: lúc đọc feed của chính người đăng, lấy thêm 50 bài gần nhất của chính họ từ posts, UNION với timeline (UNION loại trùng theo id, nên khi worker chạy xong thì bài không hiện hai lần), rồi cắt lại 50. Điền chỗ TODO trước khi xem lời giải:
-- own_merge.sql skeleton
SELECT id, created_at FROM (
  (SELECT p.id, p.created_at FROM timeline t JOIN posts p ON p.id = t.post_id
   WHERE t.user_id = :r AND p.deleted_at IS NULL ORDER BY t.created_at DESC LIMIT 50)
  UNION /* TODO: the reader's own posts, skip deleted ones */) u
ORDER BY created_at DESC LIMIT 50;
Lời giải: nhánh thứ hai là SELECT id, created_at FROM posts WHERE author_id = :r AND deleted_at IS NULL ORDER BY created_at DESC LIMIT 50, đặt vào chỗ TODO. Cả hai nhánh đều lọc deleted_at IS NULL.
Chạy lại kịch bản: đọc có gộp cho 1/50. Sau khi worker chạy xong, đọc chỉ từ timeline cũng ra 1, vì worker.sql chèn cả vào timeline của chính tác giả (nhánh UNION ALL).
Cái giá, đo bằng pgbench trên người theo dõi 500 tài khoản (timeline đủ đầy, đo trước khi nhánh timeline có thêm điều kiện lọc xoá, thứ chỉ đổi p50 khoảng 0 đến 4%):
| p50 (1 kết nối) | p50 (20 kết nối) | p99 (20 kết nối) | |
|---|---|---|---|
| Chỉ timeline | 0,124 ms | 0,498 ms | 3,62 ms |
| Gộp bài của mình | 0,167 ms | 0,641 ms | 4,90 ms |
| Tỉ lệ | 1,35× | 1,29× | 1,35× |
Chi phí đọc tăng khoảng 1,3 đến 1,35 lần cho mọi lượt mở feed, kể cả lúc người đó chưa đăng gì. Con số nhỏ so với 200 ms, nhưng nhân với 3.500 lượt mỗi giây thì phải tính.
4. Bài đã xoá: gỡ lúc đọc hay gỡ khỏi từng timeline?
Cái giá thứ ba là bài đã xoá. Tác giả xoá bài, nhưng bài đã nằm trong timeline của hàng trăm hay hàng chục nghìn người. Dưới ràng buộc đã nêu, có bốn cách gỡ, và mỗi cách trả một loại giá khác nhau.
Ràng buộc: Timeline dựng sẵn 500 bài mỗi người · fan-out bất đồng bộ qua hàng đợi · bài đã xoá không được hiện trong feed · đỉnh 3.500 lượt mở feed/giây
Với ràng buộc này, bạn chấp nhận cái giá nào?
Chọn trước khi đọc tiếp — phần sau phân tích từng cái giá.
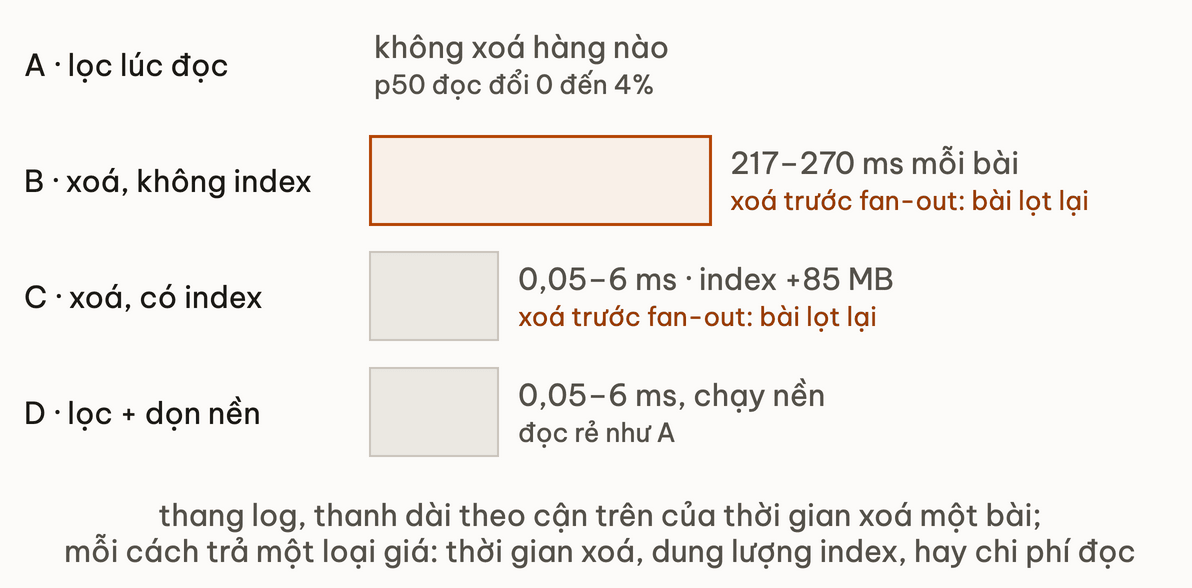
Phương án A rẻ vì truy vấn dựng feed vốn JOIN posts, nên p.deleted_at IS NULL chỉ là một điều kiện nữa. Đo hai người đọc (50 và 2.000 tài khoản đang theo dõi, 1% bài đã xoá), không lọc so với có lọc, cho p50 gần như trùng nhau: 0,102 ms với 0,102 ms ở người 50 theo dõi, 0,193 ms với 0,200 ms ở người 2.000 theo dõi. LIMIT 50 vẫn đủ 50 dòng nếu điều kiện nằm trong cùng WHERE của truy vấn đã JOIN. Nhánh tài khoản lớn ở bài 04 và nhánh bài của mình ở mục 3 cùng đọc posts, nên lọc deleted_at IS NULL tự nhiên theo cùng cách.
-- tl_read_del.sql
SELECT p.id, p.author_id, p.created_at
FROM timeline t JOIN posts p ON p.id = t.post_id
WHERE t.user_id = :r AND p.deleted_at IS NULL
ORDER BY t.created_at DESC LIMIT 50;
Phương án B là bẫy ngây thơ: DELETE FROM timeline WHERE post_id = :pid trên bảng chỉ có index theo user buộc Postgres quét cả bảng. Trên mẫu 9 triệu hàng, bài của tài khoản 101 người theo dõi tốn 217 ms, bài của tài khoản 95 nghìn người tốn 223 ms.
Phương án C sửa bằng một index trên timeline: 217 ms thành 0,05 ms ở bài nhỏ, 6 ms ở bài lớn.
CREATE INDEX timeline_post_idx ON timeline (post_id);
Index của C tính cho mọi bài đăng dù phần lớn không bao giờ bị xoá: +8,6% của 575 GB (bài 01) là khoảng 50 GB. Số fan-out chậm thêm 4% đến 20% có dải đo chồng nhau nên chưa chắc.
B và C còn một lỗi mà A không gặp: xoá chạy trước fan-out. Bài đăng rồi xoá khi job còn pending: DELETE không thấy hàng nào, rồi worker chèn đúng bài đã xoá. Đây là suy luận, không phải số đo; cách chặn là worker kiểm deleted_at trước khi chèn, hoặc giữ bộ lọc lúc đọc của A làm lưới an toàn. Hai trong ba cách sửa ở bài này đẩy việc về lúc đọc, phía bạn đã cố giữ rẻ từ bài 03.
5. Bẫy hay gặp
❌ Fan-out đồng bộ trong request đăng bài: tài khoản lớn làm request timeout, người đăng bấm lại và đăng trùng.
✅ Ghi posts và fanout_jobs trong cùng transaction rồi trả về; fan-out là việc của worker.
❌ DELETE FROM timeline WHERE post_id = ... trên bảng không có index post_id: mỗi bài xoá quét cả bảng, 217 ms trở lên.
✅ Lọc deleted_at IS NULL lúc đọc, hoặc chấp nhận trả 85 MB cho index và kiểm lại deleted_at trong worker fan-out.
Liên hệ các bài khác
- Bài 04: tài khoản triệu người theo dõi, ngưỡng T: tài khoản từ T trở lên không vào hàng đợi, bài của họ gộp lúc đọc.
- Bài 06: đối chiếu thực tế, các mạng xã hội thật xử lý độ trễ fan-out ra sao.
Tóm tắt
- Worker chỉ fan-out cho tác giả dưới T, và chèn cả vào timeline của chính tác giả; thêm worker có lợi giảm dần khi hàng đợi còn job nặng.
- Mọi nhánh đọc (timeline, tài khoản lớn, bài của mình) lọc
deleted_at IS NULL; DELETE thật chỉ là việc dọn, và worker kiểmdeleted_attrước khi chèn.
6. Tự kiểm tra
- Q1Vì sao đưa fan-out vào hàng đợi giải được request đăng bài treo, nhưng lại tạo ra bài toán người đăng không thấy bài mình?
- Q2Worker A đang giữ job 7 thì worker B chạy cùng câu lệnh lấy job. B làm gì với job 7, thiếu SKIP LOCKED thì sao, và nếu worker A chết giữa chừng thì job 7 ra sao?
- Q3Bạn gộp bài của chính mình lúc đọc bằng UNION. Vì sao dùng UNION thay vì UNION ALL, và cái giá của cách sửa này là gì?
- Q4Dưới ràng buộc timeline khoảng 575 GB, bạn gỡ bài đã xoá bằng cách nào: lọc lúc đọc, DELETE không index, hay DELETE có index? Nêu cái giá.
- Q5Tình huống mới: một tác giả đăng bài rồi xoá sau 1 giây, lúc job fan-out còn
pending, và bạn đang dùng DELETE có index. Điều gì xảy ra với timeline người theo dõi, và bạn sửa thế nào? Ghi ít nhất một cách sửa trước khi mở đáp án.
Bài tiếp theo: Đối chiếu thực tế: các mạng xã hội thật xử lý fan-out thế nào
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tài khoản triệu người theo dõi: fan-out cho ai, gộp lúc đọc cho ai?
Bài tiếpĐối chiếu thực tế: các mạng xã hội đã dựng feed thế nào?
Thảo luận & góp ý
Hỏi đáp về bài này