Đối chiếu thực tế: các mạng xã hội đã dựng feed thế nào?
Đặt thiết kế feed của bạn cạnh Twitter, Facebook và ZingMe: năm nào, ràng buộc gì (đọc/ghi, xếp hạng ML, năng lực đội) và vì sao họ chọn khác bạn.
TL;DR: Bài này đặt thiết kế của bạn (fan-out lúc ghi, ngưỡng cho tài khoản lớn, hàng đợi, gộp bài của chính mình khi đọc) cạnh ba hệ công khai (năm nguồn): Twitter 2012 và 2023, Facebook (Meta) 2013 và 2021, ZingMe của VNG khoảng 2012. Mỗi hệ chọn khác bạn vì một ràng buộc không có trong bảng của bạn: xếp hạng bằng ML, kho đồ thị đọc áp đảo, hay chỉ đơn giản là đội ngũ chưa đủ sức làm phương án còn lại.
Bạn đã có một thiết kế cho bảng ràng buộc tự đặt: 10 triệu người dùng mỗi ngày, đọc/ghi khoảng 50:1, trang feed 50 bài với p99 dưới 200 ms, bài mới tới người theo dõi trong 5 giây, tài khoản lớn nhất 5 triệu người theo dõi. Câu hỏi quen thuộc là "vậy Facebook làm thế nào?". Hỏi vậy dễ thành học thuộc. Hỏi xem họ có ràng buộc nào mà bạn không có thì có ích hơn.
Mọi số liệu công ty trong bài đều kèm năm và link nguồn; nguồn nào chỉ là bản tóm tắt thứ cấp thì bài ghi rõ. Có một điều bài này nói thẳng: không có writeup kỹ thuật công khai nào của nền tảng Việt Nam đang chạy (Zalo, Facebook Việt Nam...) mà tác giả tìm được, nên phần Việt Nam chỉ dựa vào một bộ slide của VNG từ khoảng 2012.
1. Đọc một case thế nào: ràng buộc nào khác bạn?
Thiết kế của bạn, đúng như bài 03 đến bài 05 dẫn tới, có ba phần. Trước đó là hai bước loại bỏ: bài 02 cho thấy JOIN ngây thơ vỡ p99, bài 03 cho thấy gộp lúc đọc làm khéo vẫn tốn lõi CPU tăng theo số tài khoản theo dõi ở tải đỉnh.
- Bài 03: fan-out lúc ghi, dựng sẵn timeline mỗi người, đổi chi phí đọc lấy chi phí ghi.
- Bài 04: ngưỡng số người theo dõi; tài khoản trên ngưỡng không fan-out mà được gộp lúc đọc.
- Bài 05: fan-out chạy qua hàng đợi và worker, nên có độ trễ; người đăng thấy bài của mình ngay nhờ gộp bài của chính họ lúc đọc.
Với mỗi hệ dưới đây bạn làm ba việc theo thứ tự: đoán, đọc lời giải, rồi tự hỏi "nếu bảng của tôi mang ràng buộc đó, thiết kế của tôi đổi chỗ nào".
Bạn đã học vì sao bản sao trễ một nhịp và vì sao người đăng phải đọc được bài của chính mình ngay (read-your-writes). Fan-out bất đồng bộ ở bài 05 là cùng bài toán đó ở tầng timeline, và các hệ thật dưới đây đều phải trả lời nó theo cách của họ.
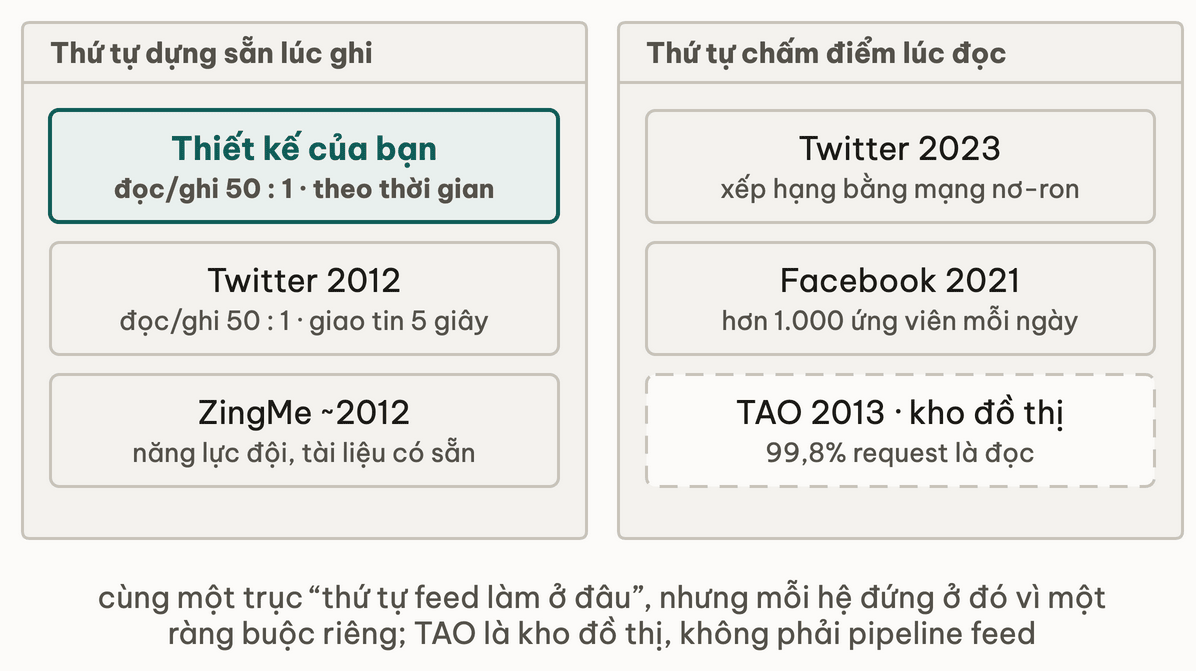
2. Vì sao Twitter 2012 giống bạn còn 2023 đã khác?
Một mạng có đọc/ghi cỡ 50:1 như bảng của bạn, với vài tài khoản cực lớn: bạn đoán họ fan-out cho ai? Và nếu sau đó họ thêm xếp hạng bằng mạng nơ-ron, feed còn là "danh sách bài dựng sẵn" không? Viết ra hai câu trả lời trước khi đọc tiếp.
Twitter 2012: timeline dựng sẵn, tài khoản lớn gộp lúc đọc
Nguồn dưới đây là thứ cấp. Talk gốc là "Timelines at Scale" của Raffi Krikorian tại QCon San Francisco 2012; phần chi tiết bài này dùng lấy từ bản tóm tắt trên HighScalability (8/7/2013), không phải từ writeup chính thức của Twitter. Theo bản tóm tắt đó, timeline nhà của mỗi người nằm trong một cụm Redis, tối đa 800 mục, và giải pháp là fan-out lúc ghi. Mục tiêu là một tin tới người dùng trong không quá 5 giây, nhưng nguồn ghi rõ không phải lúc nào cũng đạt: p99 có thể tới 5 phút. Đọc timeline chiếm 300 nghìn QPS còn ghi chỉ 6.000 request mỗi giây, tức đọc/ghi cỡ 50:1. Chỉ người "hoạt động" (đăng nhập trong 30 ngày) mới nhận fan-out. Mục "The Future" của nguồn có thêm một câu: "For people like Taylor Swift don't bother with fanout anymore, instead merge in her timeline at read time", nghĩa là với tài khoản như Taylor Swift thì thôi fan-out và gộp timeline của họ lúc đọc. Nguồn nêu đây là hướng sắp tới, chưa phải kiến trúc đang chạy.
Đặt cạnh bảng của bạn: tỉ lệ đọc/ghi và mục tiêu 5 giây cùng bậc với ràng buộc bạn tự đặt, timeline giữ 800 mục so với 500 của bạn, và hướng tách tài khoản lớn cũng được nhắc tới. Đây là thiết kế của bạn, đã chạy ngoài đời, với hai chỗ bạn có thể chưa có. Một là giới hạn "chỉ fan-out cho người hoạt động", để khỏi tốn ghi cho timeline không ai mở. Hai là bản tóm tắt nói chính Twitter lúc đó đang chuyển từ "làm hết khi ghi" sang "làm nhiều hơn khi đọc cho tài khoản giá trị cao", tức ngưỡng của họ không đứng yên. Bản tóm tắt không công bố ngưỡng cụ thể, nên bài này cũng không in số nào cho ngưỡng.
Twitter 2023: gộp, chấm điểm, xếp hạng lúc đọc
Mã nguồn thuật toán mà Twitter công bố trên GitHub (2023) mô tả Home Mixer là "service chính dùng để dựng và phục vụ Home Timeline". Trang liệt kê nhiều nguồn ứng viên; trong đó nguồn in-network (bài từ tài khoản bạn theo dõi) cung cấp khoảng 50% bài, theo chính trang đó, và có một heavy ranker là mạng nơ-ron để xếp hạng ứng viên. Đừng đọc thành "Twitter bỏ fan-out": trang này mô tả dựng feed "Dành cho bạn", không nói gì về việc cụm Redis 2012 còn hay không.
Ràng buộc khác bạn: feed không còn là danh sách theo thời gian. Khi thứ tự do mô hình chấm điểm, bạn không thể dựng sẵn thứ tự cuối cùng lúc ghi vì điểm phụ thuộc người đọc và thời điểm đọc. Thứ duy nhất dựng sẵn được là tập ứng viên, và phần còn lại phải làm lúc đọc. Với bảng của bạn, feed xếp theo thời gian nên timeline dựng sẵn vẫn đúng; nếu sản phẩm của bạn đổi sang xếp hạng, quyết định ở bài 03 cần tính lại.
3. Facebook 2021: xếp hạng ứng viên lúc đọc
Nếu mỗi người có hơn 1.000 bài ứng viên cần chấm điểm mỗi ngày, fan-out lúc ghi còn lợi không?
Bài How machine learning powers Facebook's News Feed ranking algorithm (Lada, Wang, Yan; 26/1/2021) nói hệ thống phải chấm điểm hơn 1.000 bài mỗi người mỗi ngày, tính trung bình. Đây là số bài ứng viên được chấm điểm cho mỗi người, không phải số bài đăng. Kiến trúc trong bài: lớp Web/PHP gọi một feed aggregator; aggregator lấy hành động và đối tượng từ các feed leaf database rồi xếp hạng, và bài nói rõ việc này phải làm theo thời gian thực. Nói cách khác, bước quyết định thứ tự là gộp lúc đọc.
Bài TAO: Facebook's Distributed Data Store for the Social Graph (USENIX ATC 2013) mô tả kho lưu đồ thị xã hội của Facebook, không phải News Feed. Trong mẫu của họ 99,8% request là đọc, và họ chọn kéo đồ thị lúc xem: "As much as possible we pull the social graph, rather than pushing it" (§2). Hiểu là việc lọc, tổng hợp và kiểm tra quyền riêng tư làm lúc nội dung được xem. Bài này không dùng nó để kết luận News Feed là pull.
Ràng buộc khác bạn: bảng của bạn có một loại bài và một thứ tự (thời gian). Facebook có nhiều loại nội dung và xếp hạng theo ứng viên, nên nhiều việc buộc phải làm lúc xem. Nguồn không cho phép kết luận "Facebook không bao giờ fan-out"; nó chỉ nói tầng xếp hạng của họ chạy lúc đọc.
4. Vì sao ZingMe (VNG) vẫn dùng push?
Một đội ở Việt Nam khoảng 2012 có ba phương án: push, pull, hoặc trộn. Họ chọn gì, và lý do kỹ thuật hay lý do khác?
Nguồn là bộ slide Building ZingMe News Feed System (Chau Nguyen Nhat Thanh, VNG). Trang không ghi ngày; tên tệp ảnh có "hanoiphp2012", nên bài này ghi là khoảng 2012. Đây là tài liệu của chính một người làm ở VNG, nhưng là slide thuyết trình, không phải bài kỹ thuật đầy đủ.
Bộ slide liệt kê ba phương án: push (fan-out lúc ghi), pull (fan-out lúc đọc) và trộn. Phương án trộn (push cho người hoạt động, pull cho người không hoạt động) chỉ là đề xuất; hệ thống thật vẫn dùng push. Slide nói thẳng lý do: "Still using push model because of Twitter public some info related to this model" và "Not enough technical when choosing pull model". Tức họ nghiêng về push vì Twitter đã công khai tài liệu về mô hình đó, và vì đội chưa đủ năng lực kỹ thuật để chọn pull. Slide cũng cho số vận hành: khoảng 80 triệu tài khoản đăng ký, khoảng 3 triệu người hoạt động mỗi ngày, khoảng 15 triệu "action" mỗi ngày (không phải số bài đăng), cache hit 98%, tối đa 1.000 bạn bè, người theo dõi không giới hạn.
Có hai chỗ nên để ý. Thứ nhất, "tối đa 1.000 bạn bè" là ràng buộc sản phẩm chặn trần fan-out ở phía bạn bè; còn "người theo dõi không giới hạn" thì để mở đúng chỗ gây chi phí, nên bài toán tài khoản lớn ở bài 04 vẫn hiện diện. So với bảng của bạn (trần 5.000 tài khoản đang theo dõi, lớn nhất 5 triệu người theo dõi), họ đặt trần sản phẩm thấp hơn nhiều. Thứ hai, và quan trọng hơn: lựa chọn của họ phản ánh tài liệu có sẵn và năng lực đội. Bảng ràng buộc của bạn không có dòng nào cho điều đó, nhưng một tech lead thật phải có dòng đó. Nếu đội chỉ vận hành được một loại hệ thống, thiết kế "tối ưu trên giấy" mà không ai vận hành nổi là thiết kế sai.
Về nền tảng Việt Nam đang chạy hôm nay: bài này không tìm được writeup kỹ thuật công khai của Zalo hay của mạng xã hội Việt Nam nào, nên không suy đoán kiến trúc nội bộ của họ. Với LinkedIn, tác giả cũng không mở được trang bài FollowFeed (2016) khi kiểm chứng, nên bài không dùng số nào từ nguồn đó và không kết luận gì về mô hình của họ.
5. Bảng tổng hợp: ràng buộc nào đổi lựa chọn nào
| Hệ | Năm, nguồn | Lựa chọn | Ràng buộc khiến họ chọn | Khác thiết kế của bạn ở đâu |
|---|---|---|---|---|
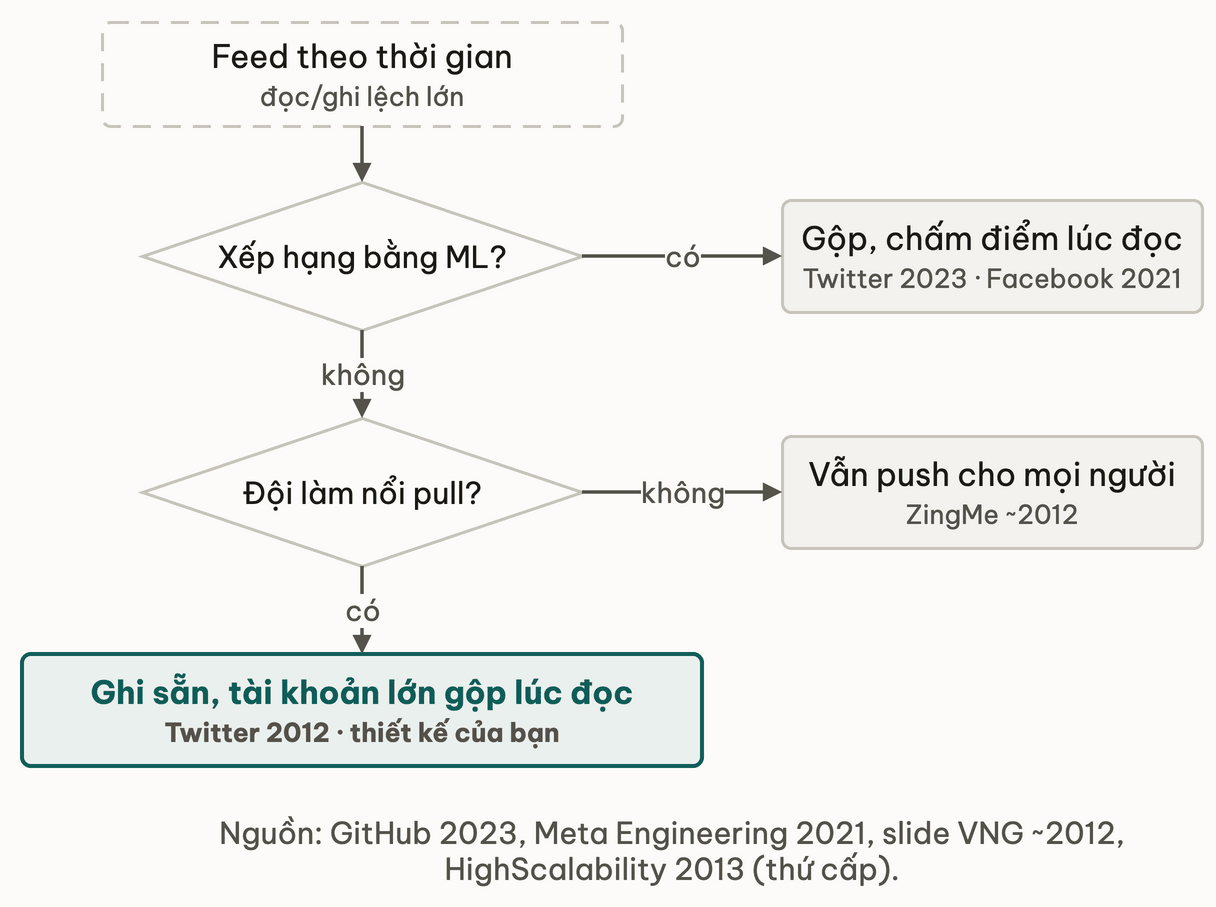
| Twitter (timeline) | 2012, HighScalability 2013 (thứ cấp) | Fan-out lúc ghi, tài khoản lớn gộp lúc đọc, timeline tối đa 800 mục | Đọc/ghi cỡ 50:1, giao tin trong 5 giây | Gần như trùng; thêm chỉ fan-out cho người hoạt động |
| Twitter (Home Mixer) | 2023, GitHub | Dựng ứng viên rồi xếp hạng bằng mạng nơ-ron lúc đọc | Xếp hạng ML, ~50% bài từ một nguồn ứng viên | Thứ tự không còn là thời gian nên không dựng sẵn thứ tự cuối |
| Facebook (xếp hạng) | 2021, Meta Engineering | Feed aggregator gộp và chấm điểm lúc đọc, thời gian thực | Hơn 1.000 bài ứng viên mỗi người mỗi ngày | Chấm điểm ứng viên thay vì cắt theo thời gian |
| Facebook (TAO) | 2013, USENIX ATC | Kho đồ thị, pull thay vì push | 99,8% request là đọc, kiểm tra quyền lúc xem | Là kho đồ thị, không phải pipeline feed |
| ZingMe (VNG) | khoảng 2012, slide | Push (đề xuất mix: push cho người hoạt động, pull cho người không hoạt động) | Tài liệu Twitter có sẵn, đội chưa đủ năng lực làm pull | Thêm ràng buộc đội ngũ; trần 1.000 bạn bè |
Đọc dọc cột ràng buộc: không dòng nào nói push tốt hơn pull, dòng nào cũng nói chỗ trả giá nằm ở đâu với ràng buộc đó. Bài 03 đo ba thứ trên máy bạn; bảng này cho thấy khi thêm một ràng buộc mới (ML, quyền riêng tư, đội ngũ), chính các con số đó đổi.
6. Tự kiểm tra
- Q1Twitter 2012 (theo bản tóm tắt talk trên HighScalability 2013) fan-out lúc ghi, còn Twitter 2023 dựng Home Timeline bằng gộp và xếp hạng lúc đọc. Hai lựa chọn khác nhau đó khác ở ràng buộc nào?
- Q2Bảng của bạn thêm ràng buộc quyền riêng tư: mỗi bài chỉ một số người xem được. Quyết định nào ở bài 03 và bài 05 phải đổi, và bạn trả giá gì?
- Q3Twitter 2012 đặt mục tiêu 5 giây nhưng nguồn ghi p99 có thể tới 5 phút. Nếu bảng của bạn siết mục tiêu xuống 1 giây, phần nào của thiết kế bài 04 và bài 05 gãy trước, và bạn chỉnh gì?
- Q4ZingMe khoảng 2012 vẫn dùng push. Slide nêu hai lý do; lý do nào không nằm trong bảng ràng buộc của bạn, và bạn có nên thêm nó vào bảng không?
- Q5Dòng 'Max 1000 friends only, Unlimited followers' trên slide ZingMe gợi bạn điều gì về bài toán tài khoản lớn ở bài 04?
- Q6Bảng của bạn đổi sang feed xếp hạng bằng mô hình thay vì theo thời gian. Quyết định nào ở bài 03 và bài 04 phải tính lại, và vì sao?
Tóm tắt
- Hệ thật chọn khác bạn vì ràng buộc khác: xếp hạng ML (Twitter 2023, Facebook 2021), kho đồ thị đọc áp đảo (TAO 2013), năng lực và tài liệu có sẵn của đội (ZingMe khoảng 2012).
- Twitter 2012 theo bản tóm tắt thứ cấp gần với thiết kế của bạn nhất: fan-out lúc ghi, tài khoản lớn gộp lúc đọc, giao tin trong 5 giây.
- Giữ đúng phạm vi nguồn: 1.000 là số ứng viên chấm điểm, TAO là kho đồ thị, và không có nguồn công khai nào về nền tảng Việt Nam đang chạy.
Liên hệ các bài khác
- 02 — Gộp feed lúc đọc: phương án ngây thơ mà không hệ nào ở trên dùng nguyên dạng.
- 03 — Trả giá lúc ghi hay lúc đọc: quyết định lõi mà bảng ở mục 5 đặt lại dưới ràng buộc khác.
- 04 — Tài khoản triệu người theo dõi: ngưỡng mà Twitter 2012 và ZingMe đều có dạng riêng.
- 05 — Fan-out trễ: độ trễ fan-out mà Twitter 2012 chấp nhận (mục tiêu 5 giây, p99 có thể tới 5 phút).
Bài tiếp theo tổng kết lại cả module: Tổng kết module.
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Fan-out chạy trễ: người đăng, người theo dõi và bài đã xoá thấy gì?
Bài tiếpTổng kết case news feed: thiết kế hoàn chỉnh và các cái giá
Thảo luận & góp ý
Hỏi đáp về bài này