Tài khoản triệu người theo dõi: fan-out cho ai, gộp lúc đọc cho ai?
Một bài của tài khoản 5 triệu người theo dõi nở thành 5 triệu lần ghi. Chọn ngưỡng tách tài khoản lớn khỏi fan-out lúc ghi, và trả giá gì ở lúc đọc cho phần gộp thêm.
TL;DR: Bài 03 đã chọn fan-out lúc ghi làm mặc định. Nhưng một bài của tài khoản 5 triệu người theo dõi nở thành 5 triệu hàng timeline, khoảng 45 giây trên một worker, trong khi mục tiêu là 5 giây. Giải pháp là hybrid: đặt một ngưỡng T, tài khoản có từ T người theo dõi trở lên không fan-out, bài của họ được gộp vào feed lúc đọc. Bạn chọn T trước, rồi đối chiếu số đo: T cắt bao nhiêu hàng ghi, và lúc đọc trả thêm bao nhiêu.
Bài 03 chốt: người đọc nhiều gấp 50 lần người ghi, nên bạn trả giá lúc ghi để feed đọc nhanh. Với tài khoản lớn nhất thì sao? Tải đỉnh vẫn là 70 bài/giây, nhưng chỉ cần một trong số đó thuộc tài khoản 5 triệu người theo dõi là một bài phải ghi 5 triệu hàng, mất khoảng 45 giây trên một worker. Bài này hỏi: từ bao nhiêu người theo dõi trở lên thì thôi fan-out?
1. Ràng buộc: một bài của tài khoản lớn nhất là 5 triệu hàng
Bảng ràng buộc chuẩn của module (bài 01), phần liên quan đến bài này:
| Ràng buộc | Giá trị |
|---|---|
| Người theo dõi một tài khoản | trung vị 150, trung bình 400 (đuôi dài), lớn nhất 5 triệu |
| Độ tươi | bài mới tới feed người theo dõi trong 5 giây (mục tiêu) |
| Số đo lab | khoảng 110.000 hàng/giây trên một worker (95.000 hàng mất khoảng 0,86 giây) |
Phép tính cần nhớ: 5.000.000 hàng chia 110.000 hàng/giây là khoảng 45 giây trên một worker, gấp 9 lần mục tiêu 5 giây.
Fan-out lúc ghi đổi chi phí đọc lấy chi phí ghi, kèm 115 byte mỗi hàng timeline. Bài này giữ lựa chọn đó cho đa số tài khoản.
2. Chọn ngưỡng T trước khi tính
Trần của T đến từ ràng buộc: một worker ghi khoảng 110.000 hàng/giây, mục tiêu 5 giây, nên một worker fan-out nổi tối đa khoảng 550.000 người theo dõi cho một bài. Tài khoản lớn hơn mức đó thì một worker không giữ nổi 5 giây. Ba ngưỡng dưới đây nằm hết dưới trần, nên thứ phân biệt chúng là số tài khoản bị tách, thời gian một bài ngay dưới ngưỡng, và độ phức tạp của nhánh đọc. Số đo lấy từ dữ liệu thu nhỏ (người theo dõi nhiều nhất 95.131), nên cost của T = 100.000 là suy luận, không phải số đo.
Ràng buộc: Bài 03 đã chọn fan-out lúc ghi · người theo dõi trung vị 150, lớn nhất 5 triệu · một bài của tài khoản 5 triệu ≈ 45 giây trên một worker, mục tiêu 5 giây · feed 50 bài, p99 dưới 200 ms
Bạn đặt T ở đâu để một bài không vượt 5 giây fan-out trên một worker, mà người đọc không phải gộp quá nhiều tài khoản lúc mở feed?
Chọn trước khi đọc tiếp — phần sau phân tích từng cái giá.
3. Phân bố lệch: cắt đúng nhóm nhỏ thì tiết kiệm bao nhiêu?
Số người theo dõi không phân bố quanh một "trung bình". Đo bằng percentile_cont và count(*) FILTER (WHERE follower_count >= T) trên cột users.follower_count (duy trì sẵn, xem mục 6), trên Apple M4, Postgres 16 trong Docker:
| Chỉ số | Giá trị |
|---|---|
| Người theo dõi mỗi tài khoản: trung vị / p99 / lớn nhất | 9 / 432 / 95.131 |
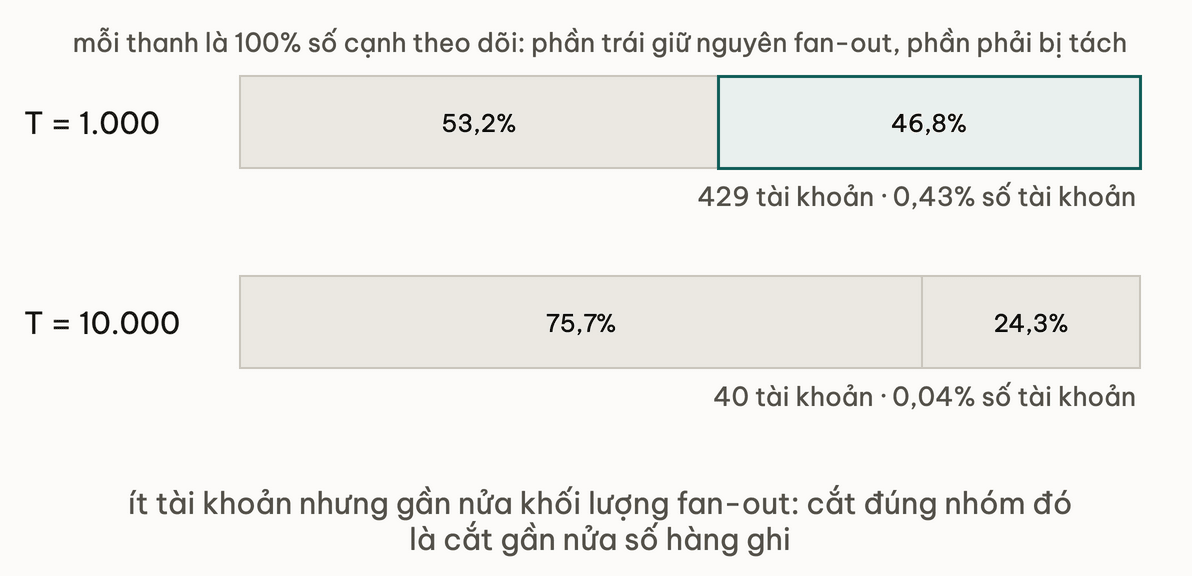
| Tài khoản có từ 1.000 người theo dõi | 429 (0,43%) |
| Tài khoản có từ 10.000 người theo dõi | 40 (0,04%) |
| Cạnh follow trỏ vào nhóm từ 1.000 | 2.083.621 trên 4.447.911 (46,8%) |
| Cạnh follow trỏ vào nhóm từ 10.000 | 1.082.285 (24,3%) |
Hàng fan-out tiết kiệm được khi tác giả có từ T người theo dõi trở lên không fan-out, tính trên toàn bộ 2 triệu bài:
| T | Hàng fan-out đầy đủ | Hàng fan-out hybrid | Tiết kiệm |
|---|---|---|---|
| 1.000 | 89.625.505 | 47.324.810 | 47,2% |
| 10.000 | 89.625.505 | 67.389.963 | 24,8% |
Ở dữ liệu này tác giả đăng đều nhau, nên tiết kiệm chỉ bằng đúng phần cạnh trỏ vào nhóm lớn (47,2% và 24,8%). Ngoài đời tài khoản lớn đăng nhiều hơn. Khi cho tác giả đăng theo cùng phân bố đuôi dài, tiết kiệm lên 99,5% ở T = 1.000 và 95,0% ở T = 10.000. Hai số này mới là phần gần thực tế, còn 47% và 25% là cận dưới.
Hạ T từ 10.000 xuống 1.000 làm nhóm bị tách đông gấp 10,7 lần (40 lên 429) nhưng chỉ cắt thêm 22,4 điểm phần trăm hàng ghi (24,8% lên 47,2%, gần gấp đôi): phần tiết kiệm dày nhất nằm ở 40 tài khoản lớn nhất.
4. Gộp lúc đọc trả giá bao nhiêu?
Tài khoản lớn không fan-out thì bài của họ không có trong timeline. Muốn người theo dõi vẫn thấy, lúc mở feed bạn đọc timeline rồi gộp thêm bài mới nhất của các tài khoản lớn mà người đó theo dõi:
-- hybrid_1000.sql: T = 1000 (T = 10000 thi doi 1000 thanh 10000)
SELECT id, author_id, created_at FROM (
  (SELECT p.id, p.author_id, p.created_at
     FROM timeline t JOIN posts p ON p.id = t.post_id
    WHERE t.user_id = :r AND p.deleted_at IS NULL
    ORDER BY t.created_at DESC LIMIT 50)
  UNION ALL
  (SELECT p.id, p.author_id, p.created_at
     FROM follows f JOIN users u ON u.id = f.followee_id AND u.follower_count >= 1000
     CROSS JOIN LATERAL (SELECT id, author_id, created_at FROM posts
                          WHERE author_id = f.followee_id AND deleted_at IS NULL
                          ORDER BY created_at DESC LIMIT 50) p
    WHERE f.follower_id = :r)
) x ORDER BY created_at DESC LIMIT 50;
Nhánh đầu là đọc timeline như ở bài 03. Nhánh sau là truy vấn phụ: lấy các tài khoản người đọc theo dõi, giữ những tài khoản từ T trở lên, rồi lấy bài mới nhất của từng tài khoản. Hai nhánh đều lọc deleted_at IS NULL (bài 05 giải thích); bảng số đo chạy bản chưa có hai điều kiện lọc đó, bài 07 đo lại bản đầy đủ. Đo trên cùng máy, với người đọc giả theo dõi 50 tài khoản thường cộng 0, 5 hoặc 20 tài khoản lớn (dựng tay để thấy từng bậc chi phí; người đọc điển hình nằm quanh cột 20 ở T=1.000 (trung vị 21 tài khoản lớn mỗi người) và giữa cột 5 và 20 ở T=10.000 (trung vị 11), không ai ở cột 0). Cột cuối là so với chỉ đọc timeline, cùng người đọc:
| Số tài khoản lớn người đọc theo dõi | p50 một kết nối (T=1.000 / T=10.000) | p99 20 kết nối (T=1.000 / T=10.000) | So với chỉ đọc timeline |
|---|---|---|---|
| 0 | 0,225 / 0,227 ms | 4,04 / 4,03 ms | 2,3 lần |
| 5 | 0,264 / 0,271 ms | 4,60 / 4,80 ms | 2,7 lần |
| 20 | 0,411 / 0,400 ms | 7,20 / 7,29 ms | 4,1 đến 4,2 lần |
| chỉ đọc timeline | 0,097 / 0,098 ms | 1,84 / 1,82 ms | 1 lần |
Baseline 0,097 ms là người theo dõi 50 tài khoản; người theo dõi 500 và 2.000 tài khoản có baseline 0,12 và 0,15 ms (bài 03), nên so tỉ lệ chỉ đúng khi cùng người đọc.
Vì sao 2,3 lần khi không có tài khoản lớn nào? Truy vấn phụ chạy cho mọi người đọc: nó vẫn duyệt follows của người đó, nối từng dòng sang users để đọc follower_count, ghép hai nhánh bằng UNION ALL rồi sắp xếp lại. Đó là phí cố định, khoảng 0,13 ms mỗi lần mở feed. Cách bỏ (chưa đo): lưu sẵn cờ has_big_followee hoặc danh sách tài khoản lớn mỗi người theo dõi.
Vì sao không phụ thuộc T? Chi phí nhánh phụ là phí cố định cộng khoảng 9 µs mỗi tài khoản lớn ((0,411 trừ 0,225) chia 20), công thức không chứa T. T chỉ tác động gián tiếp: T thấp thì nhiều tài khoản được gọi là "lớn", nên người đọc điển hình theo dõi nhiều hơn (khoảng 21 ở T=1.000, khoảng 11 ở T=10.000 trên dữ liệu lab).
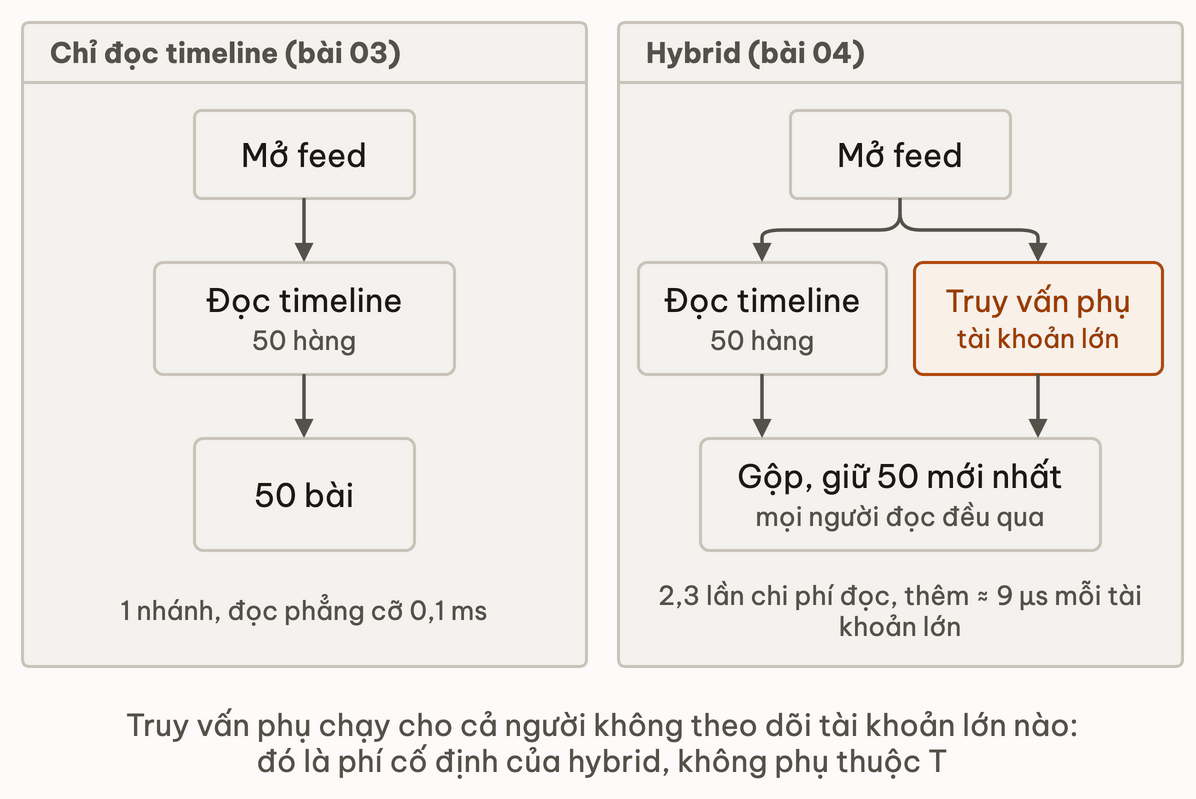
Đặt vào ràng buộc: 20 tài khoản lớn tốn khoảng 0,41 ms và p99 7,2 ms, còn xa mục tiêu 200 ms. Hybrid không thắng ngây thơ ở người đọc nhỏ (ngây thơ với 50 tài khoản theo dõi chỉ 0,26 ms, bài 02); nó trả thêm phí đọc để khỏi ghi 5 triệu hàng cho một bài. Phần đọc dễ trả; phần đắt là độ phức tạp, vì mọi đường đọc giờ có hai nhánh và danh sách tài khoản lớn phải luôn đúng.
5. Hậu tố ngẫu nhiên có cứu được fan-out của tài khoản lớn không?
Tài khoản triệu người theo dõi trông như một khoá nóng, nên hậu tố ngẫu nhiên của bài khoá nền có vẻ chữa được. Nhưng ở fan-out, 5 triệu hàng timeline thuộc 5 triệu khoá khác nhau nên đã rải sẵn, và chẳng khoá nào nóng. Thứ nóng là tổng khối lượng ghi của một bài: 5 triệu hàng, 45 giây trên một worker. Hậu tố không giảm con số đó. Thêm worker kéo độ trễ xuống nhưng lợi giảm dần (bài 05: 8 worker chỉ nhanh 3,5 lần), còn gộp lúc đọc thì một bài chỉ ghi một hàng vào posts.
Hash chia đều giữa các khoá khác nhau nhưng không chia nhỏ được một khoá. Thêm hậu tố ngẫu nhiên vào khoá nóng để rải ra N partition, đổi lại đọc phải gộp N mảnh.
6. Ghép lại: chọn T theo cái gì đang tắc
Câu cần hỏi là fan-out chạy nền đang quá tải vì ai (worker dựng ở bài 05), và người đọc chịu được thêm bao nhiêu.
| Tình huống | Hướng chọn |
|---|---|
| Fan-out nghẽn vì vài tài khoản cực lớn | T cao (cỡ B): ít tài khoản bị tách, người đọc điển hình gộp khoảng 11 tài khoản lớn thay vì 21 |
| Dung lượng timeline hoặc tải ghi đỉnh là nút cổ chai, tài khoản lớn đăng nhiều | T thấp hơn (cỡ A): cắt tới nửa hàng ghi, chấp nhận mỗi người đọc gộp thêm vài tài khoản |
❌ Đếm SELECT count(*) FROM follows WHERE followee_id = :a mỗi lần có bài mới. ✅ Giữ cột users.follower_count, cập nhật trong cùng transaction với việc theo dõi:
BEGIN;
INSERT INTO follows(follower_id, followee_id) VALUES (:me, :a);
UPDATE users SET follower_count = follower_count + 1 WHERE id = :a;
COMMIT;
Cái giá: với tài khoản triệu người theo dõi, hàng đó là một khoá nóng. Cách chữa là cập nhật theo lô và chấp nhận lệch vài giây, vì T chỉ là ngưỡng xấp xỉ.
Bài cũ đã nằm trong timeline, bài mới gộp lúc đọc, nên truy vấn phụ phải bỏ trùng theo post_id hoặc chỉ lấy bài sau thời điểm bị tách.
Đào sâu
- PostgreSQL 16: SELECT, mục LATERAL: cú pháp
CROSS JOIN LATERALdùng ở truy vấn phụ mục 4.
Liên hệ các bài khác
- Bài 01: ràng buộc và ước lượng: bảng ràng buộc và phân bố người theo dõi.
- Bài 03: trả giá lúc ghi hay lúc đọc: lý do fan-out lúc ghi là mặc định mà bài này sửa ở nhóm tài khoản lớn nhất.
- Bài 05: fan-out trễ, người dùng thấy gì: hàng đợi fan-out mà các tài khoản dưới ngưỡng vẫn đi qua; tài khoản từ T trở lên không vào.
Tóm tắt
- Một bài của tài khoản 5 triệu người theo dõi là khoảng 45 giây fan-out trên một worker, gấp 9 lần mục tiêu 5 giây.
- Hậu tố ngẫu nhiên giải khoá nóng ở tầng lưu trữ, không giải được khối lượng fan-out vì cái nóng là tổng số hàng của một bài, không phải một khoá.
7. Tự kiểm tra
- Q1Tình huống mới (số giả định để bạn tự quyết): một mạng chuyên môn có 2 triệu người dùng. Đo được: 2% tài khoản có từ 500 người theo dõi và giữ 70% số cạnh follow; 0,1% tài khoản có từ 5.000 người theo dõi và giữ 30% số cạnh; mỗi người theo dõi trung bình 300 tài khoản. Fan-out chạy nền đang quá tải vào giờ cao điểm. Bạn đặt T ở đâu, và đọc thêm tốn bao nhiêu? Tự quyết trước khi mở đáp án.
- Q2Vì sao người đọc không theo dõi tài khoản lớn nào vẫn tốn gấp 2,3 lần so với chỉ đọc timeline? Nêu một cách giảm phí này và cái giá của nó.
- Q3Một worker ghi khoảng 110.000 hàng/giây, mục tiêu 5 giây. Từ ràng buộc đó, T tối đa là bao nhiêu để một worker còn fan-out kịp, và vì sao bạn vẫn chọn T thấp hơn nhiều?
- Q4Tác giả đăng đều thì T = 10.000 tiết kiệm 25% hàng ghi, tài khoản lớn đăng nhiều thì 95%. Điều đó đổi cách bạn chọn giữa T = 1.000 và 10.000 thế nào?
- Q5Vì sao quyết định fan-out hay không nên dựa vào cột follower_count duy trì sẵn thay vì COUNT mỗi lần, và cột đó thành vấn đề ở tài khoản nào?
Bài tiếp theo: Fan-out trễ, người dùng thấy gì
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Trả giá lúc ghi hay lúc đọc: dựng sẵn timeline hay gộp khi mở
Bài tiếpFan-out chạy trễ: người đăng, người theo dõi và bài đã xoá thấy gì?
Thảo luận & góp ý
Hỏi đáp về bài này