Mini-challenge — Implement LRU Cache thủ công không dùng LinkedHashMap
Implement LRU Cache đạt O(1) cho cả get và put bằng cách kết hợp HashMap và DoublyLinkedList từ đầu, mẫu thiết kế nền của nhiều cache thật như Caffeine.
Cache bị giới hạn bởi bộ nhớ: máy chủ chỉ giữ được N entry trong RAM. Khi cache đầy mà cần thêm entry mới, phải chọn một entry để đẩy ra. Least Recently Used (LRU) chọn entry lâu nhất chưa được truy cập, với giả định rằng nếu bạn đã lâu không dùng đến nó thì lúc này cũng ít có khả năng cần nó.
LeetCode 146 yêu cầu get và put đều O(1). Bạn có thể dùng LinkedHashMap với accessOrder=true, nhưng bài này yêu cầu tự cài từ đầu để hiểu vì sao phải ghép HashMap với DoublyLinkedList, và vì sao không cấu trúc dữ liệu nào khác đáp ứng được cả hai ràng buộc cùng lúc.
Sau bài này bạn tự cài được LRU. Caffeine, Memcached và Linux page cache đều là họ hàng của mẫu này (Redis dùng bản xấp xỉ lấy mẫu), thêm metric, TTL và chính sách đẩy entry ra (evict policy) lên trên.
🎯 Yêu cầu bài toán
Viết LRUCache(K, V) với API sau:
- Constructor:
LRUCache(capacity)— tạo cache với dung lượng tối đa. get(key)— trả về value nếu key có trong cache, NIL nếu miss. Khi hit, đánh dấu key là vừa được dùng (đưa lên vị trí MRU, Most Recently Used, tức vừa dùng gần nhất, đối lập với LRU ở đầu kia).put(key, value)— thêm mới hoặc cập nhật. Nếu key đã có, cập nhật value và đưa lên MRU. Nếu cache đầy khi thêm key mới, đẩy entry LRU ra trước.
Yêu cầu Big-O:
| Operation | Complexity |
|---|---|
get(key) | O(1) average |
put(key, value) | O(1) average |
Ràng buộc:
- Không dùng
LinkedHashMaphay bất kỳ linked map có sẵn nào. - Tự cài
DoublyLinkedListvàNode.
Hãy dành 20–25 phút tự làm trước khi xem gợi ý. Mẹo: lấy giấy bút vẽ tay bài toán với 2 đến 3 entry trước khi viết code (xem Làm tay trước khi làm máy), và nếu chưa quen việc tách bài toán thành các phần nhỏ thì xem Phân rã: LRU tách tự nhiên thành "tra theo key" và "giữ thứ tự dùng".
🧪 Test cases (pseudocode)
c <- LRUCache(capacity=2)
c.put(1, 100)
c.put(2, 200)
-- Trạng thái: LRU -> [1, 2] <- MRU

c.get(1)   -- hit, key 1 promote lên MRU, trả 100
-- Trạng thái: LRU -> [2, 1] <- MRU

c.put(3, 300)   -- đầy, evict LRU = key 2
-- Trạng thái: LRU -> [1, 3] <- MRU

c.get(2)   -- miss, đã evict, trả NIL
c.get(1)   -- hit, trả 100
c.get(3)   -- hit, trả 300

c.put(4, 400)   -- trước put: LRU -> [1, 3] <- MRU (get(3) vừa promote 3)
                -- evict LRU = key 1
-- Trạng thái: LRU -> [3, 4] <- MRU

c.get(1)   -- miss, đã evict, trả NIL
c.get(3)   -- hit, trả 300
c.get(4)   -- hit, trả 400
Bonus, thử tải nặng: capacity = 1000, 100k lệnh get/put ngẫu nhiên xen kẽ. Kiểm tra rằng cache không bao giờ vượt capacity, và tỉ lệ hit với kiểu truy cập Zipfian (vài key được dùng rất nhiều) cao hơn đáng kể so với việc đẩy entry ngẫu nhiên.
💡 Gợi ý
get(key) phải là O(1). Cấu trúc dữ liệu nào tra theo key trong O(1)?
Map(K -> ?) tra theo key là O(1) trung bình. Vậy value của Map nên lưu gì? Đó là câu hỏi của Stage 2.
Thử trước với Map(K -> V) thuần: get ổn, nhưng làm sao biết entry nào là LRU? Map không có khái niệm thứ tự truy cập, nên cần thêm một cấu trúc để theo dõi thứ tự.
Cần "chuyển một entry lên vị trí most-recently-used" với chi phí O(1).
Các ứng viên:
- List cài bằng array: xoá ở giữa là
O(n)vì phải dời phần tử. Không đạt. - DoublyLinkedList: nếu bạn đang giữ sẵn pointer trỏ thẳng tới node, xoá node đó là
O(1)(chỉ sửa prev/next). Chèn node vào cuối cũngO(1).
Bài 02 đã phân tích đúng điểm này: xoá ở giữa là O(1) khi có sẵn node ref, và O(n) nếu chỉ có index.
DoublyLinkedList giữ thứ tự từ LRU (head) đến MRU (tail). Nhưng để "đi thẳng đến một node cụ thể" khi biết key, bạn cần Map trỏ thẳng đến node, không phải trỏ đến value.
Thiết kế: Map(K -> Node) + DoublyLinkedList.
- Value của Map là pointer thẳng đến node trong linked list, không phải bản sao của value.
- Linked list giữ thứ tự:
head.next= LRU,tail.prev= MRU. - Dùng sentinel head và tail (node giả, không chứa dữ liệu) để khỏi phải kiểm tra null khi xoá/chèn ở hai biên.
Map: {1: nodeA, 2: nodeB, 3: nodeC}

DoublyLinkedList (HEAD=LRU sentinel, TAIL=MRU sentinel):
  [HEAD] <-> nodeA(1,v1) <-> nodeB(2,v2) <-> nodeC(3,v3) <-> [TAIL]

get(2):
  1. Map.get(2) -> nodeB                    (O(1))
  2. removeNode(nodeB): nodeA.next=nodeC,   (O(1))
                        nodeC.prev=nodeA
  3. addBeforeTail(nodeB): chèn trước       (O(1))
                            TAIL sentinel
  Kết quả: HEAD <-> nodeA <-> nodeC <-> nodeB <-> TAIL
Cần viết thêm ba hàm phụ: removeNode(node), addBeforeTail(node), moveToTail(node) = remove + addBeforeTail.
🗺️ Sơ đồ cấu trúc
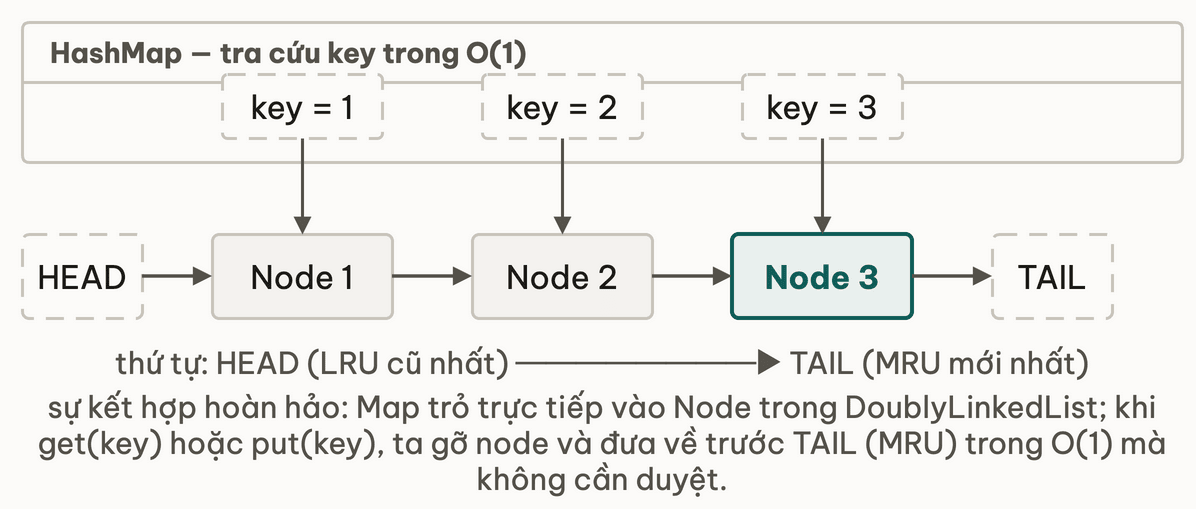
Map trỏ thẳng đến node trong DoublyLinkedList, và đó là chìa khoá để đưa entry lên MRU trong O(1). HEAD.next = LRU (cũ nhất), TAIL.prev = MRU (mới nhất).
✅ Lời giải
-- Node của DoublyLinkedList
Node:
    key
    value
    prev <- NIL
    next <- NIL

-- LRUCache
LRUCache(capacity):
    this.capacity <- capacity
    this.map      <- Map rỗng      -- Map(key -> Node)
    this.head     <- Node(NIL, NIL)  -- sentinel phía LRU
    this.tail     <- Node(NIL, NIL)  -- sentinel phía MRU
    head.next <- tail
    tail.prev <- head

get(key):
    node <- map.get(key)
    if node = NIL: return NIL     -- cache miss
    moveToTail(node)              -- đưa lên MRU
    return node.value

put(key, value):
    node <- map.get(key)
    if node != NIL:
        -- Key đã có: cập nhật value và đưa lên MRU
        node.value <- value
        moveToTail(node)
        return
    -- Đầy thì đẩy LRU ra
    if map.size() = capacity:
        lru <- head.next          -- LRU là ngay sau sentinel head
        removeNode(lru)
        map.remove(lru.key)
    -- Thêm entry mới vào vị trí MRU
    fresh <- Node(key, value)
    addBeforeTail(fresh)
    map.put(key, fresh)

-- Xoá node khỏi vị trí hiện tại trong linked list
removeNode(node):
    node.prev.next <- node.next
    node.next.prev <- node.prev

-- Chèn node ngay trước sentinel tail (= vị trí MRU)
addBeforeTail(node):
    node.prev      <- tail.prev
    node.next      <- tail
    tail.prev.next <- node
    tail.prev      <- node

-- Di chuyển node lên vị trí MRU
moveToTail(node):
    removeNode(node)
    addBeforeTail(node)
Time: O(1) cho get và put Space: O(N) tổng
Những lựa chọn thiết kế đáng chú ý:
- Sentinel head/tail: khỏi phải kiểm tra null trong
removeNodevàaddBeforeTail. Khi list rỗng, head và tail trỏ thẳng vào nhau, không có null pointer nào. - Node lưu cả key: khi đẩy LRU ra cần
lru.keyđể gọimap.remove(lru.key). Nếu node chỉ lưu value thì không xoá đúng entry khỏi Map được. - Chỉ định kích thước ban đầu cho Map: trong Java, tạo HashMap với
capacity * 4 / 3 + 1đảm bảo nó không phải nở thêm chỗ cho đến khi vượt capacity. Load factor mặc định là 0.75.
Trace ví dụ — put(1,A); put(2,B); get(1); put(3,C);:
| Operation | Map | DoublyLinkedList (LRU → MRU) |
|---|---|---|
put(1, A) | {1: nodeA} | HEAD ↔ nodeA(1,A) ↔ TAIL |
put(2, B) | {1: nodeA, 2: nodeB} | HEAD ↔ nodeA ↔ nodeB(2,B) ↔ TAIL |
get(1) — hit, đưa lên MRU | {1: nodeA, 2: nodeB} | HEAD ↔ nodeB ↔ nodeA(1,A) ↔ TAIL |
put(3, C) — đẩy LRU=2 ra | {1: nodeA, 3: nodeC} | HEAD ↔ nodeA ↔ nodeC(3,C) ↔ TAIL |
Sau get(1), key 1 là MRU nên key 2 trở thành LRU, và bị đẩy ra khi put(3) cần thêm chỗ.
⚠️ Pitfall phổ biến
Pitfall 1 — Không dùng sentinel: lỗi null pointer khi xoá node đầu hoặc cuối.
-- SAI: không có sentinel, removeNode lỗi khi node là phần tử duy nhất
removeNode(node):
    if node.prev != NIL: node.prev.next <- node.next  -- không đủ
    if node.next != NIL: node.next.prev <- node.prev  -- bỏ sót việc cập nhật con trỏ head

-- Khi list có 1 phần tử: node.prev = NIL, node.next = NIL
-- con trỏ head của list vẫn trỏ vào node vừa xoá -- tham chiếu treo (dangling)
Dùng sentinel: removeNode luôn có node.prev và node.next hợp lệ (ít nhất là sentinel), nên khỏi kiểm tra null và không còn edge case.
Pitfall 2 — Quên map.remove(lru.key) khi đẩy entry ra.
-- SAI: xoá node khỏi linked list nhưng để lại entry cũ trong Map
evictLRU():
    lru <- head.next
    removeNode(lru)
    -- map.remove(lru.key)  -- THIẾU dòng này!

-- Hệ quả:
-- map vẫn giữ {lru.key: lru_node} — node không còn trong linked list
-- get(lru.key) sẽ trả value của node đã bị đẩy ra -- logic sai
-- map.size() tăng nhưng linked list không tăng -- kiểm tra capacity bị lệch
-- cache thực tế có thể vượt capacity
Pitfall 3 — get(key) khi miss không nên ném exception.
-- SAI: cache miss là chuyện bình thường, không phải lỗi
get(key):
    node <- map.get(key)
    if node = NIL: throw "NoSuchElementException"  -- anti-pattern

-- ĐÚNG: trả NIL (hoặc Optional.empty())
get(key):
    node <- map.get(key)
    if node = NIL: return NIL
    moveToTail(node)
    return node.value
Cache miss là kết quả bình thường, không phải lỗi. Nếu ném exception, bên gọi phải bắt exception ở mọi lần tra cứu, kể cả lúc mới khởi động khi cache còn rỗng. Trả NIL mới đúng hợp đồng.
📊 Về hiệu năng
Bản tự cài và LinkedHashMap (accessOrder) có throughput cùng bậc vì cùng thuật toán. Caffeine thường cho tỉ lệ hit tốt hơn nhờ chính sách đẩy entry ra tốt hơn (Window TinyLFU, kết hợp ý tưởng LRU và LFU), không phải nhờ code Java viết khéo hơn. Bài học: muốn cache hiệu quả hơn, chọn đúng chính sách thường quan trọng hơn tối ưu vi mô từng dòng code. Muốn con số cụ thể thì tự đo bằng JMH trên dữ liệu thật của bạn.
🔗 Variant để tự thử
Variant 1 — Đẩy entry ra theo thời hạn sống (TTL):
Mỗi node thêm expiryMs. Trong get(key), sau khi hit: kiểm tra currentTime > node.expiryMs; nếu đã hết hạn thì xoá entry đó và trả NIL. put(key, value, ttlMs) tính expiryMs = now + ttlMs.
Câu hỏi: có cần một thread nền quét dọn chủ động không? Khi cache đầy và mọi entry đã hết hạn, head.next là LRU đã hết hạn, đẩy nó ra là đúng. Khi cache chưa đầy mà entry hết hạn nằm đó: chỉ phí chỗ chứ không trả dữ liệu sai. Thread quét nền giúp giải phóng chỗ sớm hơn, nhưng thêm độ phức tạp về đa luồng.
Variant 2 — LRU an toàn giữa các thread:
Cách đơn giản nhất: lock toàn bộ get và put. Đúng, nhưng cả cache phải xếp hàng qua một lock nên thành nút thắt.
Nâng cấp: ReadWriteLock, cho nhiều thread đọc cùng lúc và chỉ khoá ghi khi put/đẩy entry ra. Nhưng get vẫn phải khoá ghi vì nó gọi moveToTail (sửa linked list). Thực ra với LRU, get nào cũng sửa trạng thái nên read/write lock giúp được rất ít.
Trong thực tế: Caffeine dùng buffer bất đồng bộ. get chỉ ghi sự kiện truy cập vào ring buffer, một thread riêng định kỳ lấy buffer ra để cập nhật thứ tự, nên đường chạy chính không bị lock. Caffeine dùng ring buffer (cùng họ với bài 05) để đệm sự kiện truy cập.
Variant 3 — LFU Cache (LeetCode 460):
Least Frequently Used: evict entry bị truy cập ít nhất. Cần thêm bộ đếm cho mỗi entry và Map(tần suất -> tập key). Dùng biến minFreq để nhớ tần suất thấp nhất hiện tại, nhờ đó đẩy entry ra trong O(1). Khó hơn LRU đáng kể.
Thử ngẫmVariant 2 kết luận rằng với LRU, get() nào cũng sửa trạng thái nên ReadWriteLock không giúp nhiều. Với một cache mà đọc cũng là ghi như vậy, bạn sẽ chọn cách khoá nào thay thế?
🔗 LeetCode liên quan
- 146. LRU Cache — bài chính, đúng yêu cầu của bài này.
- 460. LFU Cache — Least Frequently Used, đẩy entry ra theo số lần truy cập.
- 432. All O`one Data Structure — tăng/giảm đếm và lấy key nhỏ nhất/lớn nhất trong O(1), cần DoublyLinkedList của các bucket.
🏭 Applied note
Caffeine (com.github.benmanes.caffeine) — thư viện cache Java dùng trong thực tế. Nó dùng Window TinyLFU thay vì LRU thuần: chia cache thành một window nhỏ (cỡ 1%) và vùng chính, vùng chính lại chia thành probation (cỡ 20%) và protected (cỡ 80%). Entry mới vào window trước, và chỉ được nhận vào vùng chính nếu bộ lọc tần suất cho là đáng. Cách này giảm "ô nhiễm cache" (cache pollution) do các lần quét dữ liệu một lượt.
Linux page cache — kernel dùng "active list" và "inactive list" (biến thể LRU hai danh sách). Entry mới vào inactive list; nếu được truy cập lần thứ hai thì được đưa lên active list. Nhờ vậy việc đọc một file lớn một lần không đẩy hết dữ liệu đang dùng thường xuyên (working set) ra khỏi cache.
Redis maxmemory-policy — cấu hình lúc chạy:
allkeys-lru— đẩy entry LRU ra (xấp xỉ bằng cách lấy mẫu vài key), xét trên toàn bộ keyspace.volatile-lru— đẩy entry LRU ra, chỉ xét trong các key có TTL.allkeys-lfu— đẩy entry LFU ra (Redis 4.0+).noeviction— trả lỗi khi hết bộ nhớ, không đẩy gì ra.
Bài liên quan: bài 02 (Linked List) về DoublyLinkedList và xoá O(1) khi có node ref. Bài 05 về ring buffer mà Caffeine dùng để đệm sự kiện truy cập. HashMap internals về va chạm hash, load factor và việc nở thêm chỗ. Cùng ý tưởng ở track khác — cache nào cũng nhỏ nên phải đẩy entry ra; xem Vì sao có cache.
✨ Điều bạn vừa làm được
- Tự cài LRU Cache đạt O(1) cho
getvàputbằng cách ghép Map (tra O(1)) với DoublyLinkedList (đưa lên MRU trong O(1) khi có node ref). - Hiểu vì sao sentinel head/tail loại bỏ hết các edge case phải kiểm tra null khi thao tác linked list.
- Biết ba cái bẫy phổ biến: không dùng sentinel, quên
map.removekhi đẩy entry ra, ném exception khi cache miss. - Nhận ra mẫu này là nền của nhiều cache thật (Caffeine, Memcached, Linux page cache), chỉ thêm metric, TTL và chính sách đẩy entry ra lên trên cùng bộ khung.
Bài tiếp theo: Case Study: LMAX Disruptor
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
PriorityQueue — Top-K, scheduler, Dijkstra cần queue thứ tự
Bài tiếpCase Study: LMAX Disruptor — Ring buffer thắng BlockingQueue
Thảo luận & góp ý
Hỏi đáp về bài này