Bản chất SSRF và bất đồng bộ URL Parser
Giải mã cơ chế Server-Side Request Forgery (SSRF) qua sự bất đồng bộ giữa các thư viện phân tích URL theo RFC 3986 và kỹ thuật mã hóa IP.
TL;DR: Server-Side Request Forgery (SSRF) xảy ra khi một máy chủ web bị kẻ tấn công thao túng để khởi tạo các kết nối mạng trái phép tới các hệ thống nội bộ hoặc dịch vụ bên thứ ba. Để ngăn chặn SSRF, các lập trình viên thường viết bộ lọc kiểm tra URL dựa trên các thư viện chuẩn. Tuy nhiên, sự bất đồng bộ (Parser Discrepancies) giữa bộ phân tích URL của tầng kiểm tra (Validator) và bộ phân tích URL của HTTP client thực tế (cURL, urllib, requests) mở ra cơ hội vàng cho kẻ tấn công: một URL nhìn qua có vẻ trỏ tới tên miền an toàn nhưng khi gửi yêu cầu lại kết nối thẳng vào địa chỉ nhạy cảm 127.0.0.1.
1. Scenario — Tính năng nạp ảnh đại diện từ mạng xã hội
Một trang mạng xã hội cung cấp tính năng "Tải ảnh đại diện qua đường link (Import Avatar from URL)". Người dùng chỉ cần dán một liên kết ảnh công khai:
POST /api/user/avatar-import HTTP/1.1
Host: social.example.com
Content-Type: application/json

{"url": "https://images.unsplash.com/photo-123.jpg"}
Để ngăn chặn nhân viên hoặc người dùng lợi dụng máy chủ quét mạng nội bộ, lập trình viên sử dụng module urllib.parse của Python để kiểm tra whitelist tên miền:
# Vulnerable URL validation logic
import urllib.parse, requests

ALLOWED_DOMAINS = ["images.unsplash.com", "cdn.imgur.com"]

def import_avatar(user_url):
    parsed = urllib.parse.urlparse(user_url)

    # Check if hostname is in whitelist
    if parsed.hostname not in ALLOWED_DOMAINS:
        return {"error": "Domain khong duoc phep"}, 400

    # Bug: Using a different HTTP client that parses URL differently
    response = requests.get(user_url, timeout=3)
    return {"status": "success", "data": response.content}
Một chuyên gia bảo mật nhập vào đường dẫn sau:
http://127.0.0.1#@images.unsplash.com/
- Đối với
urllib.parse.urlparse: Khi gặp ký tự#, parser coi toàn bộ phần phía sau là URL Fragment (mỏ neo trình duyệt), xác định hostname là127.0.0.1(bị chặn). - Nhưng nếu gửi:
http://[email protected]/:urllib.parsecoiimages.unsplash.comlàusername(userinfo) và127.0.0.1là hostname. - Tinh vi hơn, với các biến thể chứa ký tự đặc biệt, một số thư viện cũ của cURL hoặc Java URL connection lại hiểu nhầm vị trí cắt chuỗi, dẫn tới việc validator báo hợp lệ (Pass) nhưng thư viện gọi mạng lại kết nối tới cổng dịch vụ quản trị nội bộ
http://127.0.0.1:8080/admin.
2. Analogy — Giấy thông hành và người gác cổng mù chữ
Hãy tưởng tượng một người muốn đi vào kho quân sự tuyệt mật:
- Người duyệt giấy tờ (Validator): Xem xét lá thư giới thiệu mang tiêu đề: "Kính gửi: Doanh nghiệp Nông sản Hòa Bình @ Khu căn cứ Quân sự 9". Người duyệt giấy tờ chỉ nhìn thoáng qua chữ "Doanh nghiệp Nông sản Hòa Bình", đóng dấu "Hợp lệ" và chuyển lá thư cho tài xế xe tải.
- Tài xế xe tải (HTTP Client): Lại chỉ chú ý tới phần địa chỉ sau chữ
@("Khu căn cứ Quân sự 9"). Chiếc xe tải chở hàng chạy thẳng qua trạm gác bước vào khu quân sự tuyệt mật nhờ con dấu hợp lệ mà người duyệt vừa đóng.
Trong SSRF Parser Discrepancy, sự lệch pha giữa hai người kiểm tra chính là lỗ hổng:
| Đời sống thực tế | Cơ chế kỹ thuật trong SSRF |
|---|---|
| Tên doanh nghiệp nông sản vỏ bọc | Whitelist domain đặt ở phần userinfo (safe.com@...) |
| Khu căn cứ quân sự tuyệt mật | Địa chỉ IP nội bộ (127.0.0.1 hoặc metadata service) |
| Người duyệt giấy tờ sơ sài | Thư viện URL Validator đọc nhầm cấu trúc URL |
| Tài xế xe tải đi thẳng vào kho | Thư viện HTTP Client thực hiện request tới IP mục tiêu |
3. Vì sao chuẩn RFC 3986 lại tạo ra sự bất đồng bộ giữa các Parser?
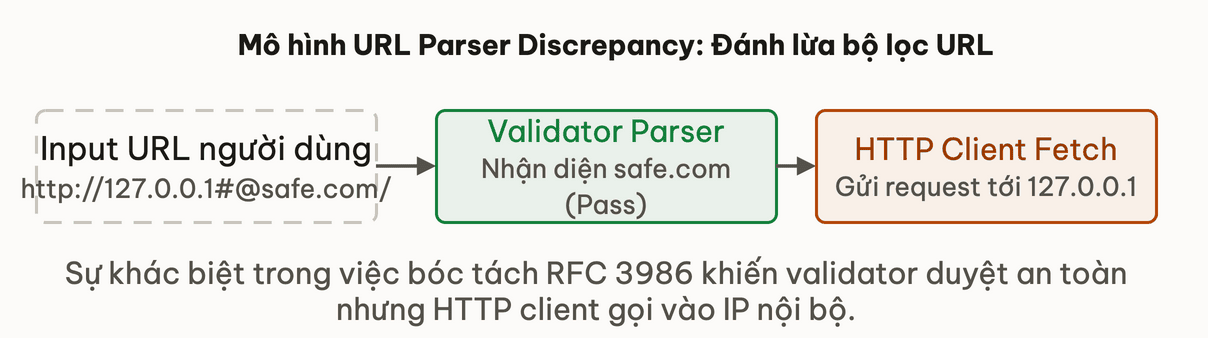
Cú pháp Uniform Resource Identifier (URI) được định nghĩa trong RFC 3986 với cấu trúc tổng quát:
URI = scheme://[userinfo@]host[:port]/path[?query][#fragment]
Mặc dù có tiêu chuẩn quốc tế, mỗi ngôn ngữ và thư viện lại hiện thực hóa (implement) parser này theo các cách rất khác nhau.
Trong bài học đầu tiên của khóa học, bạn đã nghiên cứu cấu trúc gói tin:
3.1. Ký tự phân cách Userinfo (@)
Theo RFC, ký tự @ dùng để phân tách thông tin xác thực (user:password) khỏi host. Tuy nhiên, nếu URL chứa nhiều ký tự @:
http://[email protected]@internal.service/
- Parser A (PHP
parse_urlcũ): Lấy phần sau dấu@đầu tiên (attacker.com). - Parser B (cURL): Lấy phần sau dấu
@cuối cùng (internal.service). - Parser C (Node.js
url): Báo lỗi hoặc cắt chuỗi sai lệch.
3.2. Kỹ thuật biến hóa địa chỉ IP (Alternative IP Formats)
Nhiều lập trình viên chỉ viết regex chặn chuỗi ký tự "127.0.0.1" hoặc "localhost". Kẻ tấn công có thể thay thế bằng các định dạng số học mà hệ điều hành vẫn tự động chuyển đổi về loopback address:
- Địa chỉ Dword (Số nguyên 32-bit không dấu):
- $127 \times 256^3 + 0 \times 256^2 + 0 \times 256 + 1 = 2130706433$
- URL:
http://2130706433/kết nối thẳng tới127.0.0.1.
- Hệ thập lục phân (Hexadecimal):
http://0x7f.0x0.0x0.0x1/hoặchttp://0x7f000001/
- Hệ bát phân (Octal):
http://0177.0.0.1/(số0177trong hệ bát phân tương đương số127trong hệ thập phân).
- Ký hiệu rút gọn:
http://127.1/hoặchttp://0/(trên Linux,0tự động mở rộng thành0.0.0.0, liên kết tới loopback interface).
- Địa chỉ IPv6:
http://[::1]/hoặchttp://[::ffff:127.0.0.1]/(IPv4-mapped IPv6 address).
# Webhook dispatcher
import re, requests

def trigger_webhook(target_url):
  # Regex blacklist check for localhost and private IP
  if re.search(r"^(https?://)?(localhost|127.0.0.1|10.|192.168.)", target_url):
      return {"error": "Private network forbidden"}, 403

  # Bug: Fetches URL without blocking alternative IP representations
return requests.post(target_url, json={"event": "ping"}).status_codeThử ngẫmKhi máy chủ backend chạy trong mạng đám mây (AWS/GCP), địa chỉ IP nhạy cảm nhất mà kẻ tấn công muốn hướng tới qua SSRF là gì?
Đó là địa chỉ Link-local 169.254.169.254 (Instance Metadata Service), nơi lưu trữ các thông tin chứng thực IAM tạm thời của máy ảo.
4. Kỹ thuật Bypass bộ lọc Whitelist Domain
Nếu ứng dụng chỉ cho phép các domain kết thúc bằng .example.com:
# Weak domain suffix check
if parsed.hostname.endswith(".example.com"):
    fetch(url)
Kẻ tấn công có thể áp dụng các thủ thuật:
- Đăng ký domain tương đồng:
attacker-example.comhoặcsub.attacker-example.com. - Dùng ký tự
@:http://127.0.0.1#@safe.example.com - Tận dụng Open Redirect trên domain tin cậy: Gửi
http://safe.example.com/redirect?url=http://127.0.0.1. Nếu thư viện HTTP client tự động theo chuyển hướng (HTTP 301/302 Redirect), request cuối cùng sẽ đánh thẳng vào hạ tầng nội bộ.
5. Pitfalls & Giải pháp khắc phục triệt để
❌ Bẫy thường gặp: Chỉ kiểm tra chuỗi URL trước khi gửi request
Sai lầm nghiêm trọng nhất trong phòng thủ SSRF là tách rời bước xác thực URL và bước gọi mạng. Dù bạn có viết hàm kiểm tra URL hoàn hảo đến đâu, nếu thư viện HTTP client tự động phân giải DNS độc lập ở bước sau, kẻ tấn công vẫn có thể vượt qua bằng kỹ thuật DNS Rebinding hoặc Open Redirect.
✅ Giải pháp chuẩn mực: Phân giải DNS, kiểm tra dải IP và chặn Redirect
Quy trình phòng vệ SSRF đạt chuẩn công nghiệp:
- Phân giải địa chỉ IP trước (Pre-resolve DNS): Sử dụng hàm socket hệ thống để phân giải domain thành địa chỉ IP cụ thể.
- Kiểm tra IP theo Whitelist / Không thuộc Private Network:
Python
import ipaddress, socket def is_safe_ip(ip_str): ip = ipaddress.ip_address(ip_str) return not ( ip.is_private or # 10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16 ip.is_loopback or # 127.0.0.0/8, ::1 ip.is_link_local or # 169.254.0.0/16 (Cloud Metadata) ip.is_reserved or ip.is_multicast ) - Gọi mạng trực tiếp tới IP đã kiểm tra: Không truyền domain cho HTTP client phân giải lại.
- Vô hiệu hóa tự động theo chuyển hướng: Đặt
allow_redirects=False. Nếu nhận được mã 301/302, trích xuất URL trong headerLocationvà chạy lại quy trình kiểm tra IP từ đầu.
6. Đào sâu
Tài liệu tham khảo chuyên sâu về phân tích URL và SSRF:
- Orange Tsai — A New Era of SSRF - Exploiting URL Parser in Trending Programming Languages: Công trình nghiên cứu kinh điển tại Black Hat USA 2017 mổ xẻ sự bất đồng bộ giữa các URL parser.
- OWASP Server-Side Request Forgery Prevention Cheat Sheet: Hướng dẫn thiết lập kiến trúc phòng thủ mạng và code pattern chuẩn.
- RFC 3986 — Uniform Resource Identifier (URI): Generic Syntax: Đặc tả cú pháp và ngữ nghĩa của chuẩn URI quốc tế.
7. Tóm tắt
- SSRF xảy ra khi kẻ tấn công thao túng máy chủ gửi các HTTP request tới tài nguyên mạng nội bộ hoặc dịch vụ cloud nhạy cảm.
- Sự bất đồng bộ trong cách triển khai chuẩn RFC 3986 giữa validator và HTTP client tạo ra lỗ hổng bỏ lọt bộ lọc URL.
- Địa chỉ IP có thể được biểu diễn dưới dạng Dword, Hex, Octal hoặc ký hiệu rút gọn để đánh lừa các biểu thức regex thô.
- Phòng thủ toàn diện đòi hỏi phải phân giải DNS, kiểm tra địa chỉ IP thực tế không thuộc dải private/loopback/link-local, và tắt tính năng tự động theo chuyển hướng HTTP 302.
8. Tự kiểm tra
- Q1Sự khác biệt giữa Blind SSRF và Semi-blind (hoặc In-band) SSRF là gì?
- Q2Tại sao việc sử dụng http://0.0.0.0/ trên nhiều hệ thống Linux lại có thể truy cập được các dịch vụ chỉ lắng nghe trên localhost (127.0.0.1)?
- Q3Nếu ứng dụng cấm scheme http:// và https://, kẻ tấn công có thể tận dụng các URL scheme nào khác để khai thác hệ thống nếu HTTP client hỗ trợ?
- Q4Tại sao cờ allow_redirects=True trong thư viện requests lại là một nguồn cơn phổ biến dẫn tới việc bypass bộ lọc SSRF?
- Q5Giải thích cơ chế bảo vệ SSRF ở tầng hạ tầng mạng (Network Segmentation & Egress Filtering)?
Bài tiếp theo: Kỹ thuật DNS Rebinding và cửa sổ thời gian TOCTOU
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Tổng quan module SSRF & Cloud Pivoting
Bài tiếpKỹ thuật DNS Rebinding và cửa sổ thời gian TOCTOU
Thảo luận & góp ý
Hỏi đáp về bài này