Gửi rồi đánh dấu: vòng gửi vừa gửi trùng vừa đánh rơi tin
Phương án đơn giản nhất: nhận job, gọi nhà cung cấp, đánh dấu xong, timeout thì thử lại. Tự mô phỏng timeout và worker chết, đếm tin trùng, tin mất và chỉ ra từng nguồn.
TL;DR: Vòng gửi đơn giản nhất là nhặt job, gọi nhà cung cấp, đánh dấu sent; timeout thì trả job về hàng chờ, tối đa ba lượt. Mô phỏng 100.000 job trên Postgres cho thấy nó vừa gửi trùng vừa làm mất tin. Tin trùng sinh ra khi nhà cung cấp đã gửi mà câu trả lời không về kịp: worker thử lại, người dùng nhận hai lần, bảng job vẫn chỉ ghi sent một lần. Tin mất nằm ở hai trạng thái không ai nhặt lại: sending khi worker chết giữa chừng, và failed khi ba lượt thử dồn cả vào lúc nhà cung cấp sập.
Đợt khuyến mãi năm triệu tin chạy xong, dashboard báo gần như mọi job đã sent. Sáng hôm sau, chăm sóc khách hàng nhận hai loại khiếu nại: người nhận một tin hai lần, người chờ OTP mãi không thấy. Bài 01 đã báo trước: timeout 2 giây cắt khoảng 0,5% lượt gọi, tức khoảng 25.000 lượt mập mờ mỗi đợt. Bạn tự mô phỏng vòng gửi ngây thơ và tự chỉ ra từng nguồn trước khi đọc lời giải.
1. Ràng buộc và phương án ngây thơ
Bài này dùng lại bốn dòng của bảng ràng buộc ở bài 01:
| Ràng buộc | Giá trị |
|---|---|
| OTP | phải tới máy trong 15 giây |
| Đợt khuyến mãi | 5 triệu tin trong 15 phút, khoảng 5.556 tin/giây |
| Timeout gọi nhà cung cấp | 2 giây, cắt khoảng 0,5% lượt gọi mà không biết kết quả |
| Nhà cung cấp | không chống trùng: gọi hai lần là gửi hai tin |
Hình dung một shipper nhận đơn trên app, giao xong bấm "đã giao". Có hôm app quay mãi, có hôm shipper ngã xe giữa đường:
| Shipper | Vòng gửi thông báo |
|---|---|
| Nhận đơn trên app | worker nhặt job, đổi sang sending |
| Giao tận tay, bấm "đã giao" | nhà cung cấp gửi tin, trả OK, worker ghi sent |
| App quay mãi, tổng đài cho giao lại | timeout, job về pending, lượt sau gửi lại |
| Ngã xe, đơn kẹt "đang giao" | worker chết sau khi nhặt, job kẹt sending |
Phương án ngây thơ là một bảng jobs(id, status, attempts) và một vòng lặp:
mỗi worker lặp mãi:
  1. nhặt job pending có id nhỏ nhất, đổi sang 'sending',
     attempts + 1, COMMIT
  2. gọi nhà cung cấp, chờ tối đa 2 giây
  3. nhận OK          -> đánh dấu 'sent'
     timeout hoặc lỗi -> attempts dưới 3 thì về 'pending',
                         đủ 3 thì 'failed'
Bước 1 commit trước khi gọi mạng để khỏi giữ transaction mở suốt 2 giây. Đây là cái hàng đợi FOR UPDATE SKIP LOCKED ở bài fan-out chạy trễ của case News feed, với một khác biệt: ở đó worker chết thì transaction rollback và job tự về pending. Ở đây bước 2 là lời gọi ra ngoài, và không rollback nào thu hồi được một tin đã nằm trên điện thoại.
2. Tự chạy: mô phỏng timeout và worker chết
Lab giả điện thoại bằng bảng delivered, mỗi hàng là một tin đã tới máy. Đời thật bạn không có bảng này. Tạo database lab rồi chạy setup.sql:
DROP TABLE IF EXISTS jobs, delivered;
DROP SEQUENCE IF EXISTS turns;
CREATE TABLE jobs (
  id       bigint PRIMARY KEY,
  status   text NOT NULL DEFAULT 'pending',
  attempts int  NOT NULL DEFAULT 0
);
CREATE INDEX ON jobs (id) WHERE status = 'pending';
-- phone side: one row per message that really arrived
CREATE TABLE delivered (job_id bigint NOT NULL);
CREATE INDEX ON delivered (job_id);
-- numbers worker turns; turns 30001..30300 hit a provider outage
CREATE SEQUENCE turns;
INSERT INTO jobs (id) SELECT g FROM generate_series(1, 100000) g;
Mỗi lượt worker là một lần chạy script pgbench worker.sql, gồm hai khối ghép liền nhau. Khối đầu nhặt job và đánh số lượt:
\set r random(1, 10000)
WITH c AS (
  UPDATE jobs SET status = 'sending', attempts = attempts + 1
  WHERE id = (SELECT id FROM jobs WHERE status = 'pending'
              ORDER BY id LIMIT 1 FOR UPDATE SKIP LOCKED)
  RETURNING id)
SELECT coalesce(max(id), 0) AS job_id,
       (nextval('turns') BETWEEN 30001 AND 30300)::int AS down
FROM c \gset
Khối sau để random(1, 10000) quyết định lượt gọi gặp chuyện gì:
\if :job_id = 0
\elif :r <= 10
-- worker dies right after claiming
\elif :down = 1 or :r <= 35
-- request never reached the provider: timeout
UPDATE jobs SET status = CASE WHEN attempts >= 3
  THEN 'failed' ELSE 'pending' END WHERE id = :job_id;
\elif :r <= 60
-- provider sent it, the response was lost: timeout
INSERT INTO delivered VALUES (:job_id);
UPDATE jobs SET status = CASE WHEN attempts >= 3
  THEN 'failed' ELSE 'pending' END WHERE id = :job_id;
\else
INSERT INTO delivered VALUES (:job_id);
UPDATE jobs SET status = 'sent' WHERE id = :job_id;
\endif
Bốn nút vặn: 0,1% lượt worker chết ngay sau khi nhặt; 0,25% request không tới nhà cung cấp; 0,25% nhà cung cấp đã gửi nhưng câu trả lời mất; lượt 30.001 tới 30.300 rơi vào lúc nhà cung cấp sập. Hai loại timeout cộng lại đúng 0,5% của bài 01; mô phỏng nén thời gian nên timeout xảy ra tức thì. Chạy 8 worker, mỗi worker 13.000 lượt, dư để xả hết job lẫn lượt thử lại:
psql lab -f setup.sql
pgbench -c 8 -j 4 -t 13000 --no-vacuum -f worker.sql lab
psql lab -f count.sql
count.sql đặt bảng job cạnh điện thoại:
SELECT j.status, count(*) AS so_job,
       count(*) FILTER (WHERE d.n = 0) AS tin_mat,
       sum(greatest(d.n - 1, 0)) AS tin_trung
FROM jobs j
CROSS JOIN LATERAL (
  SELECT count(*) AS n FROM delivered WHERE job_id = j.id) d
GROUP BY j.status ORDER BY j.status;
Trong 100.000 job, bao nhiêu tin sẽ tới máy hai lần, bao nhiêu job không tới máy nào, và các job đó nằm ở trạng thái nào trong bảng jobs? Viết ra ba con số kèm một câu lý do, rồi mới chạy.
Kết quả của tác giả qua ba lần chạy (Postgres 16 trong Docker trên máy Mac, mỗi lần 80 tới 110 giây):
| Trạng thái cuối | Số job | Tin mất | Tin trùng |
|---|---|---|---|
sent | 99.830 đến 99.852 | 0 | 237 đến 272 |
sending | 100 đến 122 | 98 đến 121 | 0 |
failed | 48 | 48 | 0 |
pgbench không báo lỗi nào. Hai dòng đầu trên máy bạn sẽ lệch vì phụ thuộc random(), còn dòng failed nhiều khả năng vẫn quanh 48; giữ lại câu hỏi vì sao.
Trước khi sang mục 3, viết hai câu: mỗi tin trùng sinh ra ở bước nào, mỗi tin mất kẹt ở đâu. Đáp án mẫu ở câu đầu phần tự kiểm tra.
3. Vì sao timeout rồi thử lại sinh ra tin trùng?
Tính ngược từ nút vặn: 0,25% của khoảng 100.000 lượt gọi là khoảng 250 lượt nhà cung cấp đã gửi mà câu trả lời mất. Mỗi lượt đó, job về pending, lượt sau gửi lại, điện thoại có hai tin. Số đo 237 đến 272 khớp phép tính. Không có bug nào ở đây; tin trùng đến thẳng từ quy tắc "timeout thì thử lại".
Bài đó đã chỉ ra rằng khi không nhận được trả lời, bạn không phân biệt được bên kia chưa nhận, đang chậm, hay đã làm xong mà gói trả lời bị mất; timeout chỉ là phỏng đoán. Thử lại một thao tác có tác dụng phụ là chạy nó lần hai, trừ khi phía nhận chống trùng được theo một khoá. Ở đây tác dụng phụ là gửi tin, và phía nhận không chống trùng.
Cái mới là ai thấy hậu quả: tin nhắn thì hậu quả nằm trên điện thoại người dùng, không trong database của bạn.
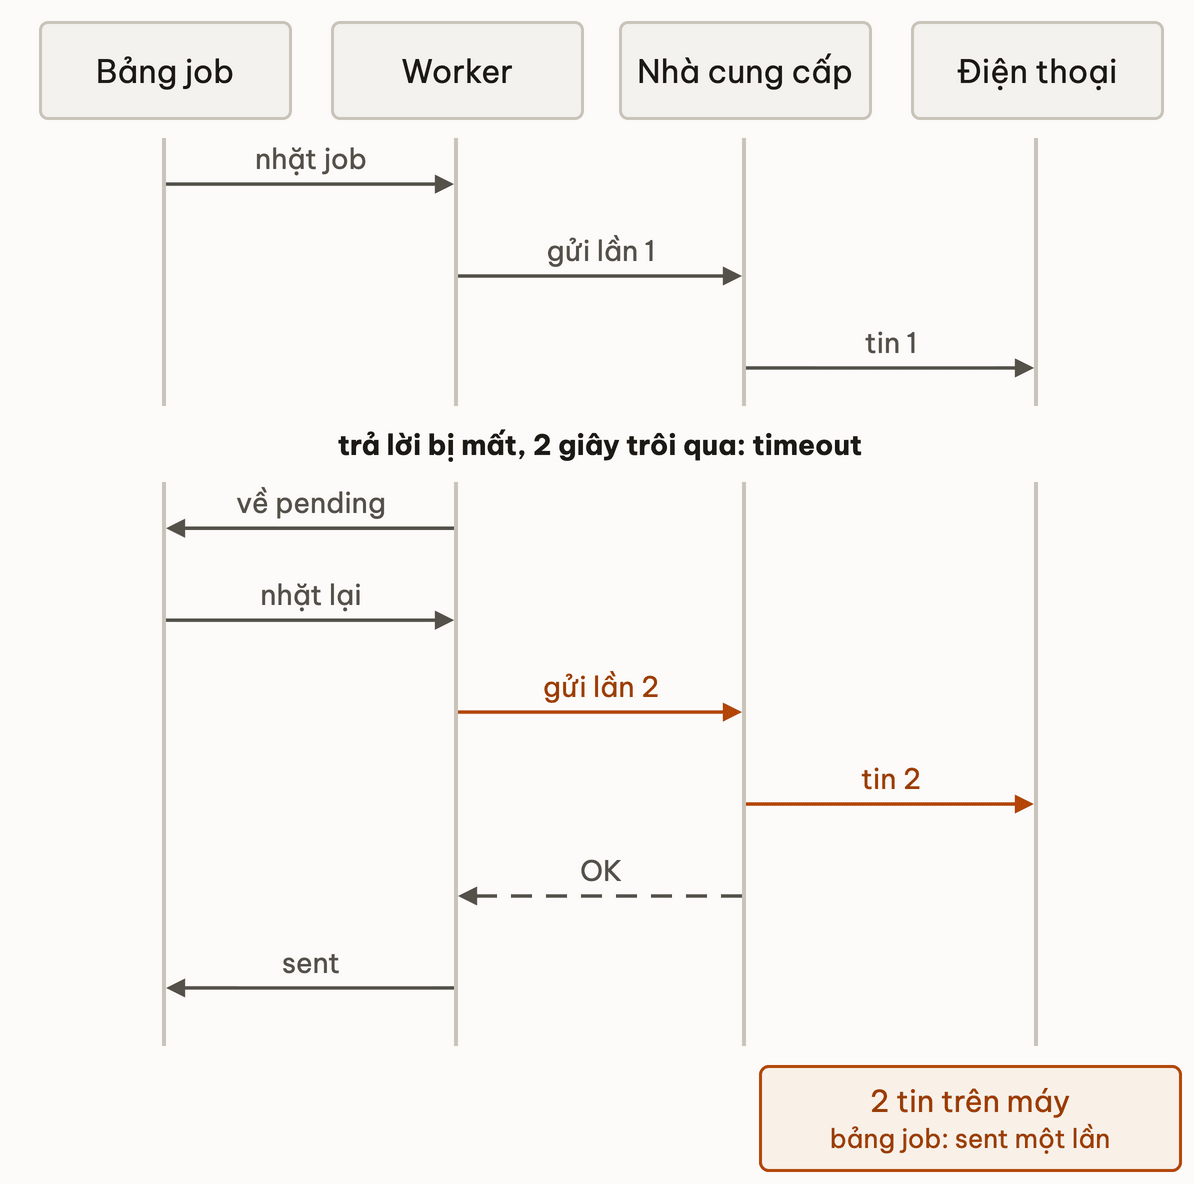
Dòng sent có khoảng 99.840 hàng, không cột nào nói "job này gửi hai lần". Cột attempts lớn hơn 1 cũng không giúp, vì nó tăng cả với lượt chưa hề tới nhà cung cấp. Muốn đếm tin trùng thật phải hỏi phía nhận: log nhà cung cấp, hoặc khiếu nại.
4. Tin mất nằm ở đâu trong vòng gửi?
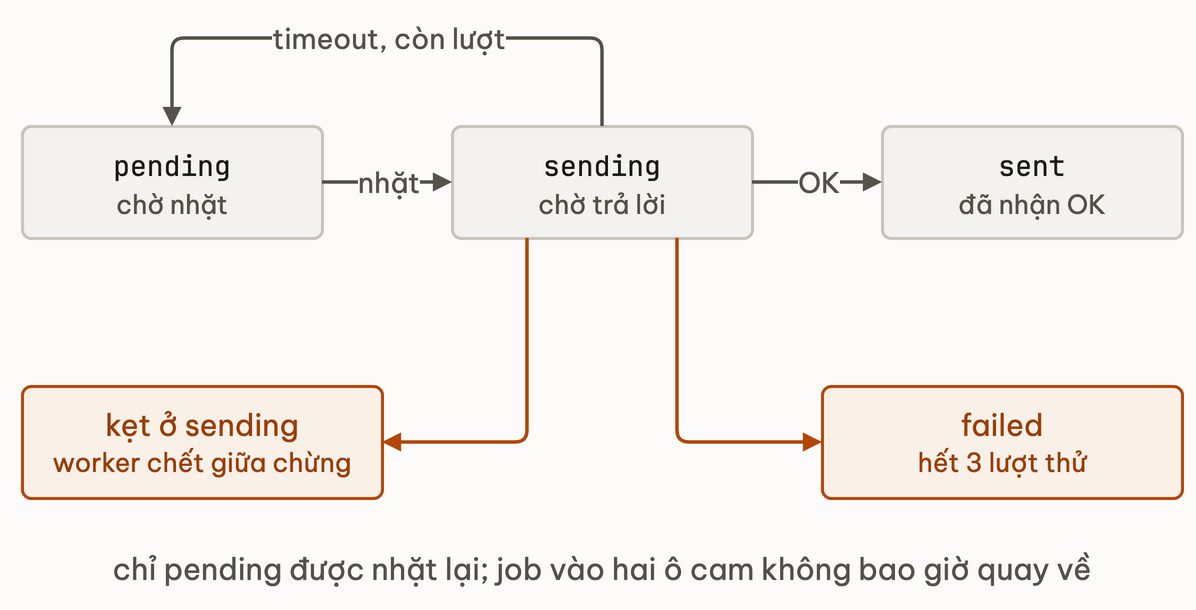
Vòng gửi chỉ nhặt job ở pending. Job nào rời trạng thái đó mà không về được sent thì nằm yên mãi.
4.1 Kẹt ở sending
Worker commit sending rồi mới gọi mạng. Tiến trình chết đúng lúc đó (bị kill khi deploy, hết bộ nhớ) thì job đứng ở sending, và câu WHERE status = 'pending' không bao giờ thấy nó nữa. Không lỗi, không log. 0,1% của khoảng 100.000 lượt là khoảng 100 job, khớp 100 đến 122 đo được.
Phản xạ đầu tiên là thêm tiến trình quét: job sending quá 30 giây thì trả về pending. Còn worker chỉ đang chậm thì sao?
Tiến trình bị dừng (GC, swap, máy ảo treo) thức dậy vẫn làm tiếp. Lease hết hạn không chặn được nó; fencing token thì chặn được, nếu nơi nhận lệnh ghi so token và từ chối token cũ.
Worker bị coi là chết có thể tỉnh dậy và gửi, trong khi job đã được worker khác gửi lần nữa. Fencing token không cứu được, vì nhà cung cấp không so token của bạn. Tiến trình quét đổi một phần tin mất thành tin trùng.
4.2 Hết lượt thử lại
Dòng failed là 48 ở cả ba lần chạy. Job lỗi trong lúc nhà cung cấp sập về pending với id nhỏ nhất nên được nhặt lại ngay, và ba lượt của nó nằm gọn trong 300 lượt sập. Với timeout thật 2 giây, ba lượt chỉ tốn khoảng 6 giây: một phút nhà cung cấp chập chờn đủ đốt hết lượt của mọi job đi qua.
Ngoài lúc sập, 0,5% timeout ba lần liền là xác suất cỡ một phần tám triệu. Tin mất không đến từ con số ba, mà từ lỗi dồn cục cộng các lượt thử đứng sát nhau.
5. Pitfall
❌ Nhầm 1: giữ transaction mở suốt lời gọi để "worker chết thì rollback":
BEGIN;
SELECT id FROM jobs WHERE status = 'pending'
  ORDER BY id LIMIT 1 FOR UPDATE SKIP LOCKED;
-- the app calls the provider here, up to 2 seconds
UPDATE jobs SET status = 'sent' WHERE id = 42;
COMMIT;
✅ Commit sending trước, gọi mạng khi không còn transaction nào mở, đúng như vòng ở mục 1:
BEGIN;
UPDATE jobs SET status = 'sending', attempts = attempts + 1
WHERE id = (SELECT id FROM jobs WHERE status = 'pending'
            ORDER BY id LIMIT 1 FOR UPDATE SKIP LOCKED)
RETURNING id;
COMMIT;
-- the app calls the provider here, no transaction held
UPDATE jobs SET status = 'sent' WHERE id = 42;
Rollback đưa job về pending chứ không thu hồi được tin đã gửi: worker chết sau khi nhà cung cấp gửi mà trước COMMIT thì job được gửi lần hai. Thêm nữa, mỗi tin đang gửi giữ một kết nối suốt lời gọi. Theo luật Little (việc đang dở bằng tốc độ đến nhân thời gian mỗi việc), 5.556 tin/giây nhân p50 150 ms là khoảng 830 kết nối mở cùng lúc, trong khi max_connections mặc định của Postgres là 100.
❌ Nhầm 2: đo tin trùng bằng bảng job:
SELECT count(*) FROM jobs WHERE status = 'sent' AND attempts > 1;
✅ Đếm ở phía nhận, nơi tin trùng thật sự hiện ra:
-- phone side: jobs that arrived more than once
SELECT count(*) FROM (
  SELECT job_id FROM delivered
  GROUP BY job_id HAVING count(*) > 1) t;
Câu attempts > 1 đếm cả job mà lượt đầu chưa hề tới nhà cung cấp: ở lần chạy cuối của tác giả nó ra 472, trong khi số tin trùng thật là 237. Chặn trùng là việc của bài 04.
❌ Nhầm 3: thấy failed thì nâng giới hạn từ 3 lên 10 lượt.
✅ Mười lượt sát nhau vẫn cháy hết trong một lần sập, và mỗi lượt thêm là một cơ hội gửi trùng. Thứ thiếu là khoảng chờ tăng dần giữa các lượt.
6. Đào sâu
- PostgreSQL 16, SELECT: Locking Clause:
SKIP LOCKEDcho nhiều consumer đọc chung một bảng kiểu hàng đợi. - PostgreSQL 16, pgbench:
\gset,\if,random(lb, ub)dùng ở mục 2. - Amazon Builders' Library, Timeouts, retries, and backoff with jitter: vì sao thử lại làm quá tải tệ hơn, và cách giãn lượt bằng backoff cộng jitter.
- Martin Kleppmann, How to do distributed locking: fencing token chỉ có tác dụng khi nơi nhận lệnh ghi chủ động kiểm token.
Liên hệ các bài khác
- Bài 03: chọn chịu mất hay chịu trùng cho từng loại tin.
- Bài 04: khoá chống trùng chặn được gì, để lọt gì.
- Bài 05: giữ OTP đúng hạn khi nhà cung cấp chậm giữa đợt khuyến mãi.
Tóm tắt
- Gặp tin trùng thì tìm chỗ thử lại sau timeout trước tiên; số tin trùng tỉ lệ với số lượt timeout mà nhà cung cấp đã gửi.
- Có tin mất thì liệt kê mọi trạng thái vòng gửi không nhặt lại; ở đây là
sendingkẹt vàfailed. - Chữa tin mất bằng tiến trình quét hay transaction dài thì kiểm xem có đang đổi tin mất lấy tin trùng không.
failedtăng vọt theo cụm thì nhìn khoảng cách giữa các lượt thử, không nhìn số lượt.
Tự kiểm tra
- Q1Chẩn đoán vòng gửi ngây thơ: mỗi tin trùng sinh ra ở bước nào, mỗi tin mất kẹt ở đâu?
- Q2Vì sao không viết được câu SQL nào trên bảng jobs đếm đúng số tin trùng?
- Q3Đồng nghiệp đề xuất tiến trình quét: job nào ở sending quá 30 giây thì trả về pending. Nó chữa được gì, và sinh ra lỗi mới nào?
- Q4Bạn hạ timeout từ 2 giây xuống 500 ms để OTP nhanh hơn. Giả sử 500 ms nằm giữa p90 và p99 độ trễ của nhà cung cấp. Số tin trùng thay đổi thế nào?
- Q5Chạy lại lab, dòng sending đổi mỗi lần còn failed gần như luôn 48. Vì sao, và nới lỗi sập lên 3.000 lượt thì failed thành bao nhiêu?
Bài tiếp theo: 03 — Mất hay trùng: chọn mức giao nhận cho từng loại thông báo.
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Ràng buộc và ước lượng: bao nhiêu lượt gửi tin mập mờ?
Bài tiếpMất hay trùng: chọn mức giao nhận cho từng loại thông báo
Thảo luận & góp ý
Hỏi đáp về bài này