Cách đây nhiều năm, lần đầu tiên tôi được giao một team và tự dựng một sản phẩm mới, tôi tưởng phần khó nhất sẽ là code. Hoá ra không phải. Bản chạy thử ổn, sắp sang giai đoạn chạy thật thì các sếp nhắn: cần server cấu hình thế nào thì báo, để hạ tầng chuẩn bị.
Tôi nhớ mình nhìn câu hỏi đó khá lâu. Code thì tôi viết được, còn bao nhiêu CPU, bao nhiêu RAM, mấy instance thì chưa từng phải trả lời, và cũng chưa ai dạy. Hệ thống chưa có người dùng thật nên chẳng có số nào để mở ra xem. Hạ tầng thì cấp đúng bằng những gì tôi báo: thiếu thì lên thật là sập, dư thì có người hỏi vì sao xin nhiều thế.
Thế là tôi bắt đầu đi tìm hiểu cách estimate. Đọc, hỏi người đi trước, rồi tự đo trên môi trường test, ước lượng từ số đo đó, và khi lên thật thì gắn monitor để xem con số mình xin hoá ra đúng hay sai. Gần đây, một bạn junior trong team điền form xin tài nguyên cho service mới, và tôi nhận ra đúng cảm giác ngày ấy. Form có bốn mục: CPU, RAM, số instance, số connection tới database. Hạn nộp là cuối tuần. Bạn mở manifest của một service cũ trong team ra tham khảo, thấy bên đó chạy êm nên ghi theo: mỗi instance 4 vCPU, 8 GB, tổng 6 instance (định chia đều cho ba zone để bảo đảm dự phòng). Nhân ra là 24 vCPU và 48 GB RAM cho một service chưa có người dùng nào, và không ai trong phòng biết đó là dư, đủ hay thiếu. Hai quý trước, một service cùng team bị cấp thiếu RAM: pod bị OOM kill giữa đợt UAT, cả tuần chạy lại kịch bản kiểm thử. Khi tôi hỏi con số này tính từ đâu, bạn ấy giải thích: "Em thấy service cũ chạy 4 vCPU với 8 GB bao năm nay CPU chỉ tà tà 30% không lỗi gì, với lại sợ thiếu RAM như đợt trước nên em nhân 6 instance cho an toàn."
Tôi không hỏi để bắt bẻ. Lần đầu tôi cũng cho một con số na ná thế, vì form chỉ có chỗ cho con số, không có chỗ cho lý do.
Điều form không hỏi. Một con số sizing đáng tin gồm ba thứ đi cùng nhau: công thức đổi lượng truy cập thành số request đang xử lý cùng lúc (Little's Law, L = λ × W), một mức tải cố ý chừa dưới ngưỡng mà hệ thống bắt đầu chậm vọt lên, và điểm gãy do load test đo ra chứ không đoán. Thiếu một trong ba thì con số trong form chỉ là con số copy.
Hai cách estimate tưởng đúng mà sai
Hai cách estimate phổ biến nhất, nhân từ số đo trên máy dev và học theo dịch vụ cũ, sai vì cùng một lý do: số đo ấy chưa chắc đại diện cho production.
Tôi bảo bạn junior thử tính lại từ đầu, và bạn ấy đưa ra hai cách. Cả hai đều hợp lý nếu nhìn qua.
Cách thứ nhất là nhân tuyến tính từ số đo trên môi trường dev. Giả sử bạn ấy đã chạy thử một pod (một bản chạy của service, ở đây được cấp 2 vCPU) với 20 user ảo, đạt khoảng 500 request mỗi giây khi CPU ở 70%. Giờ cao điểm (peak) của service ước chừng 600 request mỗi giây, vậy hai pod là dư. Cách thứ hai nhìn vào dịch vụ cũ: CPU trung bình chỉ 30%, nghĩa là dự án trước xin dư, và 4 vCPU mỗi instance là thoải mái.
Cả hai cách đều dựa trên số đo thật, nên không ai thấy lỗi. Lỗi nằm ở chỗ số đo ấy đại diện cho cái gì, và sơ hở lộ ra ngay ở bước đầu tiên: đổi đơn vị.
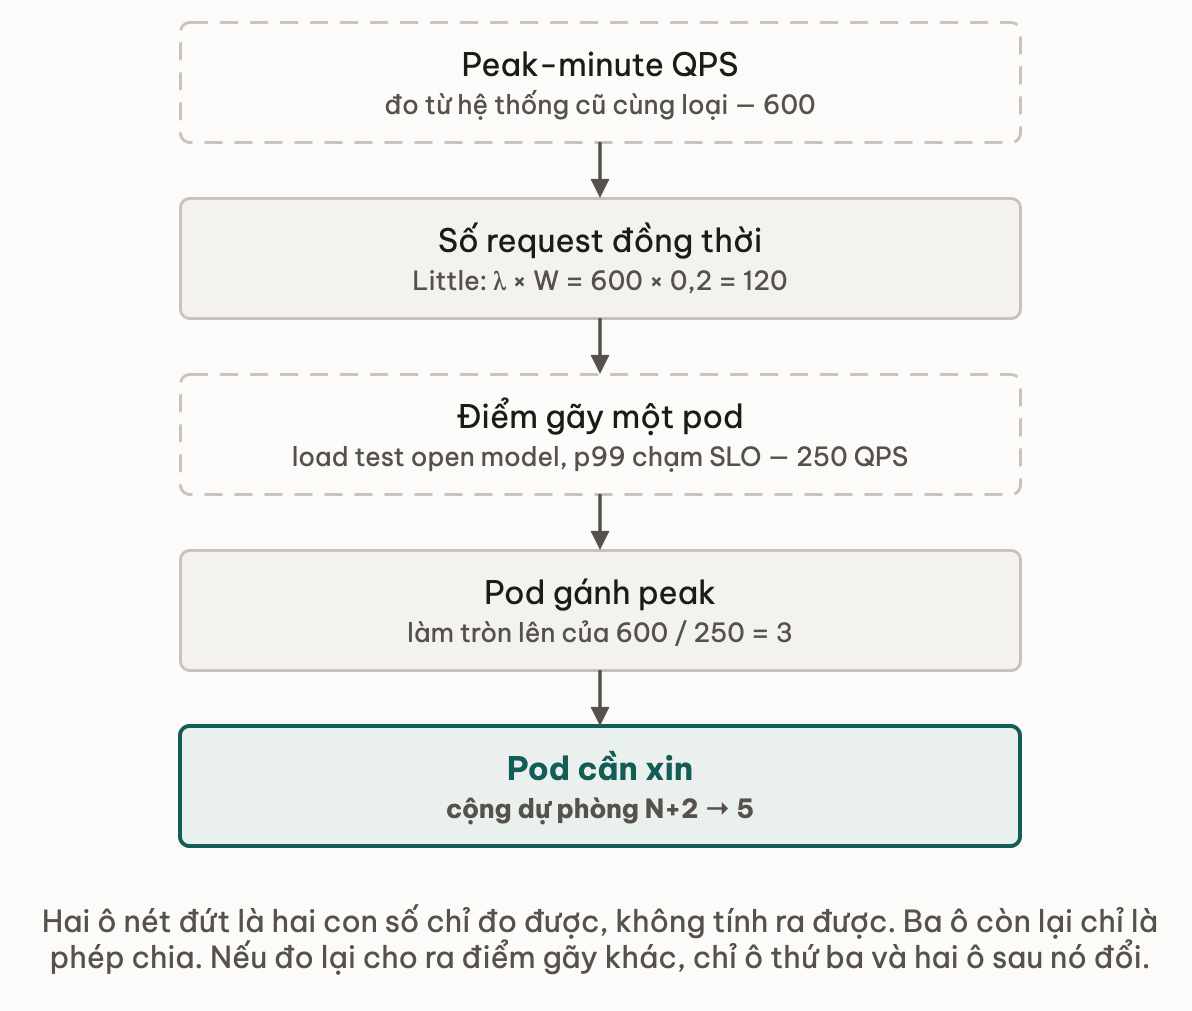
Toàn bộ phép tính đi qua năm bước, trong đó có hai con số chỉ đo được chứ không tính ra được:
Bước một: đổi QPS thành số request đang chạy cùng lúc
Little's Law cho phép quy đổi lượng request đến trong một giây (QPS) và thời gian xử lý trung bình thành số request đang chạy đồng thời trong hệ thống. Lấy một quán cà phê làm ví dụ: mỗi phút có 2 khách bước vào, mỗi khách ngồi lại trung bình 10 phút, vậy lúc nào trong quán cũng có khoảng 20 người. Service cũng thế. Biết mỗi giây có bao nhiêu request đến và mỗi request nằm lại bao lâu, ta suy ra được có bao nhiêu request đang xử lý cùng một lúc, và đó là con số nền tảng của mọi phép sizing. Quan hệ này là Little's Law, do J.D.C. Little chứng minh năm 1961 (Operations Research 9(3), 383–387):
L = λ × W

L: số request đang ở trong hệ thống (đồng thời)
λ: tốc độ request đến (request/giây, hay QPS)
W: thời gian trung bình một request ở lại hệ thống (giây)
Với service này: giờ cao điểm 600 request/giây, mỗi request ở lại trung bình 0,2 giây trên staging (môi trường thử gần giống thật) với dữ liệu cỡ thật, tính cả thời gian chờ database và chờ các service khác. Vậy L = 600 × 0,2 = 120 request cùng lúc. Nếu tạm chia cho ba pod thì mỗi pod gánh khoảng 40.
Tôi nhờ bạn junior áp chính công thức này lên số đo dev. Hai mươi user ảo gửi liên tục không nghỉ, 500 request mỗi giây: W = L / λ = 20 / 500 = 0,04 giây. Bạn ấy chia xong ngồi im: thời gian ở lại hệ thống trên dev chỉ bằng một phần năm của staging. Hai thứ làm số đo dev đẹp hơn thật. Một là 20 user ảo cứ xong request này mới gửi request kế, nên service chậm đến đâu thì tải cũng tự nhẹ đi theo. Hai là dữ liệu dev bé nên query nhanh. Đẹp hơn bao nhiêu thì từ số đo này chưa tách ra được, phải đo lại ở bước ba.
| Máy dev | Staging | |
|---|---|---|
| Dữ liệu | bé | cỡ thật |
Thời gian một request nằm lại (W) | 0,04 giây | 0,2 giây |
Số request cùng lúc (L) | 20 | 120 |
Có hai chỗ dễ nhầm khi dùng công thức này. Thứ nhất, W là toàn bộ thời gian một request nằm trong hệ thống, gồm cả lúc thread đứng chờ lẫn lúc tính; đừng lẫn với W trong công thức thread pool của khoá hệ điều hành, nơi W chỉ là thời gian chờ còn C là thời gian tính. Thứ hai, 600 request/giây phải lấy từ số đo của chính bạn (hệ thống cũ cùng loại, log của API gateway), vì tỉ lệ cao điểm trên trung bình đổi theo từng sản phẩm: ngày lương, cuối tháng, giờ mở bán đều cho con số khác. Và W còn tăng khi tải tăng, kéo L tăng theo, nên L = 120 chỉ là mức tối thiểu.
Bước hai: đừng chạy sát trần, vì càng gần đầy càng chậm vọt lên
Độ trễ trung bình của hệ thống tăng vọt phi tuyến tính khi mức sử dụng tiến sát trần 100%, do đó tài nguyên luôn cần chừa khoảng trống cho hàng đợi thở. Quán cà phê ấy có một quầy thu ngân. Khi quầy chỉ bận một nửa thời gian, khách đến là được phục vụ ngay. Khi quầy bận 90% thời gian, chỉ cần vài khách đến cùng lúc là hàng dài ra, và người đứng cuối chờ rất lâu. Tỉ lệ thời gian bận ấy gọi là mức sử dụng. Ở mô hình hàng đợi đơn giản nhất (M/M/1: một quầy, khách đến ngẫu nhiên), từ 50% lên 90% mức sử dụng làm thời gian chờ trung bình tăng năm lần, nên service phải chừa chỗ trống thay vì chạy sát trần. Cách thứ hai của bạn junior trượt đúng ở đây: ngầm coi CPU 30% là "còn 70% dư để dùng".
Công thức là R = S / (1 − ρ), trong đó S là thời gian phục vụ một request lúc rảnh, ρ là mức sử dụng của máy phục vụ, R là thời gian phản hồi trung bình. Với S = 100 ms, mức sử dụng 50% cho phản hồi 200 ms, 90% cho 1 giây và 99% cho 10 giây:
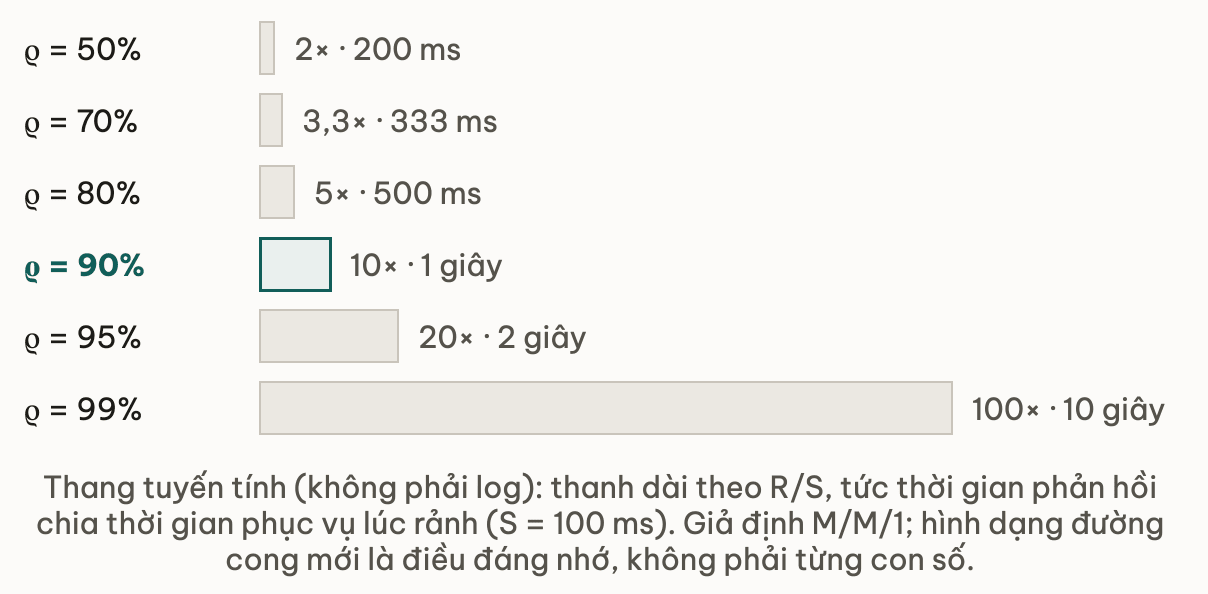
Marc Brooker mô tả đúng hiện tượng này trong bài về latency và utilization: độ trễ tăng phi mã khi ρ tiến về 1. Mô hình giả định request đến ngẫu nhiên và chỉ có một máy phục vụ; service thật khác, nhưng đường cong vẫn có khúc gập gắt như cái đầu gối.
Bạn junior nhìn thanh dài nhất một lúc rồi bảo: "Nhưng CPU em thấy mới 30%, còn xa chỗ này mà anh?" Tôi bảo 30% đó là mức trung bình cả ngày, còn hàng đợi dài ra ở giờ cao điểm, lúc mức sử dụng cao hơn nhiều. Phần "còn dư" không phải để dùng nốt. Nó là chỗ cho hàng đợi thở khi request dồn về cùng lúc.
Bạn ấy hỏi tiếp: "Vậy giữ 70% có được không anh?" Tôi bảo con số đó không mượn của ai được, kể cả của tôi. Mức nên giữ phải lấy từ cam kết chất lượng (SLO) của chính bạn. Ví dụ cam kết "p99 dưới 500 ms", nghĩa là 99% request phải xong trong 500 ms. Cứ tăng tải cho tới khi p99 chạm 500 ms: mức tải đó là điểm gãy ở bước ba, và phần chừa chỗ trống đã nằm sẵn trong con số ấy. Vì sao SLO viết theo p99 chứ không theo trung bình thì bài về percentile và SLO giải thích kỹ.
Bước ba: điểm gãy phải đo, và đo đúng kiểu
Sách SRE của Google chốt phần này bằng một câu ngắn: load test thành phần đến khi nó hỏng (chương Addressing Cascading Failures). Điểm gãy của một pod là mức tải (số request mỗi giây, gọi tắt là QPS) mà tại đó p99 vừa chạm ngưỡng SLO đã đặt, ví dụ 500 ms. Pod thường gãy từ lâu trước khi CPU chạm 100%. Đây cũng là con số duy nhất trong cả phép tính mà không công thức nào cho bạn được.
Đo kiểu nào quan trọng chẳng kém việc có đo hay không, và cái bẫy của số đo dev nằm ở đây. Tài liệu k6 chia hai kiểu:
| Closed model (số user cố định) | Open model (tốc độ đến cố định) | |
|---|---|---|
| Ai quyết định tốc độ gửi | Số user ảo cố định, mỗi user chỉ gửi request kế khi request trước đã xong | Request đến theo tốc độ đặt trước, không chờ request trước |
| Khi service chậm đi | Các user ảo cũng gửi chậm lại, hàng đợi không kịp dài ra | Hàng đợi dài ra như production |
| Dùng để | Mô phỏng một nhóm user hữu hạn | Tìm điểm gãy của service public |
Closed model có một tật: đúng lúc service chậm, bài test lại tự gửi ít đi, nên đúng lúc đáng đo nhất thì số đo lại đẹp giả. Giới load test gọi hiện tượng này là coordinated omission, và tài liệu k6 cũng nhắc tới nó. Với bài toán sizing, dùng open model: trong k6 là executor constant-arrival-rate hoặc ramping-arrival-rate, tăng dần tốc độ đến cho tới khi p99 vượt SLO (open vs closed model trong tài liệu k6). Và chạy trên dữ liệu cỡ thật: query nhanh trên vài nghìn dòng có thể chậm hơn nhiều trên vài chục triệu dòng, điểm gãy dịch theo.
Đừng coi mọi request như nhau khi đọc QPS. Sách SRE của Google chọn đo năng lực bằng tài nguyên (CPU) vì các query khác nhau tốn tài nguyên khác nhau rất xa (chương Handling Overload). Tra cứu sao kê một trang và xuất sao kê cả năm cùng là "một request" nhưng không cùng loại tải.
Tôi đoán trước rằng phần lớn chênh lệch đến từ kiểu đo, nên bảo bạn junior đổi từng thứ một. Giả sử chỉ đổi sang open model, vẫn trên dữ liệu dev, pod gãy ở khoảng 450 QPS: kiểu đo chỉ lấy đi chừng mười phần trăm. Tôi đoán sai. Đổi tiếp sang dữ liệu cỡ staging, pod gãy ở 250 QPS với p99 chạm 500 ms, đúng một nửa con số 500 từ cuộc chạy đầu. Thủ phạm chính là cỡ dữ liệu, khớp với việc W trên staging gấp năm lần trên dev. Peak 600 QPS chia 250 QPS mỗi pod, làm tròn lên: cần 3 pod để gánh peak.
Ba pod gánh được peak, nhưng mất một pod là chỉ còn hai. Sách SRE tính phần này bằng N+2: nếu mỗi cụm gãy ở 5.000 QPS và peak là 19.000 QPS thì cần bốn cụm cho peak, thêm hai cụm dự phòng thành sáu (cùng chương trên). Áp vào đây là 3 + 2 = 5 pod: ba pod để gánh peak, thêm hai pod dự phòng. Cách tính này gọi là N+2, Google dùng ở quy mô cụm; với service nhỏ, thêm một hay hai pod dự phòng là quyết định về SLO và chi phí của bạn.
CPU, RAM và connection: ba hạng mục tính từ giới hạn cứng
CPU, RAM và connection pool đều có một giới hạn cứng riêng: vượt CPU thì pod bị bóp chậm lại, vượt RAM thì pod bị hệ điều hành giết (OOM kill), vượt số connection thì database từ chối kết nối. Nên mỗi hạng mục phải tính hoặc đo từ giới hạn đó, không copy.
CPU. Hạng mục CPU trả lời câu hỏi "pod cỡ nào". Cỡ pod là cỡ bạn đã dùng khi load test: pod 2 vCPU gãy ở 250 QPS thì request và limit là của pod 2 vCPU, tổng 5 × 2 = 10 vCPU. Request là mức tối thiểu Kubernetes đảm bảo cho pod, và cũng là căn cứ để chọn máy đặt pod. Limit là trần: vượt trần thì hệ điều hành bóp tốc độ pod lại, gọi là throttling (tài liệu Kubernetes về resource management). Việc bóp diễn ra theo từng nhịp ngắn, nên p99 xấu đi trong khi biểu đồ CPU trung bình vẫn đẹp. Cơ chế nằm trong bài về cgroups và CPU throttling.
RAM. Pod hay bị giết vì hết RAM do người ta chỉ tính phần heap. Bộ nhớ của một JVM không chỉ có heap: còn metaspace, code cache (mặc định 240 MB), direct buffer, và stack cho mỗi thread (khoảng 1 MB trên Linux x64). Chi tiết ở bài về bộ nhớ ngoài heap của JVM. Số thread tồn tại là cỡ thread pool chứ không phải số request đồng thời: pool vài trăm thread như mặc định 200 của Tomcat có thể chiếm tới vài trăm MB stack ngoài heap, và đó mới là mức trần chứ chưa phải mức đã commit. Cách đáng tin là bật Native Memory Tracking rồi chạy jcmd <pid> VM.native_memory (xem bài về jcmd và jstat), cộng các vùng lại, và đặt limit của container cao hơn tổng đó có chừa. Đặt thấp hơn thì pod bị giết ngay lúc vượt, không có cảnh báo trước, vì hệ điều hành chỉ ra tay khi đã hết chỗ (bài về OOM kill).
Connection. Ở đây có một cái bẫy do phép tính số pod tạo ra. Bạn junior đặt connection pool 50 cho mỗi pod, nghĩ rằng cứ nhiều cho chắc, rồi dựng thử năm pod trên staging để kiểm. Pod thứ ba không lên được, log đầy sorry, too many clients already. Bạn ấy gọi tôi sang xem, và tôi chỉ hỏi một câu: năm pod nhân năm mươi là bao nhiêu? Là 250 connection, trong khi max_connections mặc định của PostgreSQL thường là 100 (tài liệu PostgreSQL), và PostgreSQL còn giữ vài slot cho superuser. Mặc định của HikariCP là 10, và bài về virtual thread cho thấy pool cố định ấy là chỗ request dồn lại khi thread pool không còn chặn tải. Mười hay năm mươi đều là lựa chọn, còn tổng của mọi pod thì phải nằm dưới trần của database:
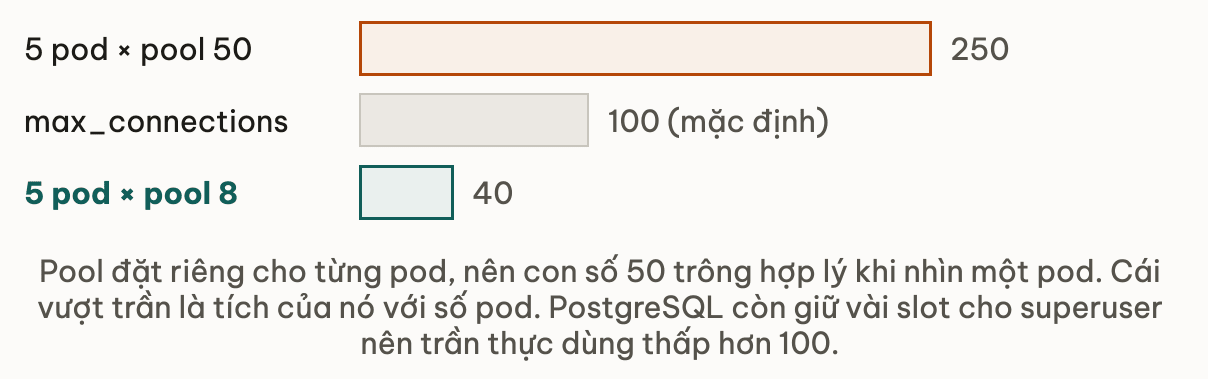
Pool càng lớn càng dễ vỡ trần connection.
Sai: pool = 50 mỗi pod, nhân với số pod đủ để vượt max_connections.
Đúng: tổng pool của mọi pod, kể cả khi scale ra, phải nằm dưới max_connections của database (chừa chỗ cho công cụ quản trị, migration, job). Nguyên lý "pool quá nhỏ thì request xếp hàng, quá lớn thì server quá tải" đã có trong bài về connection pooling. Wiki của HikariCP đi xa hơn: một pool nhỏ mà lúc nào cũng có thread chờ connection thì nhanh hơn pool lớn. Họ dẫn một demo của Oracle giảm pool từ 2048 xuống 96 connection, và thời gian phản hồi giảm từ khoảng 100 ms xuống 2 ms (About Pool Sizing). Công thức khởi điểm wiki dẫn lại từ dự án PostgreSQL là (số core của máy database × 2) + effective_spindle_count (số ổ đĩa quay hiệu dụng; phần này đã nằm trong bài connection pooling nói ở trên), và chỉ là điểm xuất phát để thử quanh nó.
Con số pool mỗi pod đi ra từ chính Little's Law, áp lên database thay vì lên cả request. Giả sử mỗi request giữ connection tổng cộng khoảng 20 ms (vài câu query ngắn), thì L_db = 600 × 0,02 = 12 connection bận ở peak, chia cho 5 pod là khoảng 2,4 mỗi pod. Pool 8 mỗi pod cho khoảng gấp ba lần mức bận trung bình, đủ chỗ cho burst. Hàng chục thread của một pod không tranh nhau tám connection, vì mỗi thread chỉ giữ connection khoảng một phần mười W.
Bảng sizing có nguồn và điều kiện sai cho từng con số
Gom lại, thay vì sửa từng con số trong form, mỗi dòng nên có đủ ba thứ: giá trị, nguồn của giá trị, và điều gì làm nó sai.
| Hạng mục | Giá trị | Nguồn / cách kiểm | Sai khi nào |
|---|---|---|---|
| Peak | 600 QPS | peak-minute từ log API cũ cùng loại | request mix đổi, chiến dịch lớn |
| W | 0,2 giây | đo trung bình (mean) trên staging, dữ liệu cỡ thật | dữ liệu lớn dần, downstream chậm |
| Concurrency | 120 | 600 × 0,2 (Little) | W tăng lúc tải cao |
| Điểm gãy 1 pod | 250 QPS | load test open model trên pod 2 vCPU, p99 ngưỡng 500 ms | dữ liệu cỡ khác, đổi version |
| Số pod | 3 + 2 = 5 | ceil(600 / 250) cộng dự phòng | điểm gãy đo lại khác |
| CPU mỗi pod | 2 vCPU, tổng 10 | cỡ pod dùng khi đo điểm gãy | đổi cỡ pod mà không đo lại |
| Pool mỗi pod | 8, tổng 40 | Little áp lên DB: 600 × 0,02 = 12 connection bận, chia 5 pod, nhân khoảng 3 cho burst | query chậm đi, thêm pod mà quên pool |
| Limit RAM | chưa chốt | đo native memory sau load test | thread, direct buffer tăng |
So với dòng điền sẵn ban đầu, 6 instance × 4 vCPU là 24 vCPU, còn bảng này cho 10. Chênh lệch ấy chưa nói bản nào đúng: nếu UAT cho điểm gãy thấp hơn 250, số pod sẽ tăng. Khác ở chỗ con số 5 sai thì biết ngay sai ở đâu: điểm gãy đo lại khác thì sửa một dòng, và cột cuối cho biết dòng nào kéo theo. Con số chép từ chỗ khác thì đến lúc sai không ai biết bắt đầu từ đâu.
Form gửi đi vào thứ Sáu, với cột lý do do bạn junior điền. Dòng đầu ghi "Peak 600 QPS, lấy từ log API cũ". Ở hạng mục RAM bạn ấy viết "chưa chốt, đo sau load test", lần đầu tôi thấy một form xin tài nguyên có chữ đó.
Các con số trong bài là số minh hoạ tính ra từ công thức, không phải số đo của một hệ thống thật; cảnh kể được dựng lại từ những dự án điển hình.
Throttling, OOM kill và cách đọc số đo tài nguyên để biết dòng nào trong bảng sẽ sai đầu tiên nằm trong khoá Hệ thống và tài nguyên.
Bài viết này đáng chia sẻ?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Sẵn sàng học sâu hơn?
Biến những gì vừa đọc thành kỹ năng thật với khoá học của OLHub, hoặc mang câu hỏi của bạn ra thảo luận cùng cộng đồng.
Đọc tiếp
Bài viết liên quan
Vì sao Redis distributed lock vẫn cấp cho hai client khi failover?
Lock ghi vào master Redis nhưng replication bất đồng bộ chưa kịp sang replica; failover bầu replica lên thì key biến mất và client thứ hai xin được lock.
Vì sao có index rồi mà PostgreSQL vẫn quét toàn bộ bảng?
Index nằm đúng trên cột đang lọc mà EXPLAIN vẫn báo Seq Scan. Hai nguyên nhân khác hẳn nhau: planner không thể dùng, và planner tra index rồi chủ động bỏ.
Bọc transaction vẫn lệch số: bẫy isolation level READ COMMITTED
Báo cáo bọc trong BEGIN/COMMIT vẫn in ba dòng không cộng được: ở READ COMMITTED mỗi câu lệnh lấy một ảnh chụp mới, transaction không đóng băng dữ liệu.
Vì sao check trùng bằng SELECT trên nhiều pod vẫn lệch dữ liệu?
Hai pod cùng SELECT check trùng rồi INSERT vẫn lệch. UNIQUE chốt tạo mới; số dư nên cộng/trừ atomic hoặc FOR UPDATE — @Version không phải lựa chọn đầu cho tiền.