Composite index ordering — leftmost prefix và INCLUDE
Index (a, b, c) không giúp WHERE b = x vì B-tree sort theo a trước; bài dạy đặt equality trước range, INCLUDE cho Index Only Scan và chọn thứ tự theo workload.
TL;DR: Composite index (a, b, c) là một B-tree duy nhất mà key là bộ ba nối lại, sort theo a trước, b trong từng nhóm a, c trong từng nhóm (a, b). Query chỉ dùng được index khi WHERE có cột đầu tiên (leftmost prefix); WHERE b = x một mình thì cây không biết bắt đầu từ đâu và planner chọn Seq Scan. Thứ tự tốt: cột equality trước, cột range cuối, vì range "ngắt" khả năng thu hẹp tiếp. Cột chỉ xuất hiện trong SELECT thì đưa vào INCLUDE để có Index Only Scan mà không phình cây. Hai query cần prefix khác nhau thì cần hai index, hoặc đổi thứ tự và chấp nhận tradeoff.
Team TaskFlow tạo composite index để tăng tốc dashboard:
CREATE INDEX ON tasks(project_id, status, due_at);
Một tuần sau, dev thêm query mới: SELECT * FROM tasks WHERE status = 'done';. Trước khi đọc tiếp, bạn đoán planner có dùng index vừa tạo không?
EXPLAIN báo Seq Scan: index không được dùng. Index sort theo project_id trước, status chỉ có thứ tự bên trong mỗi nhóm project_id. Query bỏ qua project_id giống tra mục lục sách mà không biết chương nào, phải đọc toàn bộ. Bài này giải thích leftmost prefix rule, thứ tự equality vs range, INCLUDE cho Index Only Scan, và cách chọn thứ tự cột theo workload thật.
1. Analogy — tủ hồ sơ nhân sự
Phòng nhân sự xếp hồ sơ theo ba tầng: phòng ban → chức danh → ngày vào công ty. Cần "mọi kỹ sư của phòng Backend vào từ 2024" thì đi thẳng tới ngăn Backend, tới kẹp Kỹ sư, rồi lật từ 2024 trở đi. Nhưng "mọi người vào công ty ngày 2024-05-01" mà không biết phòng ban thì phải mở mọi ngăn, vì ngày chỉ có thứ tự bên trong từng kẹp chức danh, không có thứ tự toàn tủ.
| Tủ hồ sơ | Composite index (a, b, c) |
|---|---|
| Ngăn phòng ban | Cột a, sort key ngoài cùng |
| Kẹp chức danh trong ngăn | Cột b, sort trong nhóm a |
| Ngày vào trong kẹp | Cột c, sort trong nhóm (a, b) |
| Biết phòng ban → tới thẳng ngăn | WHERE a = X navigate tới subtree |
| Chỉ biết ngày → mở mọi ngăn | WHERE c = X đọc toàn cây |
2. Vì sao index (a, b, c) không giúp WHERE b = x?
Nhớ từ bài trước: mỗi entry leaf là key + CTID. Với composite, key là bộ (project_id, status, due_at) nối lại và so sánh theo thứ tự từ điển, nên toàn bộ cây vẫn là một B-tree bình thường:
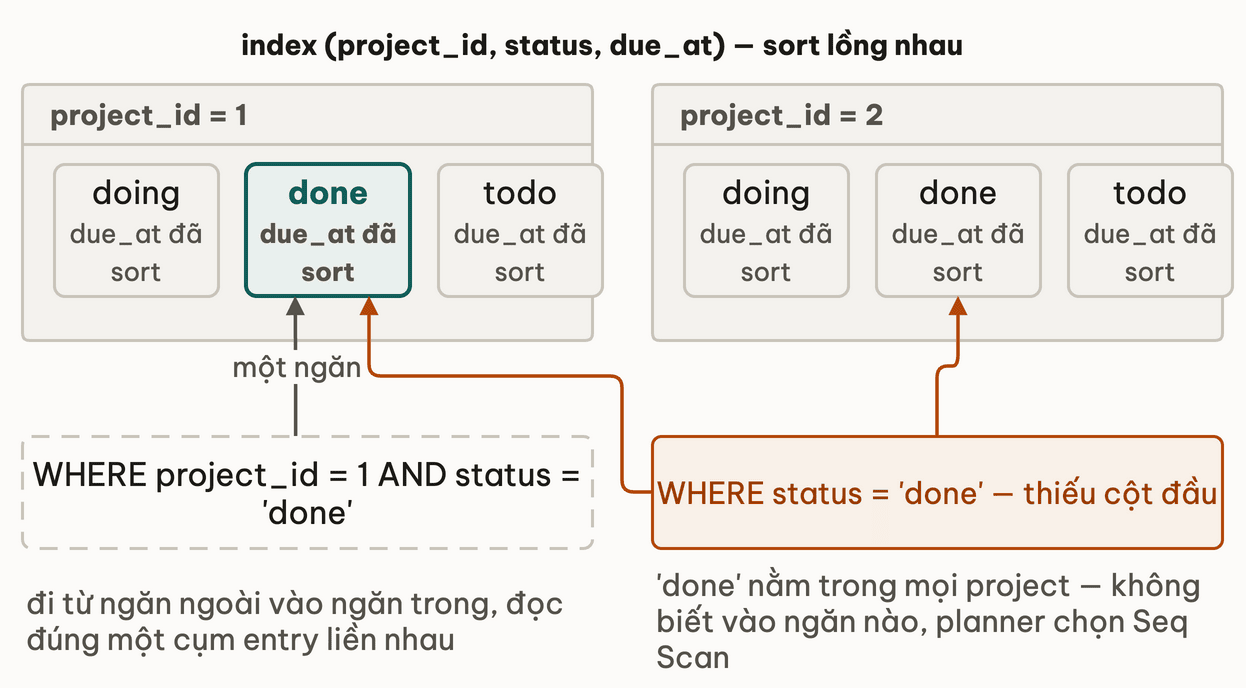
Có project_id = 1 thì cây đi tới subtree project 1, trong đó tìm status = 'done', trong đó range scan due_at; mỗi bước thu hẹp phạm vi đọc. Bỏ project_id thì status = 'done' nằm rải trong mọi project, đọc toàn index cũng tốn như Seq Scan nên planner chọn Seq Scan luôn.
-- INDEX (project_id, status, due_at)

-- DUNG INDEX:
WHERE project_id = 5                                   -- prefix cot 1
WHERE project_id = 5 AND status = 'done'               -- prefix cot 1+2
WHERE project_id = 5 AND status = 'done' AND due_at > '2026-05-01'  -- ca 3

-- KHONG DUNG INDEX (thieu cot 1):
WHERE status = 'done'
WHERE due_at > '2026-05-01'
WHERE status = 'done' AND due_at > '2026-05-01'
Quy tắc: WHERE phải có cột 1, có thể thêm cột 2, cột 3 liên tục. Planner tự sắp lại điều kiện theo đúng thứ tự cột index, bất kể bạn viết WHERE theo thứ tự nào.
3. Equality trước, range sau
| Pattern | Thứ tự cột tốt nhất |
|---|---|
Toàn equality a=X AND b=Y AND c=Z | Mọi thứ tự đều navigate thẳng tới điểm |
Equality + range a=X AND b BETWEEN Y AND Z | (a, b): equality trước, range sau |
Nhiều range a BETWEEN … AND b BETWEEN … | Chỉ range đầu tiên dùng được index |
Cột range "ngắt" khả năng navigate: từ cột range trở đi B-tree chỉ còn quét một dải, các cột phía sau không thu hẹp thêm được nữa.
-- TOT: equality truoc, range sau
CREATE INDEX ON tasks(status, due_at);
SELECT * FROM tasks WHERE status = 'done' AND due_at > '2026-05-01';
-- Plan: Index Scan -- toi subtree status='done', range scan due_at trong do

-- KEM: range truoc, equality sau
CREATE INDEX ON tasks(due_at, status);
SELECT * FROM tasks WHERE status = 'done' AND due_at > '2026-05-01';
-- Plan: Index Scan (range due_at) + Filter (status='done')
-- Doc moi row co due_at > moc, roi moi loai theo status
4. INCLUDE — Index Only Scan
Composite index chỉ chứa các cột sort. SELECT cần thêm cột ngoài index thì mỗi row match là một lần fetch heap ngẫu nhiên, plan là Index Scan thay vì Index Only Scan.
-- Khong INCLUDE: Index Scan -> heap fetch cho id, title
CREATE INDEX ON tasks(status, due_at);
SELECT id, title FROM tasks WHERE status = 'done' AND due_at > '2026-05-01';

-- Co INCLUDE: Index Only Scan (khi visibility map cho phep)
CREATE INDEX ON tasks(status, due_at) INCLUDE (id, title);
SELECT id, title FROM tasks WHERE status = 'done' AND due_at > '2026-05-01';
Cột INCLUDE (PG 11+) được lưu ở leaf nhưng không tham gia sort, nên không dùng được trong WHERE và không làm cây phức tạp hơn. Giá phải trả là index to hơn; đổi lại read query bỏ qua random heap I/O, đáng nhất khi heap lớn hoặc cold.
Thử ngẫmidx_tasks_dashboard vừa thêm INCLUDE (id, title) để đạt Index Only Scan. Nếu dashboard sau này cần thêm cột assignee_name vào SELECT, cột đó nên vào sort key hay vào INCLUDE?
5. Chọn thứ tự cột theo workload
Query: WHERE col1 = X [AND col2 OP Y [AND col3 OP Z]]

1. Equality truoc range
2. Trong nhom equality: cardinality cao truoc (thu hep som)
3. Range o cuoi sort key
4. ORDER BY trung cot range cuoi -> planner bo Sort
5. Cot chi co trong SELECT -> INCLUDE
Áp cho dashboard TaskFlow:
SELECT id, title FROM tasks
WHERE assignee_id = 5
  AND status IN ('todo', 'doing')
  AND due_at BETWEEN now() AND now() + INTERVAL '3 days'
ORDER BY due_at;

-- Equality: assignee_id (cardinality cao: nhieu assignee)
--           status      (cardinality thap: 4 gia tri)
-- Range:    due_at, trung ORDER BY -> bo Sort
-- SELECT:   id, title -> INCLUDE
CREATE INDEX idx_tasks_dashboard
  ON tasks(assignee_id, status, due_at)
  INCLUDE (id, title);
assignee_id trước status vì nhiều assignee hơn 4 giá trị status, thu hẹp subtree sớm hơn; status trước due_at vì equality trước range; due_at cuối và trùng ORDER BY nên không cần Sort node; id, title vào INCLUDE để Index Only Scan.
6. Pitfall — một index không phục vụ được hai prefix khác nhau
Q1 WHERE assignee_id = 5 AND status = 'done' và Q2 WHERE status = 'done' cần prefix khác nhau; index (assignee_id, status) phục vụ Q1 còn Q2 thiếu cột 1 nên Seq Scan.
-- Option A: doi thu tu -> ca Q1 lan Q2 deu dung duoc
CREATE INDEX ON tasks(status, assignee_id);
-- Q1 narrow theo status truoc roi assignee_id; Q2 prefix status

-- Option B: tach 2 index
CREATE INDEX ON tasks(assignee_id, status);  -- Q1
CREATE INDEX ON tasks(status);               -- Q2
Option A tiết kiệm một index nhưng Q1 mất lợi thế thu hẹp theo assignee_id sớm (status chỉ có 4 giá trị nên subtree còn lớn). Option B tối ưu cả hai nhưng mỗi INSERT/UPDATE phải ghi thêm một B-tree, chi phí đã đo ở bài B-tree internals.
Thử ngẫmteam chọn đổi index sang (status, assignee_id) để phục vụ cả Q1 lẫn Q2. Query chỉ lọc riêng assignee_id, không kèm status, giờ chạy plan nào?
7. Index skip scan — PG 18 mới có
Skip scan là cơ chế DB tự liệt kê các giá trị distinct của cột 1 rồi chạy scan cho từng giá trị, để query thiếu cột 1 vẫn dùng được index. Oracle có từ lâu, MySQL từ 8.0.13, PostgreSQL B-tree có từ bản 18 (2025). Trên PG 17 trở về trước, thiếu cột 1 nghĩa là Seq Scan hoặc phải tạo index riêng:
-- PG <= 17: workaround cho WHERE status = X khi index chinh la (assignee_id, status)
CREATE INDEX ON tasks(status);
Cách khác là "loose index scan" bằng recursive CTE (kỹ thuật ở Subquery, CTE, LATERAL), nhưng phức tạp và thường chậm hơn một index riêng.
8. Deep Dive — Composite index
- PostgreSQL Documentation — "Multicolumn Indexes" — luật chính thức về leftmost prefix và khi nào planner chọn dùng composite index.
- PostgreSQL Documentation — "Index-Only Scans and Covering Indexes" — cú pháp INCLUDE, yêu cầu visibility map, vì sao Heap Fetches đôi khi khác 0.
- Use The Index, Luke — "Concatenated Indexes" — hình vẽ tốt nhất cho leftmost prefix; đọc trước PG docs.
- Use The Index, Luke — "Searching for Ranges" — vì sao cột range phải đứng cuối, với ví dụ đo số leaf phải quét.
9. Liên hệ các bài khác
- B-tree internals — cây bên dưới composite index và chi phí ghi thêm mỗi index; đọc lại khi cân nhắc tách hai index.
- GIN/BRIN/partial/expression — bài kế: partial index và expression index đều kết hợp được với INCLUDE và thứ tự cột ở đây.
- Mini-challenge dashboard tuning — đo thật 4 version index từ đơn cột tới composite + INCLUDE + partial bằng
EXPLAIN (ANALYZE, BUFFERS). - Scan strategies — Index Scan, Index Only Scan, Bitmap Heap Scan khác nhau thế nào trong output EXPLAIN; cần để đọc plan của bài này.
- B-tree & B+tree — leaf chain sort theo key ghép là lý do CTDL của leftmost prefix rule.
10. Tóm tắt
- Checklist khi thiết kế composite: liệt kê cột WHERE equality → cột range → ORDER BY → cột SELECT; ba nhóm đầu vào sort key theo đúng thứ tự đó, nhóm cuối vào INCLUDE.
- Thấy Seq Scan dù có composite index: kiểm tra WHERE có cột đầu tiên của index không trước khi nghi ngờ statistics.
- Plan có
Filter:ngay dưới Index Scan là dấu hiệu cột range đứng trước equality hoặc cột đó không nằm trong index. - Hai query prefix khác nhau: đổi thứ tự khi cột đầu mới có cardinality đủ cao, tách hai index khi bảng không quá write-heavy.
- PG 17 trở xuống không có skip scan: thiếu cột 1 là phải có index riêng; PG 18 mới tự xử lý được.
Bài tiếp theo rời B-tree để xem ba loại index còn lại: GIN cho JSONB, BRIN cho time-series, partial và expression cho subset và hàm.
11. Tự kiểm tra
- Q1Vì sao composite (a, b, c) không help WHERE c = X? Giải thích theo cơ chế B-tree navigation.
- Q2Phân biệt khi nào đặt equality column trước vs range column trước. Cho ví dụ TaskFlow cho mỗi trường hợp.
- Q3INCLUDE vs thêm column vào sort key. Khác biệt gì? Khi nào dùng cái nào?
- Q4Có 2 query thường xuyên: Q1 WHERE a=X AND b=Y, và Q2 WHERE b=Y riêng. Dùng 1 composite index hay 2 index riêng? Tradeoff?
- Q5ORDER BY due_at + composite index (assignee_id, status, due_at): planner skip sort. Cơ chế gì cho phép điều đó?
- Q6Cluster đang chạy PG 16. Query WHERE status = 'done' rất thường xuyên nhưng index chính là (assignee_id, status). Workaround tốt nhất là gì?
Bài tiếp theo: GIN/BRIN/partial/expression — chọn index theo data type và workload
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Bài này có giúp bạn hiểu bản chất không?
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Hỏi đáp về bài này
Chưa có câu hỏi
Có gì chưa rõ trong bài? Đặt câu hỏi đầu tiên — câu trả lời từ cộng đồng giúp bạn (và người sau).
Đặt câu hỏi đầu tiên