Parallel Stream: Khi Nào Nên Dùng và Cạm Bẫy Luồng Phổ Biến
Cơ chế ForkJoinPool, công thức Doug Lea NxQ > 10000, cạm bẫy starvation khi nghẽn I/O và nguyên tắc chọn giữa parallelStream với CompletableFuture.
TL;DR: parallelStream() tận dụng ForkJoinPool.commonPool()—một thread pool dùng chung toàn bộ JVM với thuật toán Work-stealing—để chia nhỏ luồng dữ liệu qua Spliterator và xử lý đa luồng. Tuy nhiên, việc gắn thêm .parallel() không đồng nghĩa với việc ứng dụng sẽ nhanh hơn. Để song song hóa đạt hiệu quả thực tế, hệ thống phải thỏa mãn công thức của Doug Lea: N × Q > 10,000 (với N là số lượng phần tử và Q là chi phí CPU trên từng phần tử). Việc sử dụng Parallel Stream cho các tác vụ I/O blocking là sai lầm nghiêm trọng vì sẽ làm cạn kiệt thread của toàn bộ ứng dụng JVM.
Sau khi đã làm quen với pipeline xử lý tại Stream Basics và kỹ thuật tổng hợp dữ liệu tại Collectors Deep Dive, bài học này sẽ giải mã công cụ nâng cao có độ rủi ro cao nhất trong Stream API: xử lý song song.
1. ForkJoinPool.commonPool vận hành bên dưới parallelStream ra sao?
Khi bạn gọi items.parallelStream(), Java không tạo ra một thread pool mới mà sử dụng ForkJoinPool.commonPool(). Đây là một singleton tĩnh được chia sẻ giữa tất cả các thành phần trong toàn bộ máy ảo JVM.
// Default parallelism of commonPool = Number of CPU Cores - 1
int parallelism = ForkJoinPool.commonPool().getParallelism();
System.out.println("Common pool worker threads: " + parallelism);
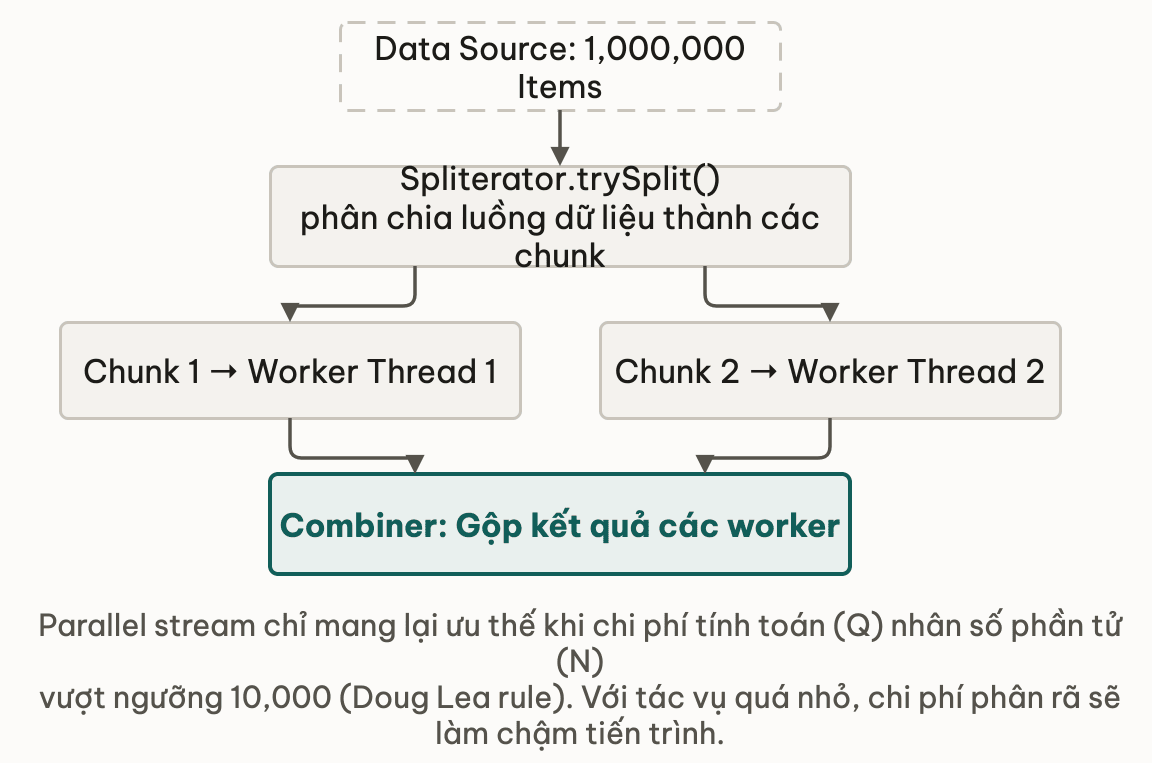
Chi phí vô hình (Overhead) của Parallel Stream
Mỗi lần khởi chạy một luồng song song, JVM phải trả phí tài nguyên cho:
- Phân chia tập dữ liệu thành các phần nhỏ qua
Spliterator.trySplit(). - Đẩy các task vào hàng đợi của
ForkJoinPoolvà kích hoạt cơ chế trộm việc (Work-stealing). - Chuyển đổi ngữ cảnh luồng (Thread Context Switch).
- Đồng bộ hóa và gộp kết quả qua hàm
combiner().
Nếu công việc thực sự chỉ mất vài microsecond, chi phí điều phối này sẽ lớn hơn thời gian chạy tuần tự, khiến mã nguồn chạy chậm hơn từ 40% đến 75% so với sequential stream!
2. Công thức Doug Lea N×Q giúp xác định thời điểm nên song song hóa thế nào?
Doug Lea (tác giả của ForkJoinPool và gói java.util.concurrent) đã đúc kết một quy tắc thực nghiệm nổi tiếng:
Song song hóa chỉ mang lại lợi thế khi: $N \times Q > 10,000$
- $N$: Tổng số lượng phần tử trong luồng dữ liệu.
- $Q$: Chi phí tính toán CPU trên mỗi phần tử (ước tính theo số chu kỳ CPU).
// Example 1: N = 500 records, lightweight arithmetic (Q ~ 5 cycles)
// N x Q = 2,500 < 10,000 -> DO NOT USE PARALLEL
double sum = items.stream().mapToDouble(LibraryItem::getFine).sum();

// Example 2: N = 5,000,000 numbers, heavy prime checks (Q ~ 2,000 cycles)
// N x Q = 10,000,000,000 >> 10,000 -> PARALLEL HIGHLY BENEFICIAL (Speedup 5x-7x)
long primeCount = LongStream.range(2, 5_000_000)
    .parallel()
    .filter(PrimeChecker::isPrime)
    .count();
3. Cạm bẫy trạng thái dùng chung (Shared Mutable State) và Race Condition là gì?
Lỗi phổ biến nhất khi chuyển sang parallelStream là đọc/ghi vào một biến trạng thái không an toàn luồng bên ngoài scope:
// DANGEROUS BUG: Race condition on ArrayList
List<String> collectedBarcodes = new ArrayList<>();

items.parallelStream()
    .filter(LibraryItem::isOverdue)
    .forEach(item -> collectedBarcodes.add(item.getBarcode()));
    // Causes silent data loss or ArrayIndexOutOfBoundsException!

// IDIOMATIC: Use Collectors for complete thread-safety
List<String> safeBarcodes = items.parallelStream()
    .filter(LibraryItem::isOverdue)
    .map(LibraryItem::getBarcode)
    .toList(); // Fully thread-safe, zero shared mutable state
4. Thứ tự phần tử trong forEach và forEachOrdered bị ảnh hưởng ra sao?
Trong luồng song song, các worker thread hoàn thành việc tính toán theo thời gian bất định:
List<Integer> numbers = List.of(1, 2, 3, 4, 5);

// 1. forEach(): Non-deterministic order (e.g. 3, 1, 5, 2, 4)
numbers.parallelStream().forEach(System.out::print);

// 2. forEachOrdered(): Preserves 1, 2, 3, 4, 5 encounter order but slow
numbers.parallelStream().forEachOrdered(System.out::print);
[!WARNING]
forEachOrdered()buộc các thread phải xếp hàng chờ đợi để phát dữ liệu theo đúng thứ tự ban đầu, triệt tiêu gần như toàn bộ lợi thế của việc chạy song song. Nếu cần duy trì thứ tự encounter, hãy dùngcollect(Collectors.toList()).
5. Tại sao các tác vụ I/O blocking gây nghẽn toàn bộ JVM khi chạy parallelStream?
Vì ForkJoinPool.commonPool() là singleton dùng chung cho toàn máy ảo, việc thực thi các tác vụ chặn I/O (gọi HTTP API, đọc file từ ổ đĩa mạng, truy vấn JDBC) sẽ phong tỏa toàn bộ các worker thread:

// DEADLY ANTI-PATTERN: Blocks all commonPool worker threads
urls.parallelStream()
    .map(url -> fetchHttp(url)) // Each call blocks for 300ms
    .toList();
// Consequence: Other REST endpoints, Spring @Async tasks,
// and CompletableFutures across the entire JVM are starved!
Giải pháp: Đối với các tác vụ I/O-bound, hãy dùng CompletableFuture với một ExecutorService riêng biệt hoặc tận dụng Virtual Threads trong Java 21+:
// Completely isolates I/O with Virtual Threads (Java 21+)
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    List<CompletableFuture<String>> futures = urls.stream()
        .map(url -> CompletableFuture.supplyAsync(() -> fetchHttp(url), executor))
        .toList();
    List<String> results = futures.stream().map(CompletableFuture::join).toList();
}
6. Cấu trúc dữ liệu nguồn ảnh hưởng đến hiệu quả phân chia Spliterator thế nào?
Khả năng phân rã của nguồn dữ liệu qua Spliterator.trySplit() quyết định trực tiếp đến hiệu năng của Parallel Stream:
| Cấu trúc nguồn | Độ phức tạp chia tách | Hiệu quả CPU Cache | Đánh giá cho Parallel |
|---|---|---|---|
ArrayList / int[] | $O(1)$ (tính trung vị chỉ số) | Tuyệt vời (bộ nhớ liên tục) | ⭐ Tối ưu nhất |
HashSet / TreeSet | $O(1)$ đến $O(\log N)$ | Trung bình | Tương đối tốt |
LinkedList | $O(N)$ (phải duyệt tuần tự $N/2$) | Tệ (phân mảnh bộ nhớ) | ❌ Kém, thường chậm hơn tuần tự |
Stream.iterate() | Không thể chia trước ($O(N)$) | Tệ (phụ thuộc giá trị trước) | ❌ Không nên dùng |
Files.lines() | $O(N)$ (phải scan ký tự xuống dòng) | Kém (nghẽn I/O) | ❌ Không nên dùng |
7. Đâu là những cạm bẫy phổ biến khi dùng Parallel Stream?
❌ Cạm bẫy 1: Tự tiện thêm .parallel() mà không đo đạc bằng JMH
Song song hóa có chi phí điều phối cố định. Không thêm .parallel() vào mã nguồn nếu chưa có số liệu đo lường thực tế chứng minh hiệu năng được cải thiện.
❌ Cạm bẫy 2: Dùng sorted() trên tập dữ liệu song song khổng lồ
Thao tác sorted() là một chướng ngại đồng bộ hóa (Barrier). Tất cả các thread phải hoàn tất và đổ dữ liệu về một mảng đệm chung trước khi merge sort chạy, làm mất tính chất streaming của luồng dữ liệu.
❌ Cạm bẫy 3: Sử dụng phép toán không có tính chất kết hợp trong reduce Như đã phân tích ở bài 04, các phép toán không kết hợp (như phép trừ) sẽ cho ra kết quả sai lệch và ngẫu nhiên khi chạy song song.
8. Tóm tắt các điểm cốt lõi
parallelStreamdùng chungForkJoinPool.commonPool()của toàn JVM; chỉ dùng cho tác vụ CPU-bound.- Áp dụng công thức Doug Lea: Chỉ song song hóa khi $N \times Q > 10,000$.
- Tránh xa Shared Mutable State; sử dụng
collect()hoặc các phép toán thuần chức năng (Pure Functions). - Không bao giờ chạy tác vụ chặn I/O trên Parallel Stream; thay thế bằng
CompletableFuturehoặc Virtual Threads.
9. Câu hỏi tự kiểm tra (Self-Check)
- Q1Tại sao việc gọi fetchHttp() bên trong một parallelStream() lại có thể làm tê liệt toàn bộ ứng dụng Spring Boot?
- Q2Tại sao ArrayList lại phân chia dữ liệu cho parallelStream hiệu quả hơn rất nhiều so với LinkedList?
- Q3Công thức Doug Lea N x Q > 10,000 có ý nghĩa thực tiễn như thế nào trong thiết kế phần mềm?
- Q4Đoạn mã sau có lỗi gì: List<Item> result = new ArrayList<>(); items.parallelStream().forEach(result::add);?
- Q5Tại sao forEachOrdered() lại làm giảm đáng kể hiệu năng khi chạy trên một Parallel Stream?
Bài tiếp theo: Immutability và Functional Style: Thiết Kế Code Java Không Có Bất Ngờ
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Collectors Deep Dive: toMap, groupingBy và Custom Collector
Bài tiếpImmutability và Functional Style: Thiết Kế Code Java Không Có Bất Ngờ
Lộ trình Junior Java Backend Developer
Chặng 6/21 · Lambda & Stream API — bài 9/12 của chặng
Thảo luận & góp ý
Hỏi đáp về bài này