List và Queue — ArrayList, ArrayDeque, PriorityQueue
Memory layout của ArrayList vs LinkedList, circular buffer của ArrayDeque và binary heap của PriorityQueue trong quản lý ấn phẩm thư viện.
TL;DR: Big-O lý thuyết không phản ánh toàn bộ hiệu năng thực tế vì nó bỏ qua chi phí truy cập bộ nhớ phần cứng. ArrayList lưu trữ các tham chiếu trên mảng liền kề (contiguous array), tối ưu hóa CPU cache lines (L1/L2/L3) và tận dụng vectorization của System.arraycopy, khiến nó vượt trội hơn LinkedList trong hầu hết mọi tác vụ. Khi cần xử lý hàng đợi FIFO/LIFO hai đầu, ArrayDeque với circular buffer là giải pháp chuẩn mực thay thế hoàn toàn LinkedList và class cổ Stack. Với hàng đợi ưu tiên, PriorityQueue quản lý heap nhị phân trên mảng với chi phí O(log n).
1. Cây phả hệ Collection phân chia trách nhiệm List, Queue và Deque như thế nào?
Trong thư viện java.util, interface Iterable là gốc rễ cho phép duyệt qua iterator(). Interface Collection kế thừa từ Iterable, cung cấp các phương thức thao tác tập hợp cơ bản như add(), remove(), size(), contains(). Dưới Collection, ba nhánh interface chính định hình hành vi lưu trữ:
List: Tập hợp có thứ tự tuần tự (ordered sequence), định danh theo chỉ số (zero-based index) và cho phép các phần tử trùng lặp (ArrayList,LinkedList).Queue: Hàng đợi xử lý theo nguyên tắc FIFO (First-In, First-Out), nạp ở cuối và lấy ra ở đầu (PriorityQueue,ArrayDeque).Deque(Double-Ended Queue): Hàng đợi hai đầu, hỗ trợ thêm và bớt phần tử ở cả hai đầu với chi phíO(1), có thể đóng vai trò cả FIFO Queue lẫn LIFO Stack (ArrayDeque).
Sự khác biệt cốt lõi không nằm ở hợp đồng interface, mà nằm ở Memory Layout bên dưới của từng lớp cài đặt thực tế.
2. Vì sao cơ chế Contiguous Memory giúp ArrayList vượt trội về hiệu năng?
ArrayList quản lý danh mục ấn phẩm bằng một mảng đối tượng Java thuần túy:
public class ArrayList<E> {
    private Object[] elementData; // Internal contiguous array
    private int size;             // Actual element count (<= elementData.length)
    private static final int DEFAULT_CAPACITY = 10;
}
Lợi thế bộ nhớ đệm CPU Cache Line
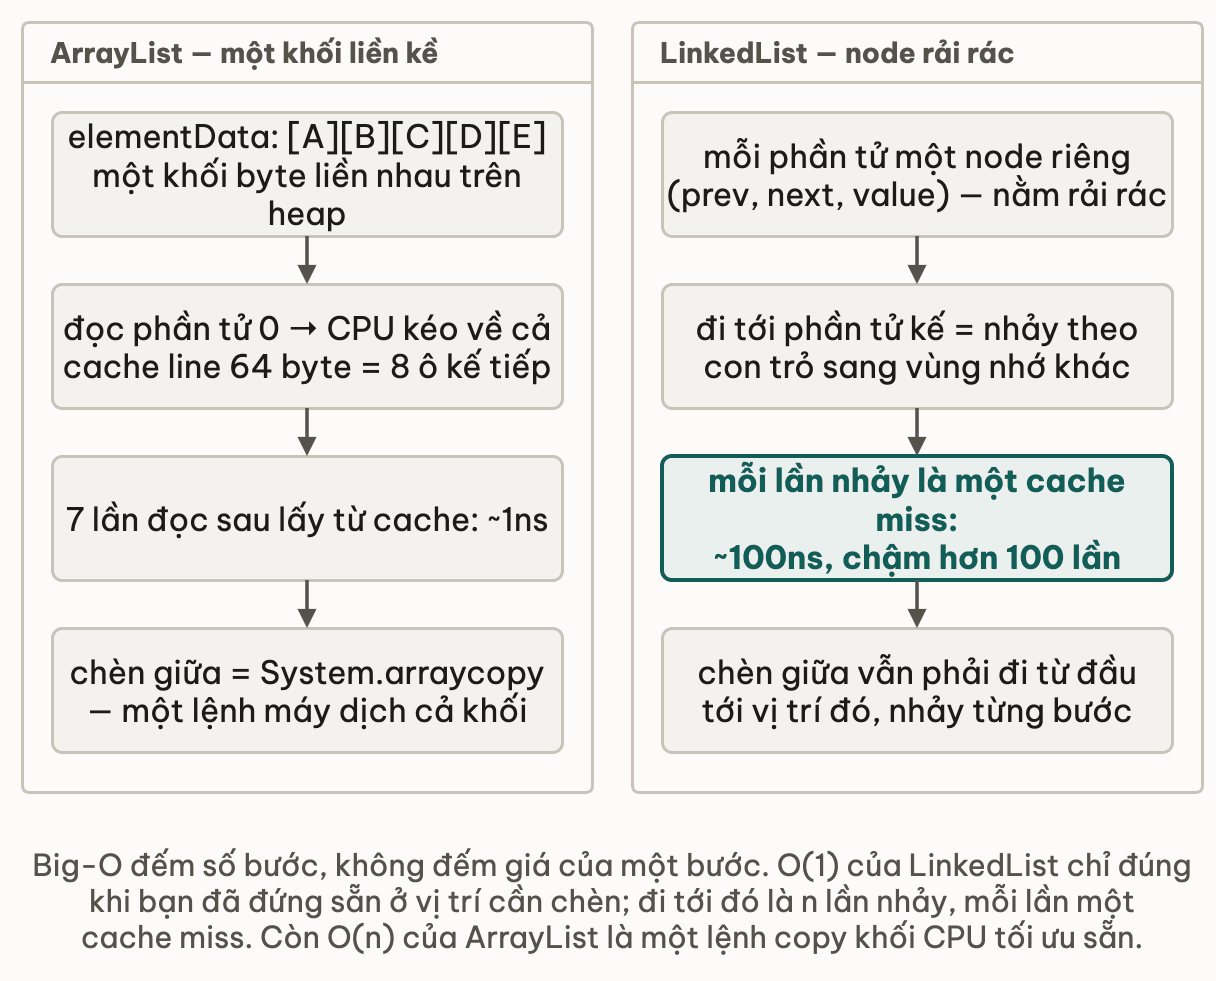
Khi bạn đọc phần tử đầu tiên elementData[0], CPU không chỉ nạp một địa chỉ tham chiếu 8-byte duy nhất. Thay vào đó, bộ điều khiển bộ nhớ (memory controller) nạp nguyên một Cache Line 64 byte từ RAM vào L1/L2 Cache của CPU.
Trong một cache line chứa trọn vẹn 8 tham chiếu ấn phẩm liền kề. Khi vòng lặp tiếp tục đọc từ elementData[1] đến elementData[7], dữ liệu đã nằm sẵn trong CPU L1 Cache với độ trễ chỉ ~1ns, thay vì phải truy vấn RAM vật lý với độ trễ ~100ns. Nhờ tính cục bộ không gian (Spatial Locality), thao tác duyệt ArrayList nhanh gấp 10-50 lần so với cấu trúc danh sách liên kết.
Cơ chế tự tăng kích thước 1.5x (Growth Factor)
Khi mảng chứa đầy, ArrayList tự động mở rộng thông qua hàm grow():
private void grow() {
    int oldCapacity = elementData.length;
    int newCapacity = oldCapacity + (oldCapacity >> 1); // 1.5x growth
    elementData = Arrays.copyOf(elementData, newCapacity);
}
Tại sao các kỹ sư Java chọn hệ số 1.5 thay vì nhân đôi 2.0 như Vector hay HashMap?
- Tái sử dụng vùng nhớ cũ: Với hệ số 2x, dung lượng mảng mới luôn lớn hơn tổng dung lượng tất cả các mảng cũ trước đó cộng lại (
2^n > 2^n - 1). Heap allocator không bao giờ có thể cấp phát mảng mới vào khoảng trống vừa được giải phóng từ mảng cũ. Ngược lại, hệ số1.5nhỏ hơn tỷ lệ vàng $\phi \approx 1.618$, cho phép sau một vài lần mở rộng, các vùng nhớ cũ được gom lại đủ chỗ cho mảng kế tiếp, giảm thiểu triệt để hiện tượng phân mảnh heap (Memory Fragmentation). - Tối ưu dịch bit: Phép tính
oldCapacity >> 1được thực thi trực tiếp trên thanh ghi CPU chỉ trong một chu kỳ xung nhịp (clock cycle), hoàn toàn không tốn chi phí của lệnh chia số nguyên.
Sức mạnh từ JIT Intrinsic System.arraycopy
Khi chèn hoặc xóa phần tử ở giữa danh sách ArrayList, thao tác dịch chuyển mảng có độ phức tạp lý thuyết là $O(n)$:
public void add(int index, E element) {
    if (size == elementData.length) grow();
    System.arraycopy(elementData, index, elementData, index + 1, size - index);
    elementData[index] = element;
    size++;
}
Tuy nhiên, System.arraycopy là một HotSpot JIT Intrinsic. Trình biên dịch C2 ánh xạ trực tiếp lệnh này thành các chỉ thị assembly tối ưu cấp phần cứng (memmove với tập lệnh AVX2/AVX-512 hoặc REP MOVSQ trên kiến trúc x86-64), cho phép sao chép hàng gigabyte dữ liệu mỗi giây mà không sinh thêm bất kỳ đối tượng rác nào cho Garbage Collector.
3. Bản chất phân tán bộ nhớ của LinkedList gây ra những tổn thất gì?
LinkedList lưu trữ từng ấn phẩm dưới dạng một đối tượng Node liên kết đôi:
public class LinkedList<E> {
    Node<E> first;
    Node<E> last;
    int size;

    private static class Node<E> {
        E item;
        Node<E> next;
        Node<E> prev;
    }
}
Chi phí bộ nhớ và áp lực GC
Trên JVM 64-bit có bật Compressed OOPs, mỗi đối tượng Node tiêu tốn:
- 12–16 byte Object Header.
- 3 trường tham chiếu (
item,next,prev), mỗi trường 8 byte. - Tổng cộng: ~40 byte cho mỗi phần tử, gấp 5 lần so với 8 byte của một ô trong
ArrayList.
Nếu lưu 1.000.000 ấn phẩm, LinkedList sinh ra đúng 1.000.000 đối tượng Node rải rác trên khắp heap, làm GC phải quét và phân tích đồ thị tham chiếu khổng lồ này khi dọn rác.
Thảm họa Cache Miss khi duyệt danh sách
Mỗi node được cấp phát ngẫu nhiên trên Heap. Khi thực hiện node = node.next, CPU phải nhảy tới một địa chỉ bộ nhớ hoàn toàn xa lạ, gây ra hiện tượng CPU Cache Miss liên tục. Thao tác truy cập theo chỉ số get(index) buộc phải duyệt từ đầu hoặc cuối:
Node<E> node(int index) {
    if (index < (size >> 1)) {
        Node<E> x = first;
        for (int i = 0; i < index; i++) x = x.next;
        return x;
    } else {
        Node<E> x = last;
        for (int i = size - 1; i > index; i--) x = x.prev;
        return x;
    }
}
Vòng lặp for (int i = 0; i < list.size(); i++) list.get(i) trên LinkedList có độ phức tạp $O(n^2)$ và biến việc đọc danh sách thành cơn ác mộng về hiệu năng.
4. ArrayDeque vận hành cơ chế Circular Buffer tối ưu ra sao?
Khi cần xây dựng hàng đợi xử lý mượn trả ấn phẩm tại quầy lưu thông, lập trình viên thường nghĩ đến LinkedList. Tuy nhiên, ArrayDeque mới là lựa chọn chuẩn mực.
public class ArrayDeque<E> {
    Object[] elements; // Circular array
    int head;          // First element index
    int tail;          // Next empty index
}
ArrayDeque sử dụng một mảng một chiều làm vòng tròn bộ đệm (Circular Buffer):
- Thêm vào cuối (
addLast/offerLast):elements[tail] = e; tail = (tail + 1) % length;— $O(1)$. - Thêm vào đầu (
addFirst/offerFirst):head = (head - 1 + length) % length; elements[head] = e;— $O(1)$. - Thao tác lấy phần tử ở cả hai đầu không bao giờ phải dịch chuyển mảng, không cấp phát thêm node trung gian.
// Example: Processing circulation tickets
Deque<CirculationTicket> queue = new ArrayDeque<>();
queue.offerLast(new CirculationTicket("TICKET-101")); // Enqueue
queue.offerLast(new CirculationTicket("TICKET-102"));
CirculationTicket current = queue.pollFirst();        // Dequeue (FIFO)
| Tiêu chí | Stack (Legacy) | LinkedList | ArrayDeque |
|---|---|---|---|
| Độ phức tạp Push/Pop | $O(1)$ | $O(1)$ | $O(1)$ |
| Cấu trúc bộ nhớ | Mảng kế thừa Vector | Nút liên kết rời rạc (~40B/node) | Mảng vòng tròn liền kề |
| CPU Cache Locality | Tốt | Rất kém | Xuất sắc |
| Đồng bộ hóa (Thread Safety) | Bị ép synchronized vô ích | Không đồng bộ | Không đồng bộ (Hiệu năng cao) |
| Khuyến nghị hiện đại | ❌ Cấm dùng | ❌ Tránh dùng | ✅ Khuyên dùng mặc định |
5. PriorityQueue sắp xếp thứ tự ưu tiên bằng Binary Heap như thế nào?
Trong nghiệp vụ đặt trước ấn phẩm (BookReservation), các nhà nghiên cứu hoặc sinh viên ưu tiên cần được phục vụ trước độc giả vãng lai. PriorityQueue giải quyết bài toán này thông qua cấu trúc Min-Heap nhị phân được làm phẳng trên một mảng tuần tự.
Mối quan hệ toán học cha-con trên mảng
Thay vì tốn con trỏ cây phức tạp, vị trí các nút được tính toán trực tiếp:
- Nút cha ở chỉ số $i$ có con trái tại $2i + 1$ và con phải tại $2i + 2$.
- Nút con ở chỉ số $c$ có nút cha tại $\lfloor (c - 1) / 2 \rfloor$.
Min-Heap Array: [1, 3, 2, 5, 4, 7, 6]

                         Index 0
                         [  1  ] (Phần tử ưu tiên cao nhất tại Root)
                       /         \
             Index 1                 Index 2
             [  3  ]                 [  2  ]
            /       \               /       \
       Index 3     Index 4     Index 5     Index 6
       [  5  ]     [  4  ]     [  7  ]     [  6  ]
Thao tác thêm và lấy phần tử
offer(e)($O(\log n)$): Thêm phần tử vào cuối mảng, sau đó thực hiện sift-up (so sánh với cha và hoán đổi vị trí dần lên trên nếu nhỏ hơn cha).poll()($O(\log n)$): Lấy phần tử gốc tạiarray[0], đưa phần tử cuối cùng của mảng lên thay thế ở vị trí0, sau đó thực hiện sift-down (so sánh với con nhỏ nhất và hoán đổi dần xuống dưới).peek()($O(1)$): Đọc trực tiếp phần tử gốcarray[0].
record ReservationRequest(String patronId, int priorityTier) {}

// PriorityQueue with comparator: Lower priorityTier number means higher priority
PriorityQueue<ReservationRequest> queue = new PriorityQueue<>(
    Comparator.comparingInt(ReservationRequest::priorityTier)
);

queue.offer(new ReservationRequest("STUDENT-01", 3));
queue.offer(new ReservationRequest("PROFESSOR-09", 1));

ReservationRequest next = queue.poll(); // Next is PROFESSOR-09
6. Đâu là những sai lầm phổ biến khi lựa chọn List và Queue?
❌ Sai lầm 1: Chọn LinkedList vì nghĩ chèn giữa nhanh hơn ArrayList
Trên thực tế, để chèn vào vị trí $k$, LinkedList phải duyệt $O(k)$ bước qua hàng loạt cache miss, trong khi ArrayList chỉ mất $O(1)$ tìm kiếm và một thao tác SIMD memmove cực nhanh. Ngoại trừ việc chèn liên tục ở đầu mảng (index = 0), ArrayList luôn nhanh hơn.
❌ Sai lầm 2: Sử dụng class Stack thay cho ArrayDeque
Class java.util.Stack là di sản từ Java 1.0, kế thừa từ Vector và bọc mọi phương thức bằng synchronized. Trong ứng dụng đơn luồng hoặc luồng cục bộ, overhead đồng bộ hóa làm chậm hệ thống không cần thiết. Hãy luôn dùng Deque<E> stack = new ArrayDeque<>().
❌ Sai lầm 3: Không định sẵn dung lượng ban đầu cho ArrayList khi biết trước kích thước
Nếu bạn cần tải 100.000 ấn phẩm từ cơ sở dữ liệu vào danh sách:
// Anti-pattern: Triggers repeated resizing and array copying
List<LibraryItem> catalog = new ArrayList<>();

// Recommended: Pre-allocate capacity to eliminate resizing overhead
List<LibraryItem> catalog = new ArrayList<>(100_000);
7. Đọc thêm từ tài liệu Oracle và các liên kết liên quan
- Oracle JavaDoc: ArrayList: Chi tiết cơ chế
grow(),trimToSize()vàensureCapacity(). - Oracle JavaDoc: ArrayDeque: Cấu trúc mảng vòng tròn không giới hạn.
- Oracle JavaDoc: PriorityQueue: Đặc tả heap nhị phân.
- Bài 03 — Wildcard và PECS: Nguyên tắc thiết kế Generic Collection linh hoạt.
- Khoá Thuật toán: Cấu trúc Danh sách liên kết: Phân tích chi tiết CPU Cache Locality và Memory Fragmentation.
8. Tóm tắt các điểm mấu chốt
ArrayListlà lựa chọn mặc định cho danh sách nhờ mảng nhớ liền kề, tối ưu CPU cache và hỗ trợ truy cập ngẫu nhiên $O(1)$.- Hệ số tăng trưởng 1.5x của
ArrayListđạt điểm cân bằng giữa tiết kiệm bộ nhớ và tái sử dụng vùng trống trên Heap. LinkedListtạo áp lực nặng nề lên Garbage Collector và chịu chi phí Cache Miss lớn do cấu trúc node rời rạc.ArrayDequesử dụng circular buffer, vượt trội hơn cảLinkedListlẫnStacklegacy khi cần hàng đợi FIFO hoặc LIFO.PriorityQueuelưu trữ min-heap trực tiếp trên mảng, cho phép lấy phần tử ưu tiên cao nhất trong $O(1)$ và cập nhật trong $O(\log n)$.
9. Câu hỏi tự kiểm tra
- Q1Vì sao duyệt for-each trên ArrayList nhanh hơn gấp nhiều lần so với LinkedList cùng kích thước dù cả hai đều có độ phức tạp O(n)?
- Q2Trong cấu trúc dữ liệu PriorityQueue lưu trữ trên mảng, nút con trái và nút con phải của nút ở chỉ số index = 4 nằm tại vị trí nào?
- Q3Tại sao nên dùng Deque<E> stack = new ArrayDeque<>() thay vì class java.util.Stack của Java?
- Q4Hệ số tăng trưởng 1.5x của ArrayList mang lại lợi thế gì về quản lý bộ nhớ so với hệ số 2.0x?
- Q5Thao tác add(0, element) ở đầu danh sách có phải là lý do hợp lý duy nhất để cân nhắc LinkedList thay cho ArrayList?
Bài tiếp theo: Map và Set — HashMap, TreeMap, HashSet
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Wildcard `? extends`, `? super` — PECS rule
Bài tiếpMap và Set — HashMap, TreeMap, HashSet
Lộ trình Junior Java Backend Developer
Chặng 5/21 · Generics & Collections — bài 4/10 của chặng
Ôn phỏng vấn
Bài này trả lời được các câu phỏng vấn sau — tự trả lời thử trước khi mở đáp án.
Thảo luận & góp ý
Hỏi đáp về bài này