Module 3 — Tổng kết & cheat sheet
Recap partitioning: range vs hash, consistent hashing & rebalancing, secondary index (local/global), request routing. Cheat sheet, glossary, self-assessment.
TL;DR: Module 3 chia dữ liệu lớn ra nhiều node: range vs hash (phân bố đều ↔ range query), consistent hashing (co giãn ít xáo trộn) + rebalancing, secondary index (local ghi-rẻ vs global đọc-rẻ), và request routing (tìm node, dẫn thẳng tới bài toán consensus). Trang này để bookmark trước khi vào transaction phân tán.
Đã đi qua những gì
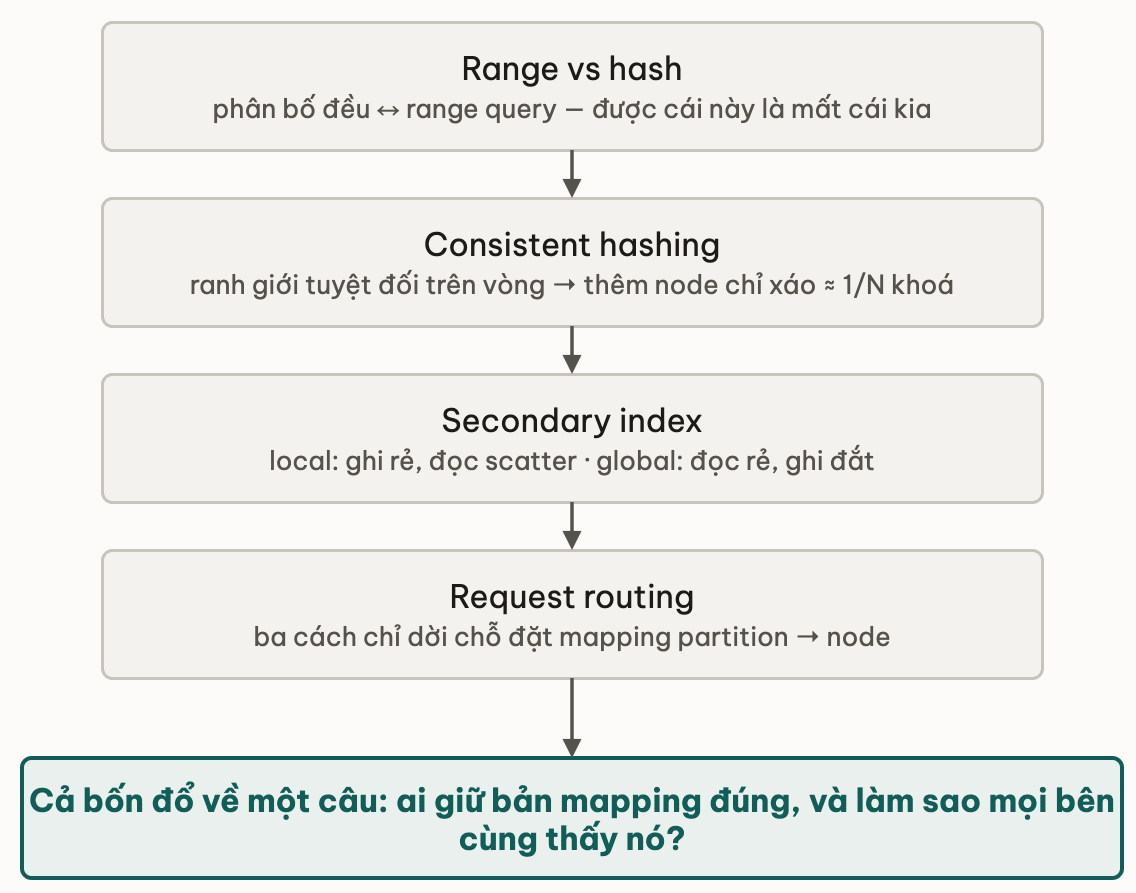
Bắt đầu bằng cách chia: key-range giữ thứ tự (range query nhanh, dễ hot spot), hash phân bố đều (chống hot spot, mất range query) — và skew của celebrity key mà cả hai đều dính. Rồi consistent hashing giải bài toán co giãn: thay hash mod N (đổi N xáo gần hết) bằng vòng hash + virtual node, chỉ di chuyển phần kề; rebalancing thực dụng dùng số partition cố định. Rồi secondary index — cùng đánh đổi đọc/ghi nhưng áp lên index: local (ghi rẻ, đọc scatter) vs global (đọc rẻ, ghi đắt + async). Khép bằng request routing: ba cách tìm node, và phần khó là giữ mapping đồng bộ — chính là consensus.
🗺️ Cheat sheet
| Khái niệm | Cốt lõi | Pitfall |
|---|---|---|
| Key-range partition | Dải khoá liền → range query nhanh | Hot spot (khoá timestamp dồn 1 partition) |
| Hash partition | Băm → phân bố đều | Mất range query (scatter/gather) |
| Skew / celebrity key | 1 khoá nóng → 1 partition | Hash không chia nhỏ được 1 khoá |
hash mod N | Đơn giản khi N cố định | Đổi N → xáo gần hết dữ liệu |
| Consistent hashing | Vòng hash, chỉ di chuyển phần kề | — |
| Virtual node | 1 node = nhiều điểm vòng → cân tải | — |
| Rebalancing | Số partition cố định, gán lại | Tự động tức thì → domino |
| Local index | Index theo document | Đọc scatter mọi partition |
| Global index | Index theo term | Ghi nhiều partition, async → index lag |
| Request routing | Client/tier/node-forward | Cache mapping không làm mới |
📖 Glossary module
| Thuật ngữ | Định nghĩa 1 câu |
|---|---|
| Partition / shard | Một phần dữ liệu đặt trên một node. |
| Key-range partition | Chia theo dải khoá liền nhau, giữ thứ tự. |
| Hash partition | Chia theo giá trị hash của khoá, phân bố đều. |
| Hot spot | Một partition nhận phần lớn tải. |
| Skew | Tải/dữ liệu lệch giữa các partition. |
| Consistent hashing | Node + khoá trên một vòng; thêm/bớt chỉ di chuyển phần kề. |
| Virtual node | Một node vật lý = nhiều điểm trên vòng. |
| Rebalancing | Di chuyển partition khi thêm/bớt node. |
| Local (document) index | Mỗi partition index dữ liệu của mình. |
| Global (term) index | Index phân mảnh theo giá trị trường phụ. |
| Scatter/gather | Gửi truy vấn mọi partition rồi gộp. |
| Request routing | Định tuyến request tới node giữ khoá. |
| Dịch vụ coordination | Dịch vụ giữ mapping và thông báo thay đổi. |
⚠️ Pitfall tổng hợp
- Chọn cách chia theo thói quen: hash mọi thứ (range query chậm) hoặc range theo timestamp (hot spot ghi). Đúng: chọn theo pattern truy vấn chi phối.
- Hash để cứu celebrity key: vô ích, một khoá vẫn về một partition. Đúng: thêm hậu tố tách riêng khoá nóng.
hash mod N: thêm node xáo gần hết. Đúng: consistent hashing / số partition cố định.- Rebalancing tự động tức thì: nhầm chậm với chết → domino. Đúng: có kiểm soát + giới hạn băng thông.
- Đọc global index ngay sau ghi: index async chưa khớp. Đúng: biết index có thể trễ.
- Cache mapping không làm mới: request đi nhầm node sau co giãn. Đúng: nguồn sự thật + watch/notify.
✅ Self-assessment
Bạn đã đạt module này nếu trả lời được:
- So sánh được partition theo key-range vs hash và giải thích hot spot, skew
- Nếu chưa: đọc lại bài 01 mục 2-4.
- Giải thích được consistent hashing và rebalancing khi thêm/bớt node
- Nếu chưa: đọc lại bài 02 mục 2-5.
- Thiết kế được secondary-index partitioning (local vs global) và request routing
- Nếu chưa: đọc lại bài 03 mục 2-3 và bài 04 mục 2-3.
🚀 What's next
Replication (Module 2) và partitioning (Module 3) cho ta dữ liệu trên nhiều node. Câu hỏi kế: khi một thao tác cần thay đổi nhiều mảnh dữ liệu ở nhiều node cùng lúc, hoặc-tất-cả-hoặc-không, thì sao? Đó là Module 4 — Transaction phân tán: 2PC, anomaly & serializability, và vì sao thường nên tránh distributed transaction.
📚 Tài liệu mở rộng
- Sách: Designing Data-Intensive Applications (Kleppmann) — Chương 6 "Partitioning".
- Paper: Karger et al., "Consistent Hashing and Random Trees" (1997) — gốc consistent hashing.
- Paper: DeCandia et al., "Dynamo" (2007) — consistent hashing + virtual node trong hệ thật.
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Request routing — tìm đúng node giữ dữ liệu
Bài tiếp Transaction phân tánModule 4 — Transaction phân tán: tổng quan
Thảo luận & góp ý
Hỏi đáp về bài này