Module 1 — Tổng kết & cheat sheet
Recap batch: triết lý Unix, MapReduce (shuffle = sort phân tán), ba kiểu join, dataflow DAG. Cheat sheet, glossary, self-assessment trước khi vào Module Stream.
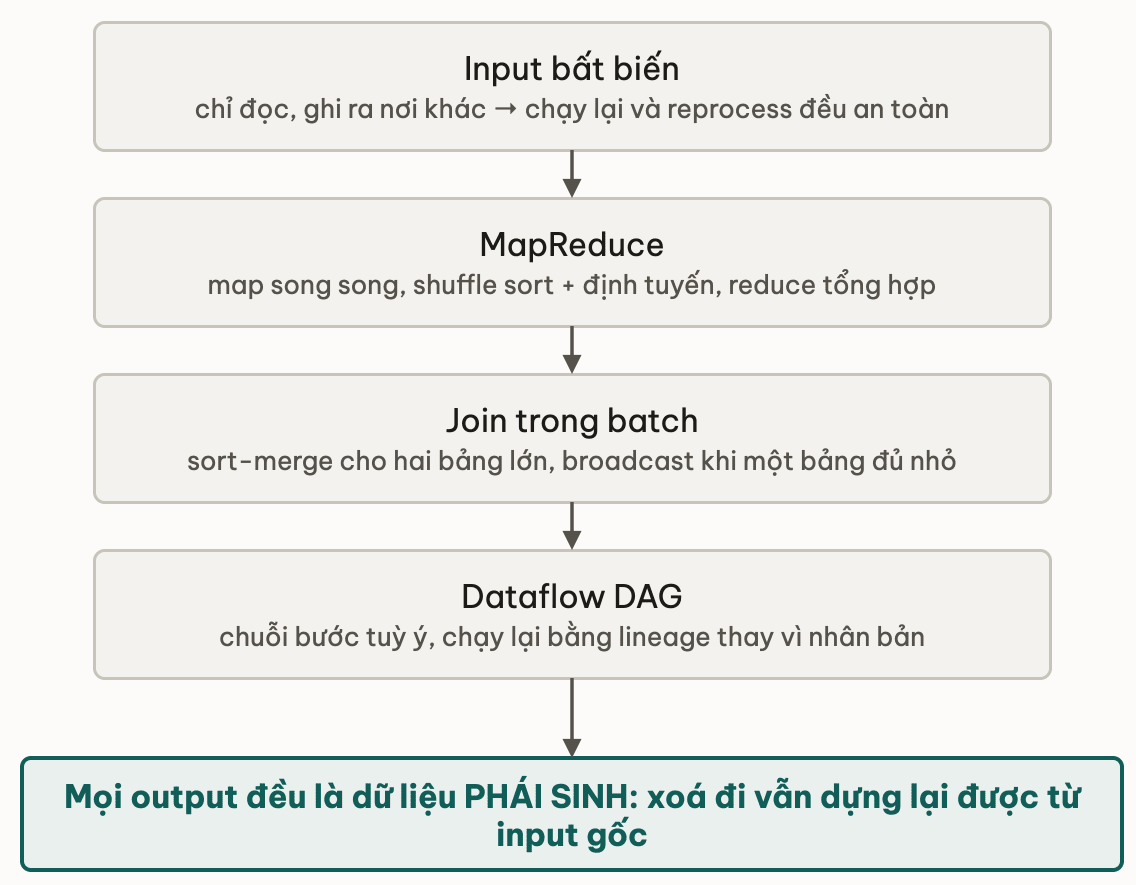
TL;DR: Module 1 dựng batch từ một kỷ luật (input bất biến → output phái sinh → tính lại được) lên tới engine phân tán. MapReduce = map → shuffle → reduce, với shuffle là external sort phân tán. Join có ba chiến lược chọn theo kích thước và skew (sort-merge / broadcast / partitioned hash). Dataflow engine (Spark) nhanh hơn nhờ pipelining (ít disk I/O, không phải RAM) và chịu lỗi bằng lineage recompute. Trang này để bookmark trước khi vào Module 2 — stream.
Đã đi qua những gì
Bắt đầu bằng tư duy batch: job đọc một khối input bất biến, ghi kết quả phái sinh ra nơi khác — nhờ đó chạy lại an toàn (idempotent), reprocess được cả lịch sử, và tách source-of-truth khỏi derived data. Mẫu pipe của Unix (cut | sort | uniq) là hình mẫu thu nhỏ. MapReduce phóng mẫu đó ra nghìn máy: map phát key-value, shuffle gom + sort mọi value cùng key về một reducer (đây là external sort phân tán, chiếm ~1/3 thời gian job), reduce tổng hợp. Join trong batch quy về ba chiến lược — sort-merge (bảng lớn, chịu skew), broadcast hash (bảng nhỏ vừa RAM), partitioned hash (chia đối xứng, sợ hot key). Dataflow engine thay khuôn hai-pha cứng bằng DAG, pipeline các bước trong một stage và chỉ ghi đĩa ở ranh giới shuffle — đó (không phải cache RAM) là lý do Spark thắng Hadoop 3× ở benchmark 100 TB; khi node chết, nó recompute từ lineage thay vì giữ replica.
🗺️ Cheat sheet
| Khái niệm | Khi nào dùng / bản chất | Pitfall |
|---|---|---|
| Input bất biến | Mọi batch job — chỉ đọc nguồn, ghi ra nơi khác | Ghi đè input → mất reprocess + hỏng một nửa |
| Idempotent | Chạy lại ra cùng kết quả | Chỉ đúng khi output bị vứt/ghi đè toàn phần, không append |
| Map | Biến đổi/lọc từng dòng thành key-value | Emit thừa field → nghẽn shuffle |
| Shuffle | Gom + sort value cùng key về một reducer | Coi là "miễn phí" — thực ra ~1/3 job time |
| Reduce | Tổng hợp danh sách value mỗi key | Hot key skew → straggler |
| Sort-merge join | Hai bảng lớn, có skew | Tốn hai lần sort |
| Broadcast hash join | Bảng nhỏ thật (≤ vài chục MB) | Bảng "nhỏ" GB-scale → OOM (limit 8 GB) |
| Partitioned hash join | Hai bảng chia cùng hàm hash | Hot key phá đối xứng partition |
| Materialization | Ghi đĩa sau mỗi bước (Hadoop) | N bước = 2N disk I/O |
| Pipelining | Stream qua operator trong 1 stage (Spark) | — (lý do Spark nhanh, KHÔNG phải RAM) |
| Lineage recompute | Chịu lỗi bằng tính lại từ nguồn | Lineage dài → cần checkpoint() |
📖 Glossary module
| Thuật ngữ | Định nghĩa 1 câu | Nguồn |
|---|---|---|
| Batch / bounded input | Xử lý một khối dữ liệu hữu hạn, chạy rồi dừng | DDIA Ch10 |
| Derived data | Bản dẫn xuất luôn dựng lại được từ source of truth | DDIA Ch10 |
| MapReduce | Mô hình map → shuffle → reduce chạy phân tán | Dean & Ghemawat 2004 |
| Shuffle | Pha gom + sort key-value giữa map và reduce | MapReduce paper |
| Skew / hot key | Một key có quá nhiều record, dồn về một reducer | DDIA Ch10 |
| Salting | Thêm suffix ngẫu nhiên vào hot key để trải reducer | — |
| DAG | Đồ thị có hướng không chu trình biểu diễn dataflow | Spark/Tez |
| Lineage | "Công thức" tính một RDD, dùng để recompute | Zaharia 2012 |
⚠️ Pitfall tổng hợp
- Ghi đè input → mất reprocess, mất idempotent. Luôn ghi output ra nơi tách biệt.
- Coi shuffle miễn phí → emit thừa field, nghẽn mạng. Chỉ emit field cần.
- Reducer skew →
hash(key)chia đều số key khác nhau, KHÔNG chia đều số record. Fix: salting. - Broadcast bảng "nhỏ" GB-scale → OOM. Broadcast chỉ an toàn vài chục MB.
- Tưởng Spark nhanh vì RAM → thực ra vì pipelining (ít disk I/O). Cả hai chạy trên disk trong benchmark.
✅ Self-assessment
Bạn đã đạt module này nếu trả lời được:
- Giải thích được vì sao input bất biến sinh output phái sinh khiến batch job idempotent và tính lại được.
- Nếu chưa: đọc lại bài 01 mục "Vì sao input phải bất biến".
- Giải thích được mô hình MapReduce (map → shuffle → reduce) và nhận ra shuffle chính là external sort phân tán.
- Nếu chưa: đọc lại bài 02 mục "Phase Shuffle".
- So sánh được sort-merge join, broadcast hash join, partitioned hash join theo kích thước dữ liệu và skew.
- Nếu chưa: đọc lại bài 03 bảng so sánh ba chiến lược.
- Thiết kế được một batch pipeline nhiều bước và lập luận materialization vs pipelining cùng fault tolerance bằng tính lại.
- Nếu chưa: làm lại bài 05 (lab) và đọc bài 04.
🚀 What's next
Module 2 — Xử lý stream — lật sang mặt còn lại: khi input là một dòng vô tận thay vì khối cố định. Kỷ luật bất biến ở đây biến thành log sự kiện chỉ append (Kafka), và "chạy lại từ nguồn" biến thành "phát lại log". Nhiều ý tưởng batch được tái dùng ở tầng thời gian thực.
📚 Tài liệu mở rộng
- Paper: MapReduce — Dean & Ghemawat (OSDI 2004); Resilient Distributed Datasets — Zaharia et al. (NSDI 2012).
- Sách: Designing Data-Intensive Applications (Kleppmann), Chương 10 — Batch Processing.
- Benchmark: Spark Daytona GraySort 2014.
Bài tiếp theo: Module 2 — Xử lý stream: tổng quan
Bài này có giúp bạn hiểu bản chất không?
Bài này đáng gửi cho bạn học cùng?
Copy link đã gắn nguồn — dán group, chat, hoặc LinkedIn.
Lab — thiết kế batch pipeline top-sản-phẩm nhiều bước
Bài tiếp Xử lý stream (stream processing)Module 2 — Xử lý stream: tổng quan
Thảo luận & góp ý
Hỏi đáp về bài này